

Outsourcing adnotacji danych w 2026 r.: Jak mierzyć jakość adnotacji przed podjęciem decyzji
Większość zespołów nie zaczyna szukać outsourcingu adnotacji danych z własnej woli. Zaczynają, ponieważ wewnętrzny program pilotażowy zadziałał – czterdzieści tysięcy obrazów, trzy
Najlepsza alternatywa dla MTurka w 2026 roku: Dlaczego zespoły AI wybierają Shaip
Przez 21 lat domyślną odpowiedzią na pytanie „potrzebujemy ludzi, żeby to otagowali” był rynek społecznościowy. Ten domyślny trend zakończył się wraz z zamknięciem Amazon Mechanical Turk.
Shaip rozszerza swój katalog danych wizji komputerowej o nowe zestawy danych obrazowych i wideo
Większość projektów z zakresu wizji komputerowej nie zatrzymuje się na modelu. Zatrzymują się na danych. Zespoły mają architekturę, moc obliczeniową i inżynierów, a potem…

Adnotacja pozycji dłoni do zręcznej manipulacji robotem
Adnotacja pozycji dłoni to proces oznaczania sposobu poruszania się dłoni i jej palców w każdej klatce filmu, dzięki czemu roboty mogą

Szacowanie pozycji dla fizycznej sztucznej inteligencji: jak dane Keypoint i ruchu uczą roboty poruszać się
Oszacowanie pozycji to zadanie komputerowe polegające na lokalizowaniu kluczowych punktów ciała – stawów i punktów orientacyjnych twarzy – i łączeniu ich w szkielet opisujący sposób
Czym jest sztuczna inteligencja konwersacyjna? Jak działa i dlaczego warstwa danych decyduje o wszystkim
Odkryj, jak konwersacyjna sztuczna inteligencja zmienia branże dzięki spersonalizowanym interakcjom. Sprawdź naszą infografikę.
Kiedy syntetyczne dane mają sens w komputerowym przetwarzaniu obrazu (a kiedy przynoszą odwrotny skutek)
Pobierz infografiki Każdy zespół zajmujący się komputerowym przetwarzaniem obrazu w końcu napotyka ten sam problem: dane, których najbardziej potrzebujesz, to te, których nie możesz uzyskać. Niemalże
Dlaczego dane dotyczące mowy wielojęzycznej są kluczowe dla globalnej sztucznej inteligencji
Pobierz infografiki Twój model głosu działa doskonale w wersji demonstracyjnej. Następnie spotyka prawdziwego użytkownika — kogoś ze szkockim akcentem, zamawiającego w języku hinglish,
Przyszłość adnotacji danych 2026 i później
Automatyzacja nie zastąpi adnotatorów. Da im większe uprawnienia. Adnotacja danych ewoluuje od „etykietowania” w kierunku operacji na danych opartych na sztucznej inteligencji: wyższy osąd, silniejsze zarządzanie, ściślejsza ocena.
OCR w 2026 r.: jak sztuczna inteligencja przekształca dowolny dokument w dane, na podstawie których może działać
OCR to technologia, która umożliwia maszynom odczytywanie drukowanego tekstu i obrazów. Jest często używany w aplikacjach biznesowych, takich jak digitalizacja dokumentów w celu przechowywania lub przetwarzania, oraz w zastosowaniach konsumenckich, takich jak skanowanie pokwitowań w celu zwrotu kosztów.
Co to jest NLP? Jak to działa, korzyści, wyzwania, przykłady
Odkryj naszą infografikę NLP: Dowiedz się, jak to działa, poznaj korzyści, wyzwania, rozwój rynku, przypadki użycia i przyszłe trendy w przetwarzaniu języka naturalnego.
Dane syntetyczne a rzeczywiste dla robotyki: które kupić do swojego fizycznego projektu AI
W przypadku fizycznej sztucznej inteligencji wąskim gardłem rzadko jest model – są nim dane. Polityka robota, która działa bezbłędnie w wersji demonstracyjnej, a potem się zatrzymuje.
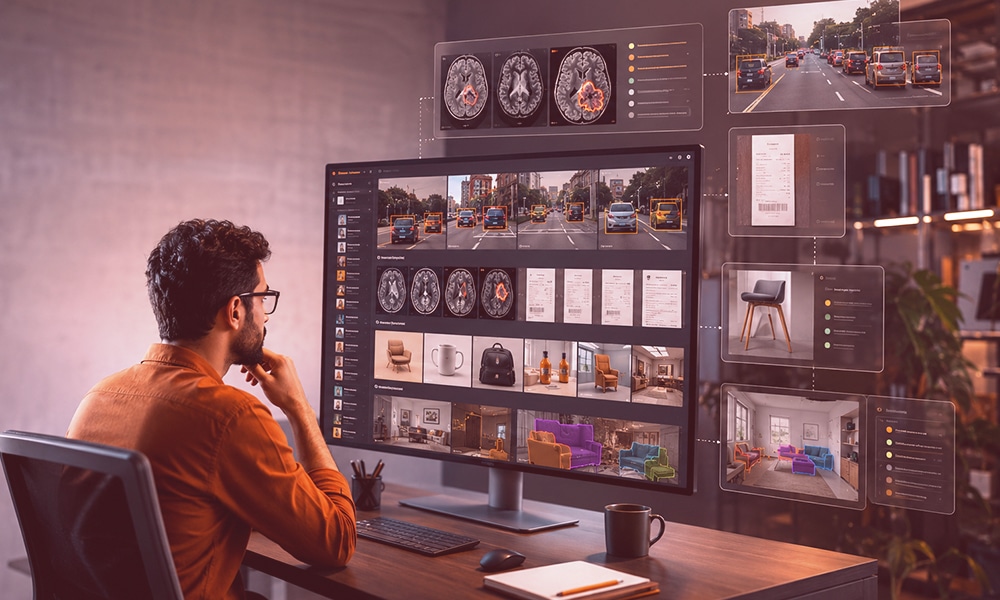
22 bezpłatnych zestawów danych obrazów do komputerowego widzenia, które zwiększą efektywność Twojego projektu [aktualizacja 2026]
Model widzenia komputerowego jest tak ostry, jak obrazy, na których go trenujesz. Podaj mu czysty, dobrze oznaczony zestaw, a nauczy się…
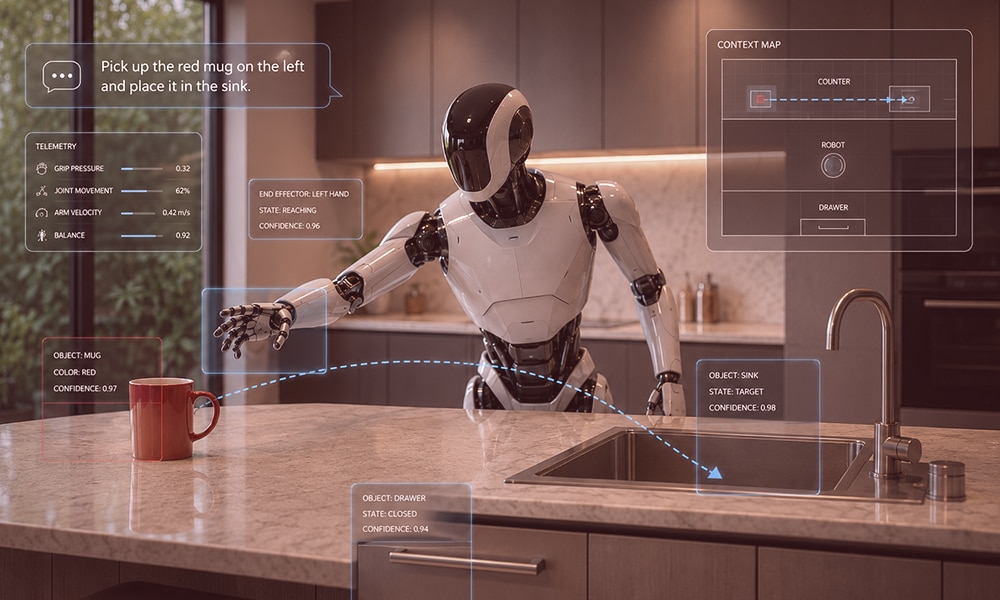
Dane multimodalne dla robotów humanoidalnych: wizja, język, działanie, telemetria i kontekst
Poproś humanoidalnego robota, aby „podniósł czerwony kubek po lewej stronie i umieścił go w zlewie”, a będzie musiał wlać do niego ogromną ilość wody.
Czym jest rozpoznawanie głosu: dlaczego go potrzebujesz, przypadki użycia, przykłady i zalety
Rozpoznawanie głosu to technologia, która identyfikuje i uwierzytelnia osobę na podstawie unikalnych cech jej głosu, podczas gdy jej bliskim odpowiednikiem jest rozpoznawanie mowy,
Przygotowanie danych AI do ustawy UE o sztucznej inteligencji: lista kontrolna w prostym języku
Kiedy firmy natrafiają na unijną ustawę o sztucznej inteligencji, zwykle nie jest to sprytny model sztucznej inteligencji, który je zaskakuje, lecz dokumenty związane z ustawą.

Ocena LLM z ekspertami dziedzinowymi: kompletny przewodnik dla zespołów korporacyjnych
Jeśli Twoja firma zaczęła korzystać z narzędzi AI generujących tekst — chatbotów, programów do podsumowania dokumentów, asystentów ds. polityki lub botów obsługi klienta — prawdopodobnie

Przepisy UE i Wielkiej Brytanii dotyczące sztucznej inteligencji: proste porównanie
Dwa największe rynki świata znajdują się w niewielkiej odległości od siebie i obrały niemal przeciwne ścieżki w kwestii sztucznej inteligencji. Unia Europejska napisała jedną wielką

Terminy wynikające z ustawy UE o sztucznej inteligencji z 2026 r.: prosty przewodnik po tym, co się właśnie zmieniło
Ustawa UE o sztucznej inteligencji to obszerny europejski zbiór przepisów dotyczących sztucznej inteligencji. Jak większość obszernych zbiorów przepisów, nie wchodzi on w życie od razu – różne przepisy

Jak dane dotyczące szkolenia robotów i zestawy danych manipulacyjnych napędzają robotykę w świecie rzeczywistym w 2026 r.
Większość modeli robotycznych działa bez zarzutu w wersji demonstracyjnej, ale rozpada się podczas wdrożenia. Przyczyną prawie nigdy nie jest architektura – to dane.

Strategia danych szkoleniowych robotów: teleoperacja kontra symulacja kontra ludzkie wideo dla wcielonej sztucznej inteligencji
Stworzenie polityki robotów, która działa w realnym świecie, nie jest już problemem komputerowym – to problem danych. Zespoły zajmujące się ucieleśnioną sztuczną inteligencją mają trzy

Zestaw danych fizycznej sztucznej inteligencji: demonstracje na ludziach, działania robotów, dane VLA i zadania długoterminowe
Większość zespołów zajmujących się sztuczną inteligencją wie, że potrzebuje danych. Niewielu wie, że potrzebuje ich stosu. Możliwości wdrożonego robota humanoidalnego, autonomicznego lub magazynowego
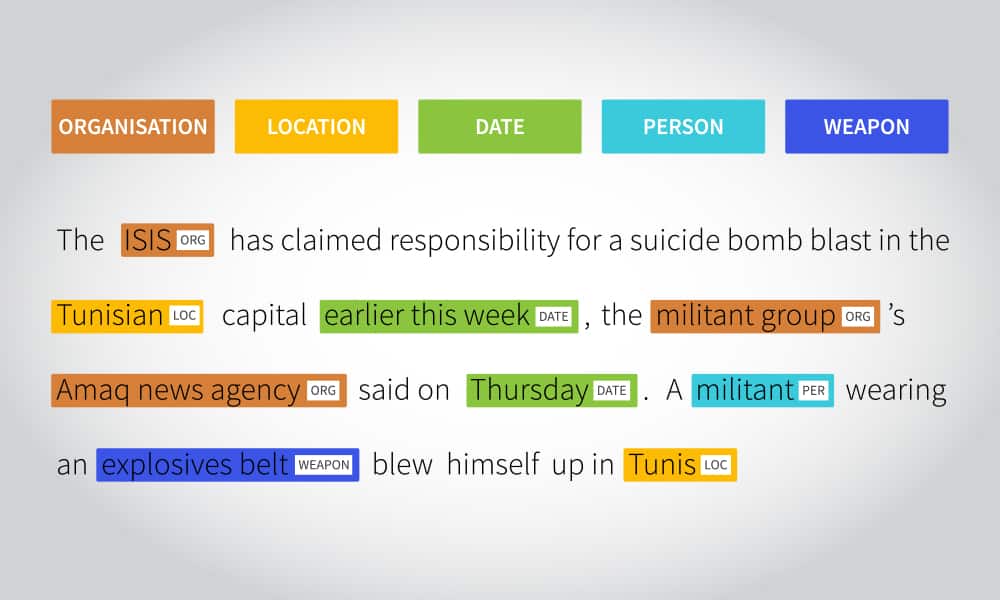
Co to jest rozpoznawanie jednostek nazwanych (NER) – przykłady, przypadki użycia, korzyści i wyzwania
Rozpoznawanie jednostek nazwanych identyfikuje i klasyfikuje zakresy tekstu do predefiniowanych kategorii. Rozpoznawanie jednostek nazwanych to technika przetwarzania języka naturalnego (NLP), która znajduje kluczowe fakty.

22 najlepsze zestawy danych OCR typu open source do trenowania modeli ML w 2026 r.
Optyczne rozpoznawanie znaków obsługuje teraz skanowanie paragonów, weryfikację tożsamości, automatyzację faktur, digitalizację archiwów historycznych i aplikacje do notatek oparte na rysiku. Przewiduje się, że rynek OCR osiągnie
