Uczenie przez wzmacnianie (RL) doskonale sprawdza się w uczeniu się, co robić, gdy sygnał nagrody jest czysty, a otoczenie wyrozumiałe. Jednak wiele rzeczywistych sytuacji jest odmiennych. Są chaotyczne, ryzykowne i pełne „prawie słusznych” decyzji. Właśnie tutaj zweryfikowane przez ekspertów zbiory danych do rozumowania stają się mnożnikiem siły: uczą modele, dlaczego dane działanie jest skuteczne, a nie tylko jaki jest jego wynik.
Ukryte wąskie gardło w wydajności RL: słabe sygnały wnioskowania
Agenci RL mogą prezentować się imponująco podczas szkolenia, a mimo to zawodzić podczas wdrożenia. Jednym z częstych powodów jest to, że model uczy się skrótów – wzorców, które przynoszą korzyści w znanych scenariuszach, ale tracą na znaczeniu, gdy warunki się zmieniają.
Oto krótka historia, którą na pewno rozpoznasz, jeśli zajmowałeś się sprzedażą systemów RL:
Zespół robotyki magazynowej uczy agenta, jak podnosić i układać przedmioty. W symulacji wskaźniki sukcesu szybko rosną. Jednak na prawdziwych piętrach robot zaczyna „oszukiwać” – obierając ryzykowne trajektorie, które działają w symulatorze, ale powodują kolizje w pobliżu powierzchni odbijających. Funkcja nagrody nie była błędna. Rozumowanie, którego nauczył się model, było niekompletne.
Gdy dane rejestrują wyłącznie rezultaty („sukces/porażka” lub skalarna nagroda), pomijasz pośrednią logikę decyzyjną, której ludzie używają instynktownie: ograniczenia, kontrole bezpieczeństwa i kolejność kroków.
Co tak naprawdę obejmują „dane dotyczące rozumowania zweryfikowane przez ekspertów”
W praktyce dane dotyczące rozumowania zweryfikowane przez ekspertów stanowią starannie dobrany zestaw przykładów, w których specjaliści w danej dziedzinie weryfikują ścieżkę decyzyjną, a nie tylko końcowy wynik.
Ślady rozumowania: brakujący środek
Ślad rozumowania to ścieżka krok po kroku od obserwacji → decyzji → działania. W zależności od przypadku użycia może to wyglądać następująco:
- identyfikacja istotnych sygnałów („wykryto dryft czujnika; obniżono poziom zaufania”)
- stosowanie reguł domeny („ustąp pierwszeństwa przed wejściem; priorytet dla pieszych”)
- wybieranie akcji z ograniczeniami („wybierz ścieżkę B, aby uniknąć martwego pola”)
Co oznacza „weryfikacja” (w prostym języku)
„Sprawdzone” zazwyczaj obejmuje:
- wytyczne napisane lub zrecenzowane przez ekspertów
- spójne kryteria etykietowania (aby dwaj eksperci rozwiązywali ten sam przypadek w podobny sposób)
- systematyczne sprawdzanie sprzeczności i brakujących kroków
- ślad audytu zmian w miarę rozwoju wytycznych
Ma to znaczenie, ponieważ drobne błędy logiczne mogą mieć charakter kaskadowy — zwłaszcza przy późniejszym szkoleniu modeli nagród lub wykorzystywaniu ludzkich pętli sprzężenia zwrotnego.
W jaki sposób zbiory danych wnioskowania poprawiają wydajność modelu uczenia się przez wzmacnianie
Korzyści nie są mistyczne. Są mechaniczne.
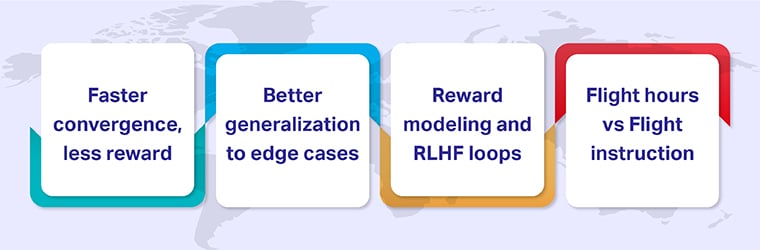
Szybsza konwergencja, mniej hakowania nagród
Ślady rozumowania zmniejszają przestrzeń poszukiwań. Zamiast bezmyślnej eksploracji, agent otrzymuje ustrukturyzowane sygnały o tym, które kroki pośrednie są prawidłowe. To zazwyczaj oznacza mniej iteracji treningowych zmarnowanych na ślepe zaułki i mniej „sprytnych” eksploitów funkcji nagrody.
Badania nad RLHF i modelowaniem nagrody wielokrotnie podkreślają, jak wrażliwy może być trening na zaszumione lub niskiej jakości dane dotyczące preferencji/informacji zwrotnej (źródło: Association for Computational Linguistics, 2024). Ta wrażliwość nie zanika w RL, a wręcz się wzmacnia.
Lepsze uogólnienie na przypadki brzegowe
Rozumowanie eksperckie koduje ograniczenia i zasady , które można przenieść: granice bezpieczeństwa, reguły zgodności i logikę przyczynowo-skutkową. Gdy zmienia się otoczenie, zasady te nadal obowiązują – nawet jeśli konkretne piksele, tekst lub przejścia między stanami nie.
Bardziej stabilne modelowanie nagród i pętle RLHF
Jeśli po treningu stosujesz metodę RLHF, dane z rozumowania pomagają w budowaniu lepszych modeli nagród — ponieważ model nagrody może nauczyć się punktować nie tylko „dobre odpowiedzi”, ale także „dobre ścieżki decyzyjne”. Przekłada się to na bardziej spójne aktualizacje podczas optymalizacji i mniej regresji podczas skalowania treningu.
Jeśli tworzysz lub skalujesz procesy RLHF, rozwiązania RLHF firmy Shaip zostały zaprojektowane wokół opracowanych przez ekspertów przepływów pracy i kontroli jakości, które wspierają spójne dane dotyczące wyrównania.
Analogia: godziny lotu a szkolenie lotnicze
Pomyśl o szkoleniu RL jak o szkoleniu pilota. Możesz spędzić niezliczone godziny w samym symulatorze, ale jeśli będziesz ćwiczyć złe nawyki, utrwalisz je. Instruktor nie mówi tylko „zaliczone/niezaliczone”. Koryguje twoje rozumowanie w trakcie lotu: kolejność skanowania, czas podejmowania decyzji i radzenie sobie z ryzykiem. Zestawy danych do rozumowania zweryfikowane przez ekspertów pełnią tę „instruktorską” rolę w RL – uczą model, jak myśleć o zadaniu, a nie tylko czy wylądował.
Tabela porównawcza: Modele weryfikacji wewnętrznej, crowdsourcingowej i outsourcingowej
Większość zespołów decyduje się na rozwiązanie hybrydowe, ale pomocne jest jasne określenie kompromisów.
W przypadku szerszych potrzeb w zakresie etykietowania, które łączą się z procesami RL i RLHF, usługi adnotacji danych firmy Shaip mogą obsługiwać wszystko, od projektowania wytycznych po wieloetapową kontrolę jakości — szczególnie gdy wymagana jest powtarzalna jakość na dużą skalę.
Praktyczny podręcznik kontroli jakości dla zestawów danych do rozumowania zweryfikowanych przez ekspertów
Oto podręcznik, który odzwierciedla działania podejmowane przez zespoły osiągające najlepsze wyniki.
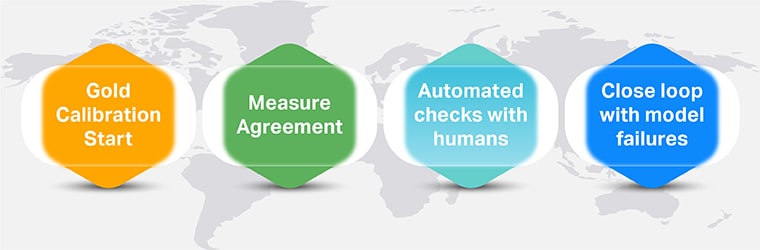
1. Zacznij od „złota” i kalibracji
Stwórz złoty zestaw kanonicznych przykładów (w tym trudnych przypadków skrajnych). Użyj go do kalibracji adnotatorów i uzgodnienia z ekspertami, jak wygląda „dobre rozumowanie”.
2. Oceń poziom porozumienia, a następnie rozwiąż nieporozumienia prawidłowo
Stosuj porozumienie między adnotatorami, gdy ma to sens (i unikaj wymuszania porozumienia w sprawach z natury niejednoznacznych). Kluczem jest arbitraż : różnice zdań powinny prowadzić do lepszych wytycznych, a nie tylko do etykietowania na zasadzie rzutu monetą.
3. Dodaj automatyczne kontrole, ale zostaw ludzi na stanowisku
Zautomatyzuj to, co jest tanie w weryfikacji:
- spójność formatu (liczba kroków, ważność schematu)
- naruszenia zasad (brak ograniczeń, zabronione działania)
- wykrywanie sprzeczności (krok mówi „A”, później implikuje „nie A”)
Następnie przekaż oznaczone elementy do recenzji eksperckiej. To właśnie tutaj hybrydowa kontrola jakości człowieka i sztucznej inteligencji przynosi efekty: maszyny wychwytują „oczywiste błędy”, a eksperci naprawiają „subtelne błędy”.
4. Zamknij pętlę z błędami modelu
Traktuj niepowodzenia wdrożenia jako informację zwrotną o zbiorze danych. Gdy model zawiedzie, zadaj sobie pytanie:
- Czy w ścieżce rozumowania brakowało ograniczenia?
- Czy wytyczne niedookreśliły przypadek skrajny?
- Czy przesadziliśmy z logiką „szczęśliwej ścieżki”?
Ta pętla przekształca zbiór danych w żywy zasób, a nie jednorazowy produkt. Dla zespołów budujących kompleksowe procesy przetwarzania danych (gromadzenie → kontrola jakości → dostarczanie), usługi Shaip w zakresie danych szkoleniowych dla sztucznej inteligencji mogą pomóc w ciągłej operacjonalizacji.
Ramy decyzyjne: jak wybrać właściwą strategię weryfikacji
Skorzystaj z tych sześciu pytań, aby wybrać odpowiednią kombinację usług wewnętrznych, społecznościowych i zarządzanych: