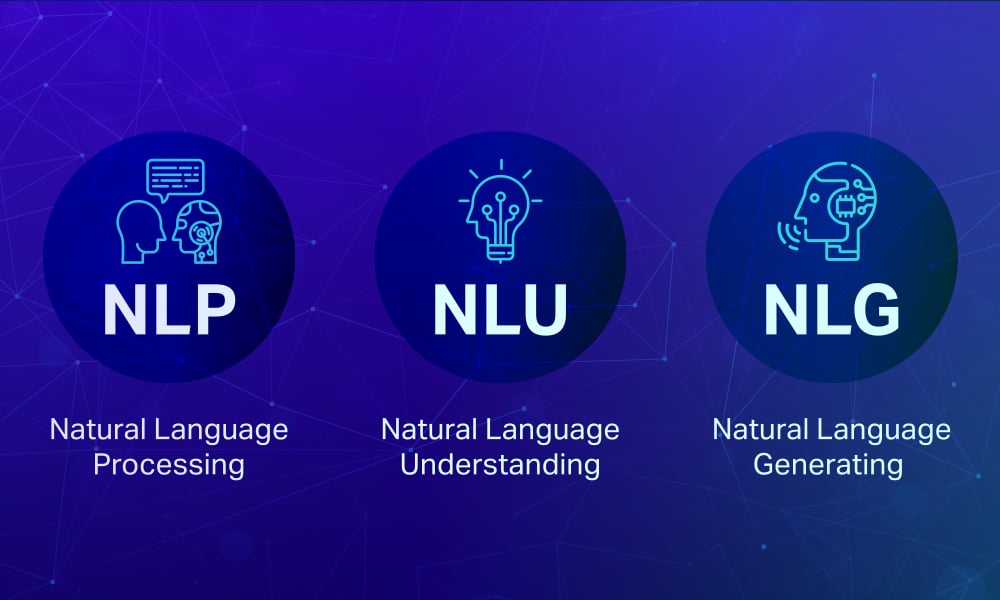
Wykorzystując przetwarzanie języka naturalnego (NLP) oparte na sztucznej inteligencji do wyodrębniania ustrukturyzowanych danych z obszernych, nieustrukturyzowanych elektronicznych systemów dokumentacji medycznej (EHR), naukowcy uzyskują dostęp do obszernych zbiorów danych klinicznych na potrzeby badań epidemiologicznych, ochrony zdrowia populacji i odkrywania spostrzeżeń medycznych, które w przeciwnym razie pozostałyby ukryte.
Wyodrębnianie szczegółów z niestrukturyzowanych danych EHR 101: przykładowy przepływ pracy
Proces pozyskiwania wniosków z nieustrukturyzowanych danych EHR jest systematyczny i musi być przeprowadzany indywidualnie dla każdego przypadku. Wymagania domeny, problemy i wyzwania typowe dla danej organizacji opieki zdrowotnej, aplikacje zorientowane na cel oraz związane z nimi implikacje są subiektywne i właśnie dlatego proces powinien uwzględniać również czynniki wpływające na Twoją organizację i jej wizję.
Jednak, jak każde podejście ma swój specyficzny przepływ pracy lub praktyczną zasadę, przygotowaliśmy również przewodnik, do którego możesz się odwołać.
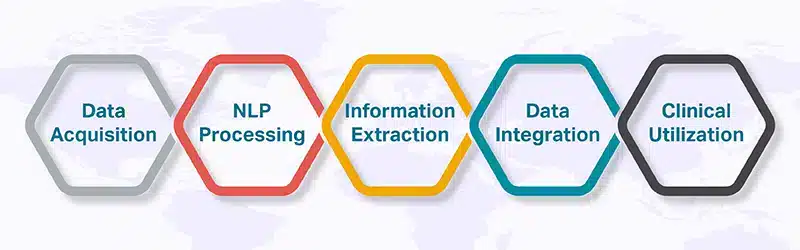
Akwizycja i wstępne przetwarzanie danych: Pierwszym krokiem jest kompilacja danych z EHR zawierających notatki kliniczne, listy leków, listy alergenów i raporty z zabiegów. Wstępne przetwarzanie w trybie sztucznej inteligencji obejmuje deidentyfikację, czyszczenie, normalizację i tokenizację w celu przygotowania danych w spójnych formatach (formaty tekstowe, ustrukturyzowane i nieustrukturyzowane).
Przetwarzanie NLP / Szkolenie modeli AI: Skompilowane dane są następnie wprowadzane do algorytmów NLP lub modeli AI w celu analizy danych tekstowych i identyfikacji kluczowych jednostek klinicznych, takich jak diagnozy, leki, alergie i procedury. Szkolenie w „trybie AI” obejmuje uczenie nadzorowane, czasami nienadzorowane lub półnadzorowane, z wykorzystaniem oznaczonych zbiorów danych.
Ekstrakcja informacji: W zależności od tego, czy Twój model korzysta ze strategii uczenia nadzorowanego czy nienadzorowanego (lub korzysta z hybrydowego trybu sztucznej inteligencji), wyodrębnia on istotne informacje o każdym obiekcie, w tym jego typ, datę, powiązane szczegóły, stopień ważności, dawkę itp.
Walidacja i nadzór kliniczny: Po wyodrębnieniu informacji przez model oparty na sztucznej inteligencji, muszą one zostać zweryfikowane przez pracowników służby zdrowia pod kątem dokładności klinicznej. Systemy z udziałem człowieka i pętle sprzężenia zwrotnego od ekspertów zapewniają niezawodność procesu.
Integracja i interoperacyjność danych: Ustrukturyzowane dane są następnie integrowane z systemem EHR lub innymi odpowiednimi bazami danych. Zapewnia to zgodność ze standardem HL7 FHIR i innymi standardami opieki zdrowotnej oraz wspiera interoperacyjność.
Wykorzystanie kliniczne i cykl sprzężenia zwrotnego: Integracja umożliwia pracownikom służby zdrowia wykorzystywanie wyodrębnionych informacji do podejmowania decyzji klinicznych, badań i inicjatyw z zakresu zdrowia publicznego. Pętle sprzężenia zwrotnego w trybie sztucznej inteligencji (AI) pomagają z czasem zwiększać dokładność modelu, dostosowując się do nowych typów danych lub wzorców językowych.
Wyzwania związane z wykorzystaniem przetwarzania języka naturalnego do ekstrakcji danych z EHR
Zadanie wyodrębniania nieustrukturyzowanych danych z EHR jest ambitne i może ułatwić życie interesariuszom w sektorze opieki zdrowotnej. Istnieją jednak wąskie gardła, które mogą utrudniać płynny proces wdrożenia. Przyjrzyjmy się najczęstszym problemom, aby móc proaktywnie opracować strategie ich rozwiązania lub złagodzenia.
Jakość, różnorodność i stronniczość danych: Dokładność ekstrakcji NLP zależy od jakości, spójności i reprezentatywności danych z EHR. Różne formaty, terminologie, niekompletne rekordy lub stronnicze próbki mogą obniżyć wydajność modelu AI.
Prywatność, bezpieczeństwo i zgodność w trybie AI: Należy wdrożyć środki zapewniające prywatność pacjentów i bezpieczeństwo danych podczas przetwarzania i przechowywania danych z wykorzystaniem przetwarzania języka naturalnego/sztucznej inteligencji. Należy przestrzegać wytycznych regulacyjnych, takich jak RODO, HIPAA itp. Obejmuje to anonimizację, bezpieczne przechowywanie i kontrolę dostępu.
Walidacja kliniczna i interpretowalność: Wyodrębnione informacje wymagają walidacji przez pracowników służby zdrowia w celu zapewnienia ich dokładności i znaczenia klinicznego. Złożona terminologia, niejednoznaczne sformułowania lub rzadkie schorzenia mogą wprowadzać zamieszanie w modelach. Ponadto systemy oparte na sztucznej inteligencji muszą być zrozumiałe, aby klinicyści mogli im zaufać.
Integracja, interoperacyjność i standardy: Wyodrębnione dane muszą być płynnie zintegrowane z istniejącymi systemami EHR i innymi systemami informatycznymi opieki zdrowotnej. Modele sztucznej inteligencji powinny obsługiwać standardy HL7, FHIR, SNOMED, RadLex itp., aby zapewnić interoperacyjność.
Skalowalność i konserwacja: W trybie sztucznej inteligencji systemy wymagają ciągłego ponownego szkolenia, monitorowania i wersjonowania, aby uwzględniać nowe praktyki kliniczne, ewoluującą terminologię medyczną lub zmiany w stylu dokumentacji.
Wymagania dotyczące kosztów i zasobów: Opracowywanie, szkolenie, walidacja i wdrażanie systemów przetwarzania języka naturalnego opartych na sztucznej inteligencji wymaga inwestycji w adnotacje danych, nadzór ekspertów, zasoby obliczeniowe i wykwalifikowany personel.
Uwagi końcowe
Krótko mówiąc, potencjał wdrażania przetwarzania języka naturalnego (NLP) opartego na sztucznej inteligencji (AI) do ekstrakcji danych medycznych z EHR jest nieograniczony. Aby zapewnić niezawodne wdrożenia, zalecamy stawienie czoła wyzwaniom, egzekwowanie nadzoru klinicznego i zapewnienie odpowiedzialnego wdrożenia w „trybie AI”.
Jeśli chcesz utorować drogę do ścisłej zgodności z wymogami dotyczącymi danych medycznych i uzyskać najlepsze dane treningowe AI dla swoich modeli, skontaktuj się z nami. Jako pionierzy w branży, rozumiemy domenę, wizje Twojego przedsiębiorstwa i zawiłości związane z trenowaniem klinicznego modelu przetwarzania języka naturalnego (NLP) zoptymalizowanego pod kątem sztucznej inteligencji, natywnego dla opieki zdrowotnej. Skontaktuj się z nami już dziś.