Jeśli spojrzymy tylko na wyniki automatyczne, większość programów LLM wydaje się świetna – dopóki nie napiszą czegoś subtelnie błędnego, ryzykownego lub niepasującego do tematu. To właśnie jest luka między tym, co mierzą statyczne testy porównawcze, a tym, czego faktycznie potrzebują użytkownicy. W tym poradniku pokazujemy, jak połączyć osąd ludzki (HITL) z automatyzacją, aby testy porównawcze LLM odzwierciedlały prawdziwość, bezpieczeństwo i dopasowanie do domeny – a nie tylko dokładność na poziomie tokena.
Co tak naprawdę mierzy benchmarking LLM
Zautomatyzowane metryki i tabele wyników są szybkie i powtarzalne. Dokładność w zadaniach wielokrotnego wyboru, BLEU/ROUGE w przypadku podobieństwa tekstu i perplexity w modelowaniu języka dają sygnały kierunkowe. Często jednak brakuje w nich ciągów rozumowania, oparcia na faktach i zgodności z polityką – zwłaszcza w kontekstach wysokiego ryzyka. Dlatego nowoczesne programy kładą nacisk na wielowymiarowość, transparentne raportowanie i realizm scenariuszy.
Zautomatyzowane metryki i statyczne zestawy testów
Wyobraź sobie klasyczne wskaźniki jak prędkościomierz – świetny do pomiaru prędkości na gładkiej autostradzie. Ale nie powiedzą Ci, czy hamulce działają w deszczu. BLEU/ROUGE/perplexity pomagają w porównywaniu, ale można je oszukać, zapamiętując lub porównując na poziomie powierzchownym.
Gdzie zawodzą
Prawdziwi użytkownicy wprowadzają niejednoznaczność, żargon branżowy, sprzeczne cele i zmieniające się przepisy. Statyczne zestawy testowe rzadko to odzwierciedlają. W rezultacie, w pełni zautomatyzowane testy porównawcze przeceniają gotowość modelu do realizacji złożonych zadań korporacyjnych. Inicjatywy społecznościowe, takie jak HELM/AIR-Bench, rozwiązują ten problem, obejmując więcej wymiarów (solidność, bezpieczeństwo, jawność) i publikując transparentne, ewoluujące pakiety.
Argumenty za oceną człowieka w benchmarkach LLM
Niektóre cechy pozostają uparcie ludzkie: ton, pomocność, subtelna poprawność, adekwatność kulturowa i ryzyko. Ludzcy oceniający – odpowiednio przeszkoleni i skalibrowani – to najlepsze narzędzia, jakimi dysponujemy w tym zakresie. Sztuką jest ich selektywne i systematyczne wykorzystywanie , aby koszty pozostały rozsądne, a jakość wysoka.
Kiedy angażować ludzi
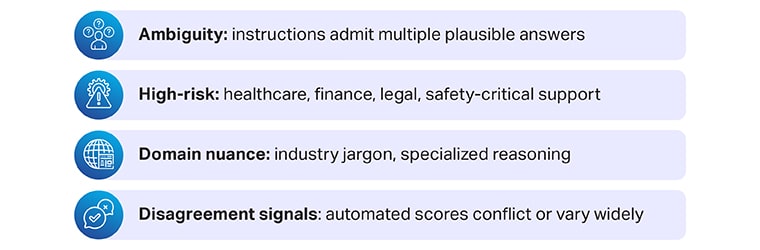
- Niejasność: instrukcje dopuszczają wiele prawdopodobnych odpowiedzi.
- Wysokie ryzyko: opieka zdrowotna, finanse, prawo, wsparcie krytyczne dla bezpieczeństwa.
- Niuanse domeny: żargon branżowy, specjalistyczne rozumowanie.
- Sygnały niezgody: automatyczne wyniki są sprzeczne lub znacznie się różnią.
Projektowanie rubryk i kalibracja (prosty przykład)
Zacznij od skali 1–5 dla poprawności , ugruntowania i zgodności z polityką . Podaj 2–3 przykłady z adnotacjami na każdy wynik. Przeprowadź krótkie rundy kalibracji : oceniający oceniają wspólną partię, a następnie porównują uzasadnienia, aby zwiększyć spójność. Śledź zgodność między oceniającymi i wymagaj rozstrzygnięcia w przypadkach granicznych.
Metody: od LLM-as-a-Judge do prawdziwego HITL
Model LLM-as-a-Judge (wykorzystujący model do oceniania innego modelu) jest przydatny w triażu : jest szybki, tani i dobrze sprawdza się w przypadku prostych kontroli. Może jednak mieć te same słabe punkty – halucynacje, fałszywe korelacje lub „inflację ocen”. Używaj go do priorytetyzacji spraw do przeglądu przez człowieka, a nie do ich zastępowania.
Praktyczny rurociąg hybrydowy
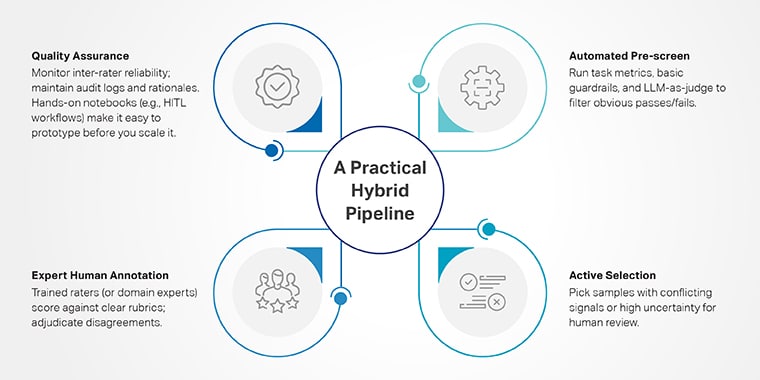
- Zautomatyzowana wstępna selekcja: uruchom metryki zadań, podstawowe zabezpieczenia i LLM-as-judge, aby odfiltrować oczywiste zaliczenia/niezaliczenia.
- Aktywny wybór: wybierz próbki z sygnałami sprzecznymi lub o wysokiej niepewności do przeglądu przez człowieka.
- Adnotacja eksperta: przeszkoleni oceniający (lub eksperci dziedzinowi) oceniają według jasnych kryteriów i rozstrzygają rozbieżności.
- Zapewnienie jakości: Monitoruj rzetelność między oceniającymi; prowadź dzienniki audytów i uzasadnienia. Praktyczne notatniki (np. przepływy pracy HITL) ułatwiają prototypowanie tej pętli przed jej skalowaniem.
Tabela porównawcza: Zautomatyzowany, LLM-as-Judge i HITL
Kryteria bezpieczeństwa i ryzyka są różne
Organy regulacyjne i normalizacyjne oczekują ewaluacji dokumentujących ryzyko, testujących realistyczne scenariusze i wykazujących nadzór. Dokument NIST AI RMF (Profil GenAI z 2024 r.) zapewnia wspólne słownictwo i praktyki; program ewaluacji NIST GenAI tworzy testy specyficzne dla danej dziedziny; a HELM/AIR-Bench prezentuje wielowymiarowe, transparentne wyniki. Wykorzystaj je do zakotwiczenia narracji dotyczącej zarządzania.
Co należy zebrać w ramach audytów bezpieczeństwa
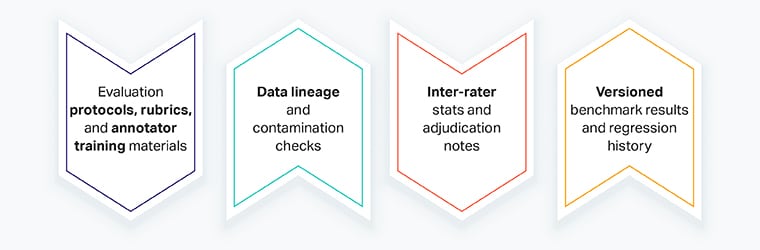
- Ocena protokoły, rubryki, szkolenie adnotatorów materiały
- Pochodzenie danych i kontrole zanieczyszczeń
- Między oceniającymi statystyki i notatki z orzeczeń
- Wersjonowany wyniki testów porównawczych i historia regresji
Mini-historia: Eliminowanie fałszywych wyników w bankowym KYC
Zespół analityków KYC banku przetestował dwa modele podsumowujące alerty zgodności. Zautomatyzowane wyniki były identyczne. Podczas testu HITL, oceniający zasygnalizowali, że Model A często pomijał negatywne kwalifikatory („brak wcześniejszych sankcji”), zmieniając znaczenie. Po ocenie, bank wybrał Model B i zaktualizował monity. Liczba fałszywych wyników spadła o 18% w ciągu tygodnia, dając analitykom czas na przeprowadzenie prawdziwych dochodzeń. (Lekcja: zautomatyzowane wyniki pomijały subtelny, istotny błąd; HITL go wykrył).
Gdzie Shaip pomaga
- Słownik i edukacja: Wyjaśnienie w prostym języku na temat udziału człowieka w procesie i dlaczego ma to znaczenie dla GenAI.
- Poradnik i strategia: A przewodnik dla początkujących dotyczący oceny LLM dla zespołów zaczynających od zera.
- Platforma: A Platforma do oceny i monitorowania generatywnej sztucznej inteligencji w celu wdrożenia triażu, eksperymentów i audytów.