W dzisiejszym szybkim, napędzanym technologią świecie aplikacje konwersacyjnej AI, takie jak Alexa, Siri i Google Home, stały się niezbędne w naszym codziennym życiu. Uproszczają zadania, zapewniają natychmiastowe rozwiązania i ulepszają sposób, w jaki wchodzimy w interakcje z maszynami. Jednak za płynnym doświadczeniem kryje się labirynt wyzwań, z którymi deweloperzy mierzą się podczas tworzenia inteligentnych, konwersacyjnych systemów.
Wraz ze wzrostem zapotrzebowania na inteligentniejszych, wielojęzycznych i inteligentnych emocjonalnie asystentów czatu, kluczowe staje się zrozumienie przeszkód w tworzeniu tych narzędzi i sposobów ich skutecznego pokonywania. W tym przewodniku przyjrzymy się najpilniejszym wyzwaniom związanym z danymi w sztucznej inteligencji konwersacyjnej i przedstawimy praktyczne rozwiązania, które pomogą w budowaniu modeli AI, które naprawdę przemawiają do użytkowników.
Najczęstsze wyzwania związane z danymi w sztucznej inteligencji konwersacyjnej
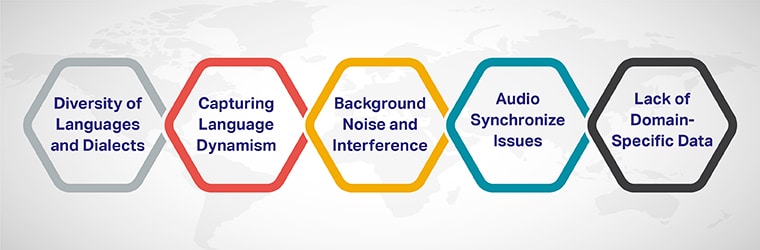
1. Różnorodność języków i dialektów
Jednym z największych wyzwań w Conversational AI jest ogromna różnorodność języków używanych na całym świecie. Podczas gdy około 1.35 miliarda ludzi mówi po angielsku jako pierwszym lub drugim języku, stanowi to mniej niż 20% światowej populacji. Pozostają miliardy potencjalnych użytkowników, którzy komunikują się w innych językach, często bogatych w unikalne dialekty, slang i niuanse kulturowe.
Rozwiązanie:
Aby zasypać tę lukę, firmy potrzebują dostępu do ogromnych, wysokiej jakości wielojęzycznych zestawów danych, które obejmują nie tylko główne języki, ale także regionalne dialekty i języki potoczne. Wykorzystanie wstępnie adnotowanych zestawów danych mowy dostosowanych do rynków globalnych może poprawić inkluzywność i wszechstronność modeli konwersacyjnej AI.
2. Przechwytywanie dynamiki języka
Języki są żywe — ewoluują z czasem, zawierają slang i odzwierciedlają emocje. Ten dynamizm stanowi wyzwanie dla modeli AI, które mają problemy z interpretacją subtelnych niuansów, takich jak ton, sarkazm i sentyment. Ludzie komunikują się poza słowami, a nieuchwycenie tego „czynnika ludzkiego” może prowadzić do nieosobistych lub nieistotnych odpowiedzi.
Rozwiązanie:
Trenuj swoją sztuczną inteligencję za pomocą zestawów danych, które zawierają rzeczywiste przykłady zmienności emocjonalnej, kontekstowej i kulturowej. Wykorzystanie zestawów danych treningowych sztucznej inteligencji o wysokiej inteligencji emocjonalnej gwarantuje, że Twój asystent konwersacyjny zrozumie głębszy kontekst zapytań użytkowników, co przełoży się na bardziej naturalne i znaczące interakcje.
3. Szum tła i zakłócenia
Od szczekających psów i dzwonków do drzwi po nakładające się rozmowy, dźwięk w świecie rzeczywistym rzadko jest nieskazitelny. Te szumy tła często zakłócają działanie systemów rozpoznawania głosu, zmniejszając dokładność konwersacyjnej sztucznej inteligencji. Ponadto, przy współistnieniu wielu asystentów głosowych w tym samym środowisku, odróżnianie poleceń użytkownika od konkurencyjnych urządzeń może być trudne.
Rozwiązanie:
Zaawansowane algorytmy filtrowania hałasu w połączeniu z wysokiej jakości, rzeczywistymi zbiorami danych audio mogą pomóc wyszkolić sztuczną inteligencję w rozpoznawaniu i priorytetyzowaniu poleceń wydawanych przez człowieka, a nie w hałasie tła. Zaprojektowanie solidnych modeli rozpoznawania głosu , uwzględniających zróżnicowane środowiska akustyczne, jest kluczowe dla pokonania tego wyzwania.
4. Problemy z synchronizacją dźwięku
Podczas trenowania narzędzi AI za pomocą rozmów telefonicznych synchronizacja dźwięku zarówno od dzwoniącego, jak i agenta może być problematyczna. Nieprawidłowo wyrównane dane audio tworzą luki w zrozumieniu przepływu konwersacji, co prowadzi do nieefektywności w trenowaniu modelu.
Rozwiązanie:
Inwestuj w zestawy danych, które są wstępnie zsynchronizowane i adnotowane dla dźwięku dwukanałowego. Dzięki temu rozmowy będą dokładnie wyrównane i gotowe do szkolenia, co zmniejszy ilość pracy ręcznej i poprawi wydajność modelu.
5. Brak danych specyficznych dla domeny
Konwersacyjna sztuczna inteligencja nie jest rozwiązaniem uniwersalnym. Podczas gdy uniwersalne chatboty dobrze radzą sobie z prostymi zadaniami, często nie potrafią udzielić precyzyjnych odpowiedzi na zapytania dotyczące konkretnych branż — czy to opieki zdrowotnej, finansów czy motoryzacji.
Rozwiązanie:
Aby tworzyć branżowe aplikacje AI, potrzebujesz niestandardowych zestawów danych , które odzwierciedlają terminologię, procesy i oczekiwania użytkowników w danej dziedzinie. Na przykład, trenowanie chatbota medycznego za pomocą adnotowanych rozmów medycznych lub zestawów danych EHR może znacznie zwiększyć jego dokładność i trafność.
[Przeczytaj także: Telemedycyna wspomagana sztuczną inteligencją: przypadki użycia, korzyści i wyzwania w świecie rzeczywistym ]
Wpływ wyzwań związanych z danymi na konsumentów
W przeciwieństwie do wyszukiwarek tekstowych, które oferują wiele opcji, oczekuje się, że Conversational AI dostarczy jedną, dokładną odpowiedź. Gdy podstawowe zestawy danych są stronnicze lub niekompletne, wyniki mogą być mylące, nieistotne, a nawet frustrujące dla użytkowników. Ten brak precyzji nie tylko zmniejsza zaufanie użytkowników, ale także wpływa na reputację marki.
Dla firm stawka jest jasna: lepsze dane prowadzą do lepszych doświadczeń klientów . Podjęcie tych wyzwań na etapie gromadzenia danych i trenowania modelu gwarantuje, że Twoja konwersacyjna sztuczna inteligencja konsekwentnie dostarcza użytkownikom wartość.
Jak pokonać wyzwania związane z danymi i zbudować inteligentniejszą sztuczną inteligencję
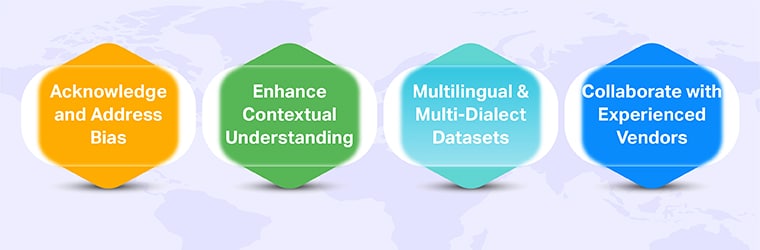
1. Rozpoznaj i zajmij się stronniczością
Pierwszym krokiem do zbudowania lepszej AI jest rozpoznanie obecności stronniczości w zestawach danych. Proaktywne wprowadzanie strategii wykrywania i łagodzenia stronniczości — takich jak pętle informacji zwrotnej od użytkownika i konfigurowalne ustawienia — może pomóc zapobiec przekłamanym wynikom.
2. Popraw zrozumienie kontekstowe
Szkolenie modelu w celu zrozumienia kontekstowych konwersacji jest kluczowe. Można to osiągnąć, włączając zestawy danych, które odzwierciedlają wzorce interakcji w świecie rzeczywistym, w tym konwersacje z udziałem wielu osób i spontaniczny dialog.
3. Inwestuj w wielojęzyczne i wielodialektowe zbiory danych
Rozszerzenie zasięgu językowego o zróżnicowane zbiory danych jest kluczem do dotarcia do globalnych odbiorców. Współpracując z dostawcami danych specjalizującymi się w wielojęzycznych zestawach danych szkoleniowych sztucznej inteligencji konwersacyjnej , firmy mogą skalować swoje rozwiązania AI, aby sprostać wymaganiom zróżnicowanych rynków.
4. Współpracuj z doświadczonymi dostawcami
Współpraca z doświadczonym partnerem w zakresie gromadzenia danych za pomocą sztucznej inteligencji konwersacyjnej może znacząco usprawnić proces ich gromadzenia i adnotacji. Doświadczeni dostawcy oferują specjalistyczną wiedzę w zakresie tworzenia wysokiej jakości, konfigurowalnych zestawów danych, dostosowanych do indywidualnych potrzeb. To nie tylko obniża koszty, ale także przyspiesza wprowadzanie rozwiązań AI na rynek.
[Przeczytaj także: Rozwój asystentów głosowych opartych na sztucznej inteligencji w celu poprawy jakości opieki zdrowotnej ]
Trendy kształtujące przyszłość sztucznej inteligencji konwersacyjnej
- Biometria głosu: Systemy AI integrują biometrię głosu w celu zwiększenia bezpieczeństwa i personalizacji. Dzięki zbiorom danych biometrycznych firmy mogą tworzyć rozwiązania AI, które rozpoznają poszczególnych użytkowników na podstawie ich unikalnych wzorców głosowych.
- Multimodalna sztuczna inteligencja: Konwersacyjna sztuczna inteligencja nowej generacji łączy tekst, głos i dane wizualne, aby zapewnić bogatsze, bardziej interaktywne doświadczenia użytkownika. Szkolenie modeli sztucznej inteligencji z zestawy danych multimodalnych staje się priorytetem dla firm, które chcą utrzymać się na czele stawki.
- Generatywna sztuczna inteligencja do rozmów: Modele generatywnej sztucznej inteligencji, takie jak ChatGPT, rewolucjonizują systemy konwersacyjne. Włączenie dopracowane zestawy danych generatywnej sztucznej inteligencji może dać Twojemu asystentowi czatu możliwość generowania odpowiedzi, które będą sprawiać wrażenie bardziej ludzkich i adaptacyjnych.

Współpracuj z Shaip, aby uzyskać dokładne zestawy danych AI konwersacyjnej
W Shaip specjalizujemy się w dostarczaniu wysokiej jakości, szytych na miarę zestawów danych dla sztucznej inteligencji konwersacyjnej. Niezależnie od tego, czy tworzysz wielojęzycznego chatbota, dopracowujesz asystenta głosowego, czy projektujesz aplikację branżową, nasz obszerny katalog zestawów danych głosowych, audio i tekstowych pomoże Ci odnieść sukces w projekcie.
Posiadając wiedzę specjalistyczną w ponad 65 językach i dialektach, Shaip pomaga firmom pokonywać wyzwania związane z danymi i tworzyć rozwiązania AI, które są inkluzywne, inteligentne i wpływowe. Pozwól nam pomóc Ci odblokować pełny potencjał Conversational AI.