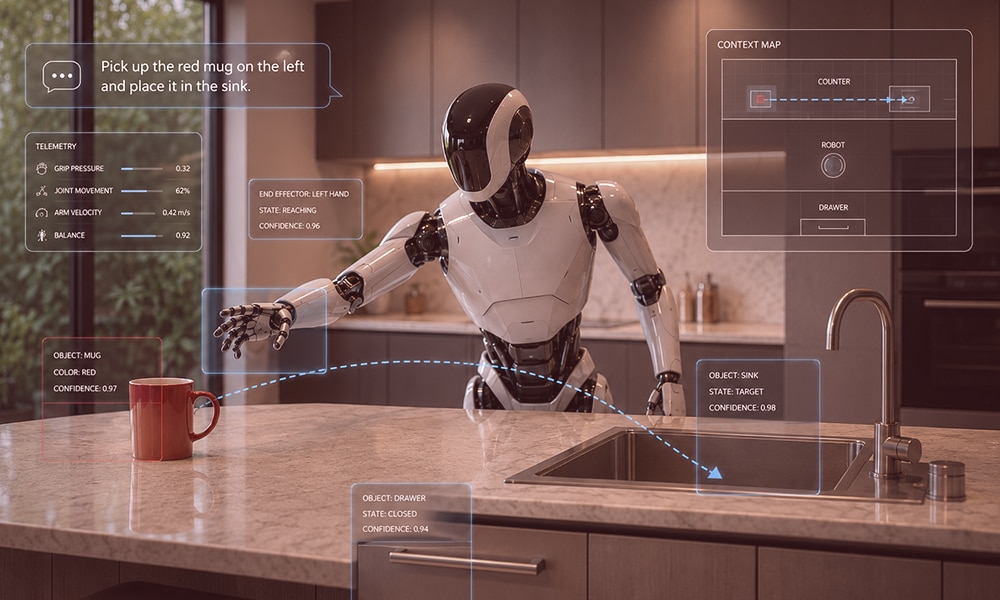
Kadra kierownicza zwraca na to uwagę, ponieważ kontekst = wydajność : łączenie sygnałów poprawia trafność i redukuje halucynacje w wielu zadaniach (choć nie zawsze). Najnowsze badania wskazują na to przejście od „inteligentnego oprogramowania” do „eksperckiego pomocnika”, gdy modele ujednolicają modalności.
Przykłady zastosowań multimodalnej sztucznej inteligencji, które możesz wdrożyć już w tym roku

- Dokument AI z obrazami i tekstem
Zautomatyzuj proces obsługi roszczeń ubezpieczeniowych, odczytując zeskanowane pliki PDF, zdjęcia i odręczne notatki. Bot do obsługi roszczeń, który widzi wgniecenie, odczytuje notatkę rzeczoznawcy i sprawdza numer VIN, ogranicza konieczność ręcznego sprawdzania. - Piloci ds. obsługi klienta
Pozwól agentom przesłać zrzut ekranu + dziennik błędów + pocztę głosową użytkownika. Drugi pilot dostosowuje sygnały, aby zasugerować poprawki i przygotować odpowiedzi. - Triaż opieki zdrowotnej (z barierkami ochronnymi)
Połącz obrazy radiologiczne z notatkami klinicznymi, aby uzyskać wstępne sugestie dotyczące triażu (a nie diagnozy). Materiały dla kierownictwa podkreślają, że opieka zdrowotna jest głównym, wczesnym użytkownikiem, biorąc pod uwagę bogactwo danych i wagę problemu. - Przeszukiwanie wizualne i odkrywanie w handlu detalicznym
Użytkownicy robią zdjęcie i opisują: „podoba mi się ta kurtka, ale jest wodoodporna”. System łączy informacje wizualne z preferencjami tekstowymi, aby ocenić produkty. - Zapewnienie jakości w przemyśle
Kamery i czujniki akustyczne wykrywają anomalie na linii produkcyjnej, łącząc nietypowe dźwięki z mikrousterkami w obrazie.
Minihistoria: Zespół przyjęć w szpitalu regionalnym korzystał z pilotażowej aplikacji, która akceptuje zdjęcie butelki z receptą, krótką notatkę głosową i wpisany objaw. Zamiast trzech oddzielnych systemów, jeden model multimodalny weryfikuje dawkowanie, identyfikuje prawdopodobne interakcje i sygnalizuje pilne przypadki do weryfikacji przez człowieka. Rezultat nie był magiczny – po prostu zmniejszył liczbę przekazań z powodu „utraty kontekstu”.
Co się ostatnio zmieniło? Natywne modele multimodalne
Widocznym kamieniem milowym był GPT-4o (maj 2024 r.) – natywnie multimodalny model zaprojektowany do obsługi dźwięku, obrazu i tekstu w czasie rzeczywistym z opóźnieniem zbliżonym do ludzkiego. Ten „natywny” punkt ma znaczenie: mniej warstw łączących między modalnościami zazwyczaj oznacza mniejsze opóźnienie i lepsze dopasowanie.
Eksperci z Enterprise Explained z 2025 podkreślają, że multimodalność jest już głównym nurtem planów rozwoju produktów, a nie tylko demonstracji badawczych, co podnosi oczekiwania dotyczące rozumowania w różnych formatach.
Nieefektowna prawda: dane są fosą
Systemy multimodalne wymagają sparowanych i różnorodnych danych : obrazu z podpisem, dźwięku z transkrypcją, wideo z etykietą akcji. Gromadzenie i opisywanie danych na dużą skalę jest trudne – i właśnie na tym etapie wielu pilotów staje w miejscu.
- Aby uzyskać głębszy wgląd w rzeczywistość danych szkoleniowych, zapoznaj się z artykułem Shaipa kompletny przewodnik po danych treningowych multimodalnych (wolumen danych, parowanie i zapewnienie jakości). Przewodnik po danych treningowych sztucznej inteligencji multimodalnej.
- Jeśli Twój stos wymaga dźwięku głosowego, zacznij od czystego, zróżnicowanego dźwięku na dużą skalę. Usługi gromadzenia danych dotyczących mowy.
- Aby wdrożyć etykietowanie tekstu, obrazów, dźwięków i wideo, przeczytaj: Etykietowanie danych multimodalnych — kompletny przewodnik.
Ograniczenia i ryzyko: co powinni wiedzieć liderzy

- Sparowane dane stanowią fosę: Potrzeba systemów multimodalnych sparowane dane o dużej różnorodności (obraz – podpis, dźwięk – transkrypcja, wideo – opis akcji). Zebranie i uporządkowanie tego – etycznie i na dużą skalę – jest trudne, dlatego wielu pilotów zwleka.
- Uprzedzenia mogą się kumulować: Dwa niedoskonałe strumienie (obraz + tekst) nie będą miały średniej neutralnej; zaprojektuj oceny dla każdej modalności i etapu łączenia.
- Budżety opóźnień: W chwili dodania wizji/dźwięku zmieniają się profile opóźnień i kosztów; w początkowych wersjach należy uwzględnić udział człowieka i buforowanie.
- Zarządzanie od pierwszego dnia: Nawet w przypadku niewielkiego projektu pilotażowego korzyścią jest mapowanie ryzyka w oparciu o uznane ramy.
- Prywatność i bezpieczeństwo: Obrazy i dźwięki mogą ujawniać dane osobowe; logi mogą być poufne.
- Złożoność operacyjna: Narzędzia do przetwarzania, etykietowania i zapewniania jakości w różnych formatach wciąż się rozwijają.
Gdzie Shaip wpisuje się w Twoją multimodalną mapę drogową
Skuteczna multimodalna sztuczna inteligencja to przede wszystkim problem danych . Shaip zapewnia usługi danych szkoleniowych i przepływy pracy, aby uczynić go realnym:
- Zbierać: Na zamówienie zestawy danych mowy/audio w różnych językach i środowiskach.
- Etykieta:Adnotacje międzymodalne do obrazów, wideo i tekstu z rygorystyczną kontrolą jakości. Zobacz nasze przewodnik po etykietowaniu multimodalnym.
- Nauka:Praktyczne perspektywy z naszej przewodnik po danych treningowych sztucznej inteligencji multimodalnej—od strategii parowania po wskaźniki jakości.