Zestaw danych multimodalnych rozmów: podstawa sztucznej inteligencji nowej generacji
Wyobraź sobie rozmowę z przyjacielem przez wideorozmowę. Nie tylko słyszysz jego słowa – widzisz jego mimikę, gesty, a nawet przedmioty w tle. To połączenie wielu sposobów komunikacji sprawia, że rozmowa jest bogatsza, bardziej ludzka i skuteczniejsza.
Sztuczna inteligencja zmierza w tym samym kierunku. Zamiast polegać na zwykłym tekście, zaawansowane systemy muszą łączyć tekst, obrazy, dźwięk, a czasem wideo, aby lepiej rozumieć i reagować. Sercem tej ewolucji jest zbiór danych o konwersacjach multimodalnych – ustrukturyzowany zbiór dialogów wzbogacony o różnorodne dane wejściowe.
W tym artykule przyjrzymy się bliżej temu, czym są te zbiory danych, dlaczego są ważne i w jaki sposób wiodące na świecie przykłady kształtują przyszłość asystentów AI, silników rekomendacji i systemów opartych na inteligencji emocjonalnej.
Czym jest zbiór danych dotyczący konwersacji multimodalnych?
Zbiór danych o konwersacjach multimodalnych to zbiór danych dialogowych, w którym każda tura może obejmować więcej niż tylko tekst. Może on łączyć:
Tekst (słowa mówione lub pisane)
Obrazy (udostępnione zdjęcia lub materiały wizualne)
Dźwięk (intonacja, emocje mowy lub sygnały tła)
Wideo (gesty, mimika)
Analogia: Wyobraź sobie, że oglądasz film z dźwiękiem i napisami. Gdybyś miał tylko jeden tryb, historia mogłaby być niekompletna. Ale z obydwoma, kontekst i znaczenie są o wiele jaśniejsze.
👉 Aby zapoznać się z jasnymi definicjami pojęć związanych ze sztuczną inteligencją multimodalną, zapoznaj się z naszym słownikiem pojęć multimodalnych.
Niezbędne zbiory danych dotyczących rozmów multimodalnych (krajobraz konkurencji)
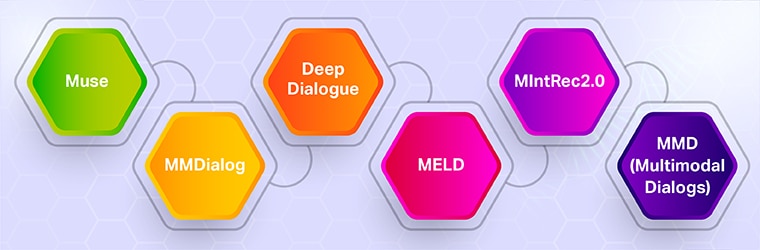
1. muza – Zestaw danych rekomendacji konwersacyjnych
Highlights: ~7,000 rozmów o rekomendacjach modowych, 83,148 wypowiedzi. Wygenerowane przez agentów multimodalnych, oparte na rzeczywistych scenariuszach. Przypadek użycia: Idealne do szkolenia stylistów i asystentów zakupowych korzystających ze sztucznej inteligencji.
2. MMDialog – Masowe dane dialogowe w domenie otwartej
Highlights: 1.08 miliona dialogów, 1.53 miliona obrazów, obejmujących 4,184 tematy. Jeden z największych dostępnych multimodalnych zbiorów danych. Przypadek użycia: Świetnie nadaje się do zastosowań ogólnych: od asystentów wirtualnych po chatboty o otwartym kodzie źródłowym.
3. DeepDialogue – Rozmowy bogate w emocje (2025)
Highlights: 40,150 41 dialogów wieloetapowych, 20 domen, XNUMX kategorii emocji. Koncentruje się na śledzeniu rozwoju emocji. Przypadek użycia: Projektowanie empatycznych agentów wsparcia AI lub towarzyszy zdrowia psychicznego.
4. MELD – Multimodalne rozpoznawanie emocji w rozmowie
Highlights: Ponad 13,000 XNUMX wypowiedzi z dialogów w programach telewizyjnych ("Przyjaciele"), wzbogaconych o dźwięk i obraz. Etykiety obejmują emocje takie jak radość, złość i smutek. Przypadek użycia: Systemy uwzględniające emocje, służące do wykrywania i reagowania na nastrój konwersacyjny.
5. MIntRec2.0 – Punkt odniesienia w zakresie rozpoznawania intencji multimodalnych
Highlights: 1,245 dialogów, 15,040 9,304 próbek, z etykietami „w zakresie” (5,736) i „poza zakresem” (XNUMX). Obejmuje wielostronną kategorię kontekstu i intencji. Przypadek użycia: Zapewnienie gruntownego zrozumienia intencji użytkownika, poprawa bezpieczeństwa i przejrzystości asystenta.
Highlights: Ponad 150 tys. sesji między kupującymi a agentami. Obejmuje wymianę tekstu i obrazów w kontekście handlu detalicznego. Przypadek użycia: Tworzenie multimodalnych chatbotów detalicznych lub interfejsów rekomendacji e-commerce.
Tabela porównawcza
Dataset
Skala / Rozmiar
Zasady
Moc:
Ograniczenie
muza
~7 tys. konwersji; 83 tys. wypowiedzi
Tekst + Obraz
Specyfika rekomendacji modowych
Specyficzne dla danej domeny (moda)
MMDialog
1.08 mln konwersji; 1.53 mln obrazów
Tekst + Obraz
Ogromny, szeroki zakres tematów
Złożona obsługa
Głęboki Dialog
40 tys. konwersji, 20 emocji
Tekst + Obraz
Rozwój emocji i empatia
Nowsze, mniej przetestowane
MELD
13 tys. wypowiedzi
Tekst + Wideo/Audio
Etykietowanie emocji wielostronnych
Mniejszy, ograniczony domeną
MIntRec2.0
15 tys. próbek
Tekst + Multimodalny
Wykrywanie intencji poza zakresem
Wąskie skupienie intencji
MMD
150 tys. sesji zakupowych
Tekst + Obraz
Dialogi dotyczące handlu detalicznego
Tylko domena detaliczna
Dlaczego te zestawy danych są ważne
Te bogate zbiory danych pomagają systemom AI:
Rozumiesz kontekst wykraczający poza słowa—jak wskazówki wizualne lub emocje.
Dostosuj rekomendacje, aby były realistyczne (np. muza).
Zbuduj systemy empatyczne i świadome emocjonalnie (Głęboki Dialog, MELD).
Lepsze wykrywanie intencji użytkownika i obsługa nieoczekiwanych zapytań (MIntRec2.0).
Obsługa interfejsów konwersacyjnych w środowiskach sprzedaży detalicznej (MMD).
Rozwój zbiorów danych dotyczących rozmów multimodalnych sprawia, że sztuczna inteligencja zmienia się z botów przetwarzających wyłącznie tekst w systemy, które potrafią widzieć, czuć i rozumieć kontekst.
Począwszy od stylizowanej logiki rekomendacji Muse , przez szerokość MMDialog , po wyrafinowanie intencji MIntRec2.0 , zasoby te napędzają inteligentniejszą, bardziej empatyczną sztuczną inteligencję.
W Shaip pomagamy organizacjom poruszać się w środowisku zbiorów danych, tworząc wysokiej jakości dane multimodalne pochodzące z etycznych źródeł, na potrzeby budowy inteligentnych systemów nowej generacji.
Czym jest zbiór danych dotyczący konwersacji multimodalnych?
Zbiór danych, w którym dialogi są zestawione z obrazem, dźwiękiem lub wideo w celu zapewnienia bogatszego kontekstu.
Który zbiór danych wspiera rozumienie emocji?
DeepDialogue koncentruje się na rozwoju emocji; MELD obejmuje interakcje wielostronne oznaczone emocjami.
Która z nich jest najlepsza dla sztucznej inteligencji domeny otwartej?
MMDialog , oferujący ponad milion rozmów i różnorodną tematykę, jest idealny dla asystentów ogólnego przeznaczenia.
Jaki zbiór danych pomaga w wykrywaniu intencji?
MIntRec2.0 obejmuje wykrywanie elementów poza zakresem i szczegółową taksonomię intencji dla solidnych systemów korporacyjnych.
Czy te zbiory danych są specyficzne dla danej domeny?
Tak. Wiele z nich jest wyspecjalizowanych – moda ( Muse ), emocje ( DeepDialogue , MELD ), handel detaliczny ( MMD ) itd. – co może ograniczać generalizację międzyaplikacyjną.
Podobał Ci się ten artykuł? Obserwuj Shaipa na LinkedIn, aby być na bieżąco.
Używamy plików cookie, aby poprawić Twoje doświadczenia na naszej stronie. Korzystając z naszej strony, wyrażasz zgodę na pliki cookie.
plików cookie
Zarządzaj swoimi preferencjami dotyczącymi plików cookie poniżej:
Niezbędne pliki cookie umożliwiają podstawowe funkcje i są niezbędne do prawidłowego funkcjonowania strony internetowej.
Imię i nazwisko
OPIS
Czas trwania:
plików cookie
Ten plik cookie służy do przechowywania preferencji użytkownika dotyczących zgody na pliki cookie.
180 dni
plików cookie
Ten plik cookie służy do przechowywania preferencji użytkownika dotyczących zgody na pliki cookie.
180 dni
Konfiguracja geolokalizacji
Ten plik cookie służy do przechowywania ustawień zgody na podstawie lokalizacji odwiedzającego.
180 dni
plików cookie
Ten plik cookie służy do przechowywania preferencji użytkownika dotyczących zgody na pliki cookie.
180 dni
Menedżer tagów Google ułatwia zarządzanie tagami marketingowymi na Twojej stronie internetowej bez konieczności zmiany kodu.
Imię i nazwisko
OPIS
Czas trwania:
TRINITY_USER_ID
-
DANE_UŻYTKOWNIKA_TRINITY
-
td
Rejestruje dane statystyczne dotyczące zachowań użytkowników w serwisie. Wykorzystywane do wewnętrznych analiz przez operatora strony internetowej.
Sesja
Preferencje plików cookie
Rejestruje preferencje użytkownika dotyczące plików cookie
2 roku
Pliki cookie statystyczne zbierają informacje anonimowo. Informacje te pomagają nam zrozumieć, w jaki sposób odwiedzający korzystają z naszej witryny.
Google Analytics to potężne narzędzie, które śledzi i analizuje ruch w witrynie internetowej, umożliwiając podejmowanie świadomych decyzji marketingowych.
Zawiera informacje związane z kampaniami marketingowymi użytkownika. Dane te są udostępniane Google AdWords/Google Ads, gdy konta Google Ads i Google Analytics są połączone.
90 dni
__utma
ID używane do identyfikacji użytkowników i sesji
2 lata od ostatniej aktywności
__utmt
Służy do monitorowania liczby żądań serwera Google Analytics
10 minut
__utmb
Służy do rozróżniania nowych sesji i wizyt. Ten plik cookie jest ustawiany, gdy ładowana jest biblioteka JavaScript GA.js, a plik cookie __utmb nie istnieje. Plik cookie jest aktualizowany za każdym razem, gdy dane są wysyłane do serwera Google Analytics.
30 minut po ostatniej aktywności
__utmc
Stosowane wyłącznie w starszych wersjach Urchin usługi Google Analytics i niedostępne w przypadku GA.js. Służył do rozróżniania nowych sesji i wizyt na koniec sesji.
Koniec sesji (przeglądarka)
__utmz
Zawiera informacje o źródle ruchu lub kampanii, która skierowała użytkownika na stronę internetową. Plik cookie jest ustawiany, gdy skrypt GA.js JavaScript jest ładowany i aktualizowany, gdy dane są wysyłane do serwera Google Analytics
6 miesięcy od ostatniej aktywności
__utmv
Zawiera niestandardowe informacje ustawione przez twórcę strony internetowej za pomocą metody _setCustomVar w Google Analytics. Ten plik cookie jest aktualizowany za każdym razem, gdy nowe dane są wysyłane do serwera Google Analytics.
2 lata od ostatniej aktywności
__utmx
Służy do ustalenia, czy użytkownik jest uwzględniony w teście A/B lub teście wielowymiarowym.
18 miesięcy
_ga
Identyfikator używany do identyfikacji użytkowników
2 roku
_gali
Używany przez Google Analytics do określania, które linki na stronie są klikane
30 sekund
_ga_
Identyfikator używany do identyfikacji użytkowników
2 roku
_gid
Identyfikator używany do identyfikacji użytkowników przez 24 godziny od ostatniej aktywności
24 godzin
_gat
Służy do monitorowania liczby żądań serwera Google Analytics podczas korzystania z Menedżera tagów Google
1 minut
Pliki cookie marketingowe służą do śledzenia odwiedzających strony internetowe. Celem jest wyświetlanie reklam, które są istotne i angażujące dla poszczególnych użytkowników.
Google Ads to internetowa platforma reklamowa umożliwiająca firmom tworzenie ukierunkowanych reklam wyświetlanych w wynikach wyszukiwania Google i witrynach partnerskich.
Plik cookie targetujący. Służy do tworzenia profilu użytkownika i wyświetlania użytkownikowi odpowiednich i spersonalizowanych reklam Google Ads.
2 roku
__Bezpieczne-1PSID
Plik cookie targetujący. Służy do tworzenia profilu użytkownika i wyświetlania użytkownikowi odpowiednich i spersonalizowanych reklam Google Ads.
2 roku
__Bezpieczny-3PAPISID
Tworzy profile zainteresowań użytkowników witryny internetowej, aby wyświetlać im trafne i spersonalizowane reklamy za pomocą remarketingu.
2 roku
AEC
Pliki cookie AEC zapewniają, że żądania w ramach sesji przeglądania są składane przez użytkownika, a nie przez inne witryny. Te pliki cookie zapobiegają działaniu złośliwych witryn w imieniu użytkownika bez jego wiedzy.
6 miesięcy
ADS_VISITOR_ID
Plik cookie wymagany do korzystania z opcji i usług internetowych na stronie
2 miesięcy
__Bezpieczne-3PSIDCC
Plik cookie targetujący. Służy do tworzenia profilu użytkownika i wyświetlania użytkownikowi odpowiednich i spersonalizowanych reklam Google Ads.
2 roku
__Secure-3PSIDTS
Plik cookie targetujący. Służy do tworzenia profilu użytkownika i wyświetlania użytkownikowi odpowiednich i spersonalizowanych reklam Google Ads.
2 roku
__Secure-1PSIDTS
Plik cookie targetujący. Służy do tworzenia profilu użytkownika i wyświetlania użytkownikowi odpowiednich i spersonalizowanych reklam Google Ads.
2 roku
__Bezpieczny-1PAPISID
Plik cookie targetujący. Służy do tworzenia profilu użytkownika i wyświetlania użytkownikowi odpowiednich i spersonalizowanych reklam Google Ads.
2 roku
__Bezpieczne-3PSID
Plik cookie targetujący. Służy do profilowania zainteresowań odwiedzających witrynę i wyświetlania odpowiednich i spersonalizowanych reklam Google.
2 roku
Konwersja
Google używa plików cookie do celów reklamowych, m.in. do wyświetlania i renderowania reklam, personalizowania reklam (w zależności od ustawień reklam na stronie g.co/adsettings), ograniczania liczby wyświetleń reklamy użytkownikowi, wyciszania reklam, których nie chcesz oglądać, oraz mierzenia skuteczności reklam.
90 dni
_gcl_aw
Google używa plików cookie do celów reklamowych, m.in. do wyświetlania i renderowania reklam, personalizowania reklam (w zależności od ustawień reklam na stronie g.co/adsettings), ograniczania liczby wyświetleń reklamy użytkownikowi, wyciszania reklam, których nie chcesz oglądać, oraz mierzenia skuteczności reklam.
90 Dni
_gcl_gs
Google używa plików cookie do celów reklamowych, m.in. do wyświetlania i renderowania reklam, personalizowania reklam (w zależności od ustawień reklam na stronie g.co/adsettings), ograniczania liczby wyświetleń reklamy użytkownikowi, wyciszania reklam, których nie chcesz oglądać, oraz mierzenia skuteczności reklam.
90 Dni
_gcl_pl
Google używa plików cookie do celów reklamowych, m.in. do wyświetlania i renderowania reklam, personalizowania reklam (w zależności od ustawień reklam na stronie g.co/adsettings), ograniczania liczby wyświetleń reklamy użytkownikowi, wyciszania reklam, których nie chcesz oglądać, oraz mierzenia skuteczności reklam.
90 Dni
_gac_gb_
Google używa plików cookie do celów reklamowych, m.in. do wyświetlania i renderowania reklam, personalizowania reklam (w zależności od ustawień reklam na stronie g.co/adsettings), ograniczania liczby wyświetleń reklamy użytkownikowi, wyciszania reklam, których nie chcesz oglądać, oraz mierzenia skuteczności reklam.
90 Dni
FPGCLGB
Google używa plików cookie do celów reklamowych, m.in. do wyświetlania i renderowania reklam, personalizowania reklam (w zależności od ustawień reklam na stronie g.co/adsettings), ograniczania liczby wyświetleń reklamy użytkownikowi, wyciszania reklam, których nie chcesz oglądać, oraz mierzenia skuteczności reklam.
90 Dni
FPGCLAW
Google używa plików cookie do celów reklamowych, m.in. do wyświetlania i renderowania reklam, personalizowania reklam (w zależności od ustawień reklam na stronie g.co/adsettings), ograniczania liczby wyświetleń reklamy użytkownikowi, wyciszania reklam, których nie chcesz oglądać, oraz mierzenia skuteczności reklam.
90 Dni
HubSpot to kompleksowa platforma łącząca marketing, sprzedaż i obsługę klienta, która usprawnia rozwój firmy.
Ten plik cookie jest używany do rozpoznawania odwiedzających, którzy czatują z Tobą za pomocą narzędzia chatflows. Jeśli odwiedzający opuści Twoją witrynę, zanim zostanie dodany jako kontakt, będzie miał ten plik cookie powiązany ze swoją przeglądarką.
13 miesięcy
__hs_do_not_track
Ten plik cookie można ustawić tak, aby zapobiec wysyłaniu przez kod śledzący jakichkolwiek informacji do HubSpot.
13 miesięcy
__hs_cookie_cat_pref
Ten plik cookie służy do rejestrowania kategorii, na które użytkownik wyraził zgodę.
6 miesięcy
__hs_initial_opt_in
Ten plik cookie jest używany do zapobiegania wyświetlaniu banera zawsze, gdy użytkownicy przeglądają strony w trybie ścisłym.
7 dni
__hs_gpc_banner_dismiss
Ten plik cookie jest używany po zamknięciu baneru Global Privacy Control.
180 dni
hs_ab_test
Ten plik cookie służy do konsekwentnego wyświetlania odwiedzającym tej samej wersji strony testu A/B, którą widzieli wcześniej.
Sesja
__hs_notify_banner_dismiss
Ten plik cookie jest używany, gdy witryna internetowa używa banera z prośbą o zgodę.
180 dni
hs-messages-is-open
Ten plik cookie jest używany do określania i zapisywania, czy widżet czatu będzie otwarty podczas przyszłych wizyt.
30 minut
hs-messages-hide-welcome-message
Ten plik cookie jest używany do zapobiegania wyświetlaniu powitalnego komunikatu w widżecie czatu przez jeden dzień po jego zamknięciu.
Dzień 1
__hsmem
Ten plik cookie jest ustawiany, gdy odwiedzający logują się do witryny hostowanej w HubSpot.
1 rok
członkostwo hs-csrf
Ten plik cookie jest używany w celu zapewnienia, że dane logowania do członkostwa w serwisie treści nie mogą zostać sfałszowane.
Sesja
hs_langswitcher_choice
Ten plik cookie jest używany do zapisywania wyboru języka wybranego przez odwiedzającego podczas przeglądania stron w wielu językach.
2 roku
__hstc
Główny plik cookie służący do śledzenia odwiedzających.
13 miesięcy
hubspotutk
Ten plik cookie śledzi tożsamość odwiedzającego. Jest on przekazywany do HubSpot podczas przesyłania formularza i używany podczas usuwania duplikatów kontaktów.
13 miesięcy
__hssc
Ten plik cookie śledzi sesje.
30 minut
__hssrc
Za każdym razem, gdy HubSpot zmienia plik cookie sesji, ten plik cookie jest również ustawiany w celu ustalenia, czy użytkownik ponownie uruchomił przeglądarkę.
Sesja
preferencje hubspotapi
Używa się tego w połączeniu z plikiem cookie hubspotapi, aby zapamiętać, czy użytkownik zaznaczył pole „zapamiętaj mnie” (kontroluje wygaśnięcie uwierzytelnienia głównego pliku cookie).
Rok 1
hubspotapi-csrf
Służy do zapobiegania atakom CSRF – uniemożliwia stronom internetowym osób trzecich dostęp do Twoich danych. Wygasa po roku.
1 rok
__hs_opcja_wyłączenia
Ten plik cookie jest używany przez politykę prywatności dotyczącą opcji opt-in, aby pamiętać, aby nie prosić odwiedzającego ponownie o zaakceptowanie plików cookie.
13 miesięcy
hubspotapi
Ten plik cookie umożliwia użytkownikowi dostęp do aplikacji z odpowiednimi uprawnieniami.