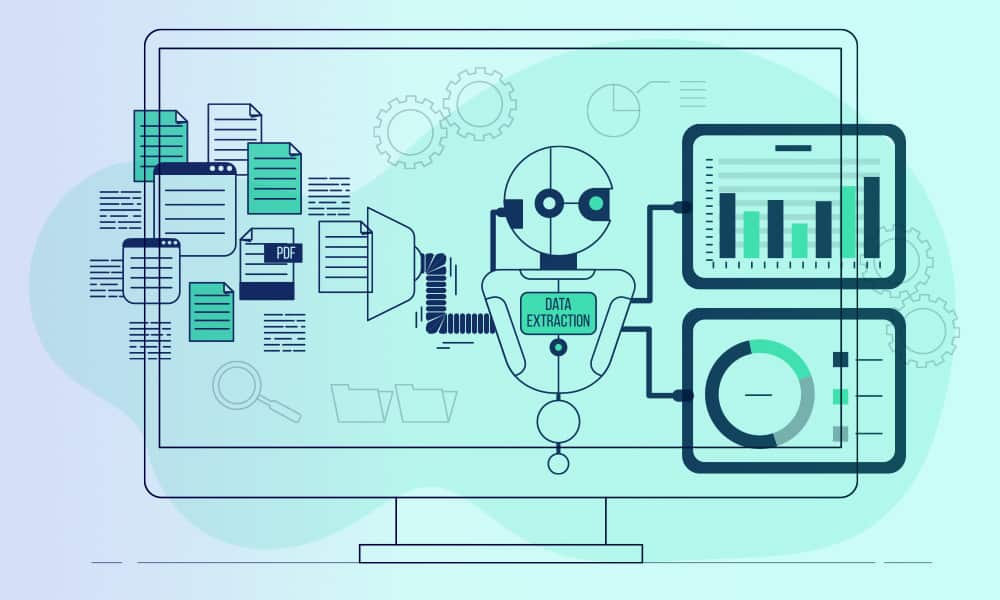

W sercu korporacyjnej sztucznej inteligencji kryje się cicha ironia: nawet najinteligentniejsze modele na świecie nie pomogą, jeśli Twoje dane utkną w zeskanowanej fakturze, faksie z raportem laboratoryjnym lub ręcznie napisanym dowodzie dostawy. Szacuje się, że 80% danych biznesowych znajduje się właśnie w tego typu nieustrukturyzowanych dokumentach.
Optyczne rozpoznawanie znaków (OCR) to technologia, która uwalnia te dane. I w 2026 roku przeżywa swój moment. Przewiduje się, że globalny rynek OCR osiągnie wartość 55.3 mld dolarów do 2033 roku, w porównaniu z 13.1 mld dolarów w 2023 roku, rosnąc w tempie 15.5% rocznie. Nowoczesne silniki rutynowo osiągają dokładność na poziomie 98–99% na poziomie strony. To, co kiedyś było nieporęcznym narzędziem do skanowania, stało się bramą do automatyzacji przedsiębiorstw.
Oto jak OCR wygląda obecnie: jak działa, jakie istnieją rodzaje, co zmieniła sztuczna inteligencja i w jakim kierunku zmierza.
Co to jest OCR?
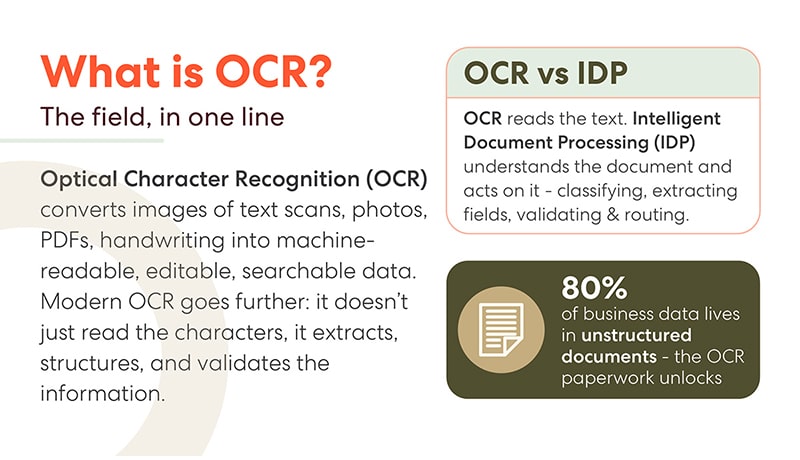
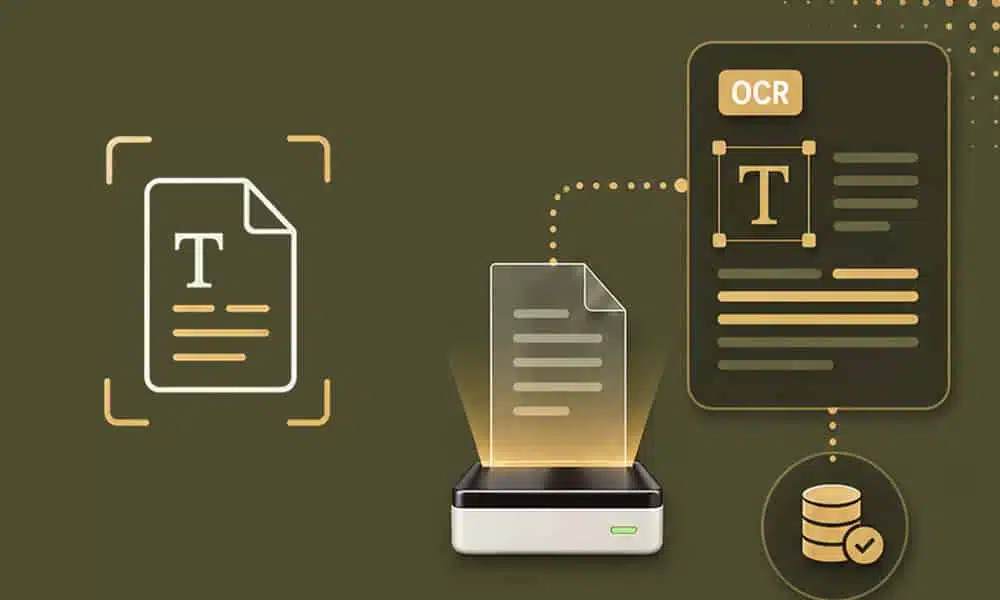
Optyczne rozpoznawanie znaków (OCR) konwertuje obrazy tekstu – skany, zdjęcia, pliki PDF, pismo odręczne – na dane czytelne maszynowo, edytowalne i przeszukiwalne. To definicja podręcznikowa, która nie odzwierciedla tego, co faktycznie dzieje się w 2026 roku.
Nowoczesny OCR nie tylko odczytuje znaki. Wyodrębnia struktury – pola, tabele, pozycje zamówienia – i weryfikuje pobrane informacje. Wystarczy podać mu zmiętą fakturę sfotografowaną telefonem, a zwróci nie kleks tekstu, ale uporządkowany rekord: dostawca, data, pozycje zamówienia, suma, każdy z poziomem ufności.
OCR kontra IDP: ważne rozróżnienie
Oba terminy usłyszysz w każdej rozmowie z dostawcą, więc oto różnica. OCR odczytuje tekst. Inteligentne Przetwarzanie Dokumentów (IDP) rozumie dokument i działa na nim – klasyfikuje go, wyodrębnia istotne pola, weryfikuje je pod kątem zgodności z regułami biznesowymi i kieruje wynik do odpowiedniego systemu.
Wyobraź sobie OCR jako oczy, a IDP jako mózg. Jedno bez drugiego daje tylko połowę sukcesu: idealnie przepisany tekst, który wciąż wymaga interpretacji przez człowieka, albo inteligentny przepływ pracy pozbawiony czytelnych danych wejściowych. Rynek zdecydowanie zmierza w kierunku tego połączenia.
Jak działa OCR: nowoczesny 6-etapowy proces
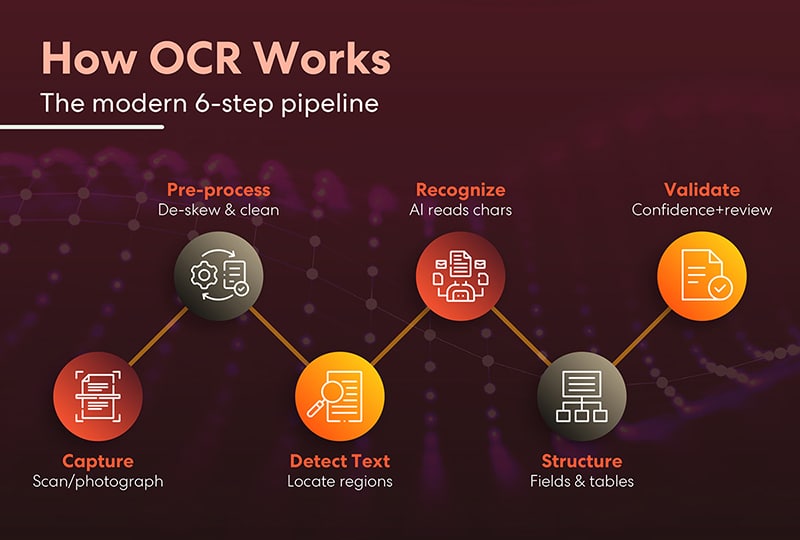
Współczesne systemy OCR działają w oparciu o sześcioetapowy proces, a jego zrozumienie pomaga wyjaśnić, dlaczego dokładność tak bardzo wzrosła, a także gdzie nadal pojawiają się błędy.
Wszystko zaczyna się od przechwycenia — skanu lub zdjęcia dokumentu. Następnie wstępne przetwarzanie oczyszcza obraz: prostuje przechylone strony, usuwa szum i koryguje kontrast, ponieważ jakość rozpoznawania jest tak dobra, jak obraz, od którego zaczyna. Następnie wykrywanie tekstu lokalizuje obszary strony, które faktycznie zawierają tekst, oddzielając słowa od logo, znaczków i tła. Następnie następuje rozpoznawanie , w którym sztuczna inteligencja odczytuje znaki — krok, który większość ludzi uważa za „OCR”. Ale nowoczesny proces na tym się nie kończy. Strukturyzacja mapuje surowy tekst na pola i tabele, zamieniając „słowa na stronie” w „dane w schemacie”. Na koniec walidacja stosuje punktację zaufania i przegląd, sygnalizując wszystko, co jest niepewne dla człowieka, zanim trafi do twoich systemów.
Przechwytywanie → wstępne przetwarzanie → wykrywanie → rozpoznawanie → strukturyzacja → walidacja. Te dwa ostatnie kroki odróżniają OCR z 2026 roku od oprogramowania skanującego sprzed dekady.
Rodzaje OCR: Nie każde rozpoznawanie jest takie samo
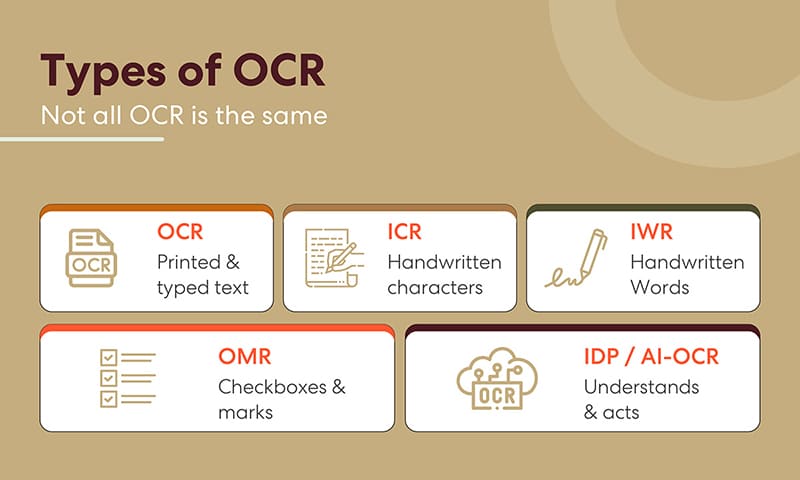
Termin „OCR” jest używany jako ogólny termin, ale w tej dziedzinie wyróżnia się kilka technologii, z których każda jest przeznaczona do różnych treści.
Właściwy OCR obsługuje tekst drukowany i pisany na maszynie – najprostszy i najbardziej dojrzały przypadek. ICR (Inteligentne Rozpoznawanie Znaków) odczytuje znaki pisane odręcznie, co stanowi jeden z najtrudniejszych problemów w tej dziedzinie. IWR (Inteligentne Rozpoznawanie Słów) idzie o krok dalej, rozpoznając całe słowa pisane odręcznie, a nie pojedyncze litery – lepiej sprawdza się w przypadku pisma odręcznego, gdzie znaki zlewają się ze sobą. OMR (Optyczne Rozpoznawanie Znaków) odczytuje pola wyboru i znaki, technologię stojącą za formularzami i arkuszami odpowiedzi. A IDP / AI-OCR znajduje się na szczycie listy: systemy, które nie tylko czytają, ale także rozumieją i działają.
Pierwszym pytaniem każdego projektu OCR jest ustalenie, jakiego typu dokumenty są potrzebne. Wydrukowana faktura i odręcznie napisana recepta lekarska to zupełnie różne problemy.
OCR w erze sztucznej inteligencji: surowy OCR to teraz tylko pierwszy krok
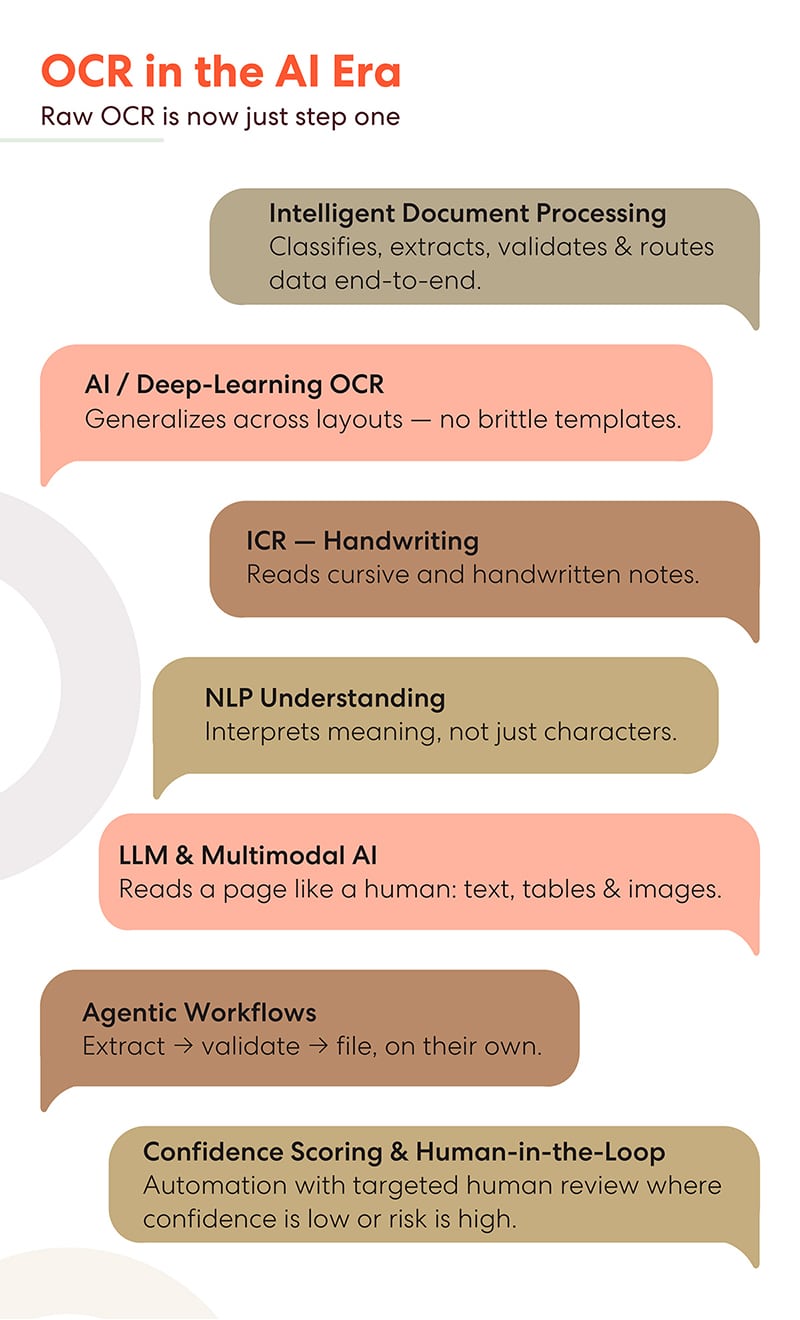
Najgłębsza zmiana w tej dziedzinie polega na tym, że rozpoznawanie znaków – kiedyś element całego produktu – jest teraz jedynie punktem wejścia. Siedem możliwości definiuje nowoczesną sztuczną inteligencję dokumentów.
Rozwiązanie Intelligent Document Processing obejmuje pełen proces przetwarzania dokumentów: klasyfikację dokumentów, wyodrębnianie pól, sprawdzanie poprawności danych i przesyłanie wyników bez konieczności ręcznego przekazywania.
Sztuczna inteligencja i głębokie uczenie OCR generalizują w różnych układach. Starsze systemy potrzebowały nietrwałego szablonu dla każdego formatu dokumentu; nowoczesne modele obsługują fakturę, której nigdy wcześniej nie widziały, ponieważ nauczyły się, jak faktury wyglądają w ogólności.
Technologia rozpoznawania pisma odręcznego ICR rozwinęła się na tyle, że umożliwia odczytywanie notatek pisanych kursywą i ręcznie, umożliwiając dostęp do dokumentacji medycznej, potwierdzeń dostawy i dokumentów archiwalnych, które wcześniej były niedostępne.
Rozumienie języka naturalnego (NLP) interpretuje znaczenie, a nie tylko znaki. System nie tylko przepisuje „Net 30” – wie, że to termin płatności.
LLM i multimodalna sztuczna inteligencja odczytują stronę tak, jak robi to człowiek: tekst, tabele i obrazy razem, w kontekście. To najnowsza i najszybciej rozwijająca się warstwa stosu.
Przepływy pracy agentowe zamykają pętlę: wyodrębnij → waliduj → plik, autonomicznie. Dokument nie jest tylko odczytywany, ale i obsługiwany.
Ocena zaufania z udziałem człowieka w procesie sprawia, że wdrożenie tego wszystkiego jest bezpieczne. Automatyzacja działa tam, gdzie zaufanie jest wysokie; ludzie dokonują przeglądu tylko tam, gdzie zaufanie jest niskie lub ryzyko jest wysokie. Model ukierunkowanego przeglądu to sposób, w jaki przedsiębiorstwa osiągają zarówno szybkość, jak i możliwość audytu.
Przykłady zastosowań OCR: Gdzie zapewnia wartość
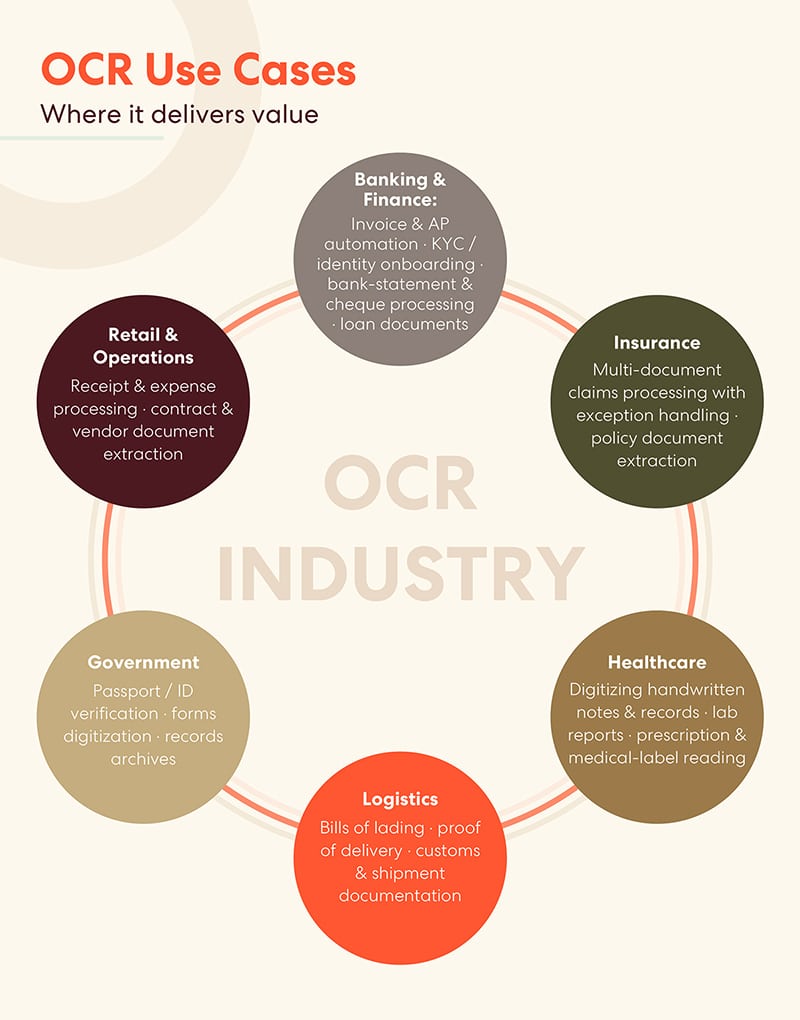
Branże najszybciej wdrażające technologię OCR to te, które toną w papierach.
Bankowość i finanse przodują na rynku — automatyzacja faktur i AP, KYC i wdrażanie tożsamości, przetwarzanie wyciągów bankowych i czeków. Nieprzypadkowo BFSI jest największym pionem OCR, z około 21% udziałem w rynku. Ubezpieczenia wykorzystują go do przetwarzania roszczeń obejmujących wiele dokumentów, z obsługą wyjątków i ekstrakcją dokumentów polis — pojedyncze roszczenie może obejmować dziesiątki dokumentów w różnych formatach. W opiece zdrowotnej OCR digitalizuje odręczne notatki i zapisy, odczytuje raporty laboratoryjne i przetwarza recepty oraz etykiety medyczne, gdzie dokładność jest dosłownie kwestią bezpieczeństwa. Logistyka opiera się na dokumentach — listach przewozowych, dowodach dostawy, dokumentach celnych i wysyłkowych — a OCR zapewnia przepływ towarów, zapobiegając powstawaniu wąskiego gardła w postaci dokumentów. Rząd stosuje go do weryfikacji paszportów i dowodów osobistych, przetwarzania formularzy i digitalizacji archiwów dokumentacji. W handlu detalicznym i operacjach wspomaga przetwarzanie paragonów i wydatków oraz ekstrakcję dokumentów umów i dostawców.
Wspólna cecha wszystkich sześciu rozwiązań: podczas gdy wcześniej człowiek przepisywał informacje z papieru do systemu, OCR robi to teraz szybciej, taniej i z możliwością śledzenia zdarzeń.
Korzyści i wyzwania: szczery obraz
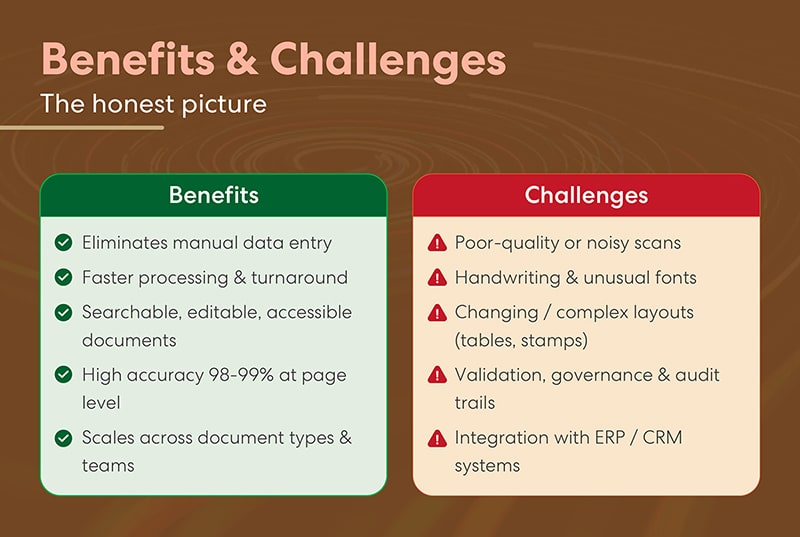
Korzyści są konkretne. OCR eliminuje ręczne wprowadzanie danych — najbardziej podatne na błędy i najmniej lubiane zadanie w każdym back-office. Przetwarzanie i realizacja stają się znacznie szybsze. Dokumenty stają się przeszukiwalne, edytowalne i dostępne zamiast martwych skanów. Dokładność sięga obecnie 98–99% na poziomie strony. Nowoczesne systemy skalują się w różnych typach i formatach dokumentów, zamiast blokować się przez cokolwiek nieznanego.
Jednak rzeczywiste wdrożenia wciąż napotykają na realne problemy. Skanowanie niskiej jakości lub z zakłóceniami pozostaje główną przyczyną braku dokładności – żaden model nie odczyta tego, co nie jest czytelne. Pismo odręczne i nietypowe czcionki nadal pozostają w tyle za drukowanym tekstem. Zmienne i złożone układy – zagnieżdżone tabele, stemple, formularze wielokolumnowe – utrudniają ekstrakcję. Walidacja, zarządzanie i ścieżki audytu wymagają prawdziwego wysiłku inżynieryjnego, szczególnie w regulowanych branżach. Integracja z systemami ERP i CRM to problem, na którym wiele projektów utknęło: ekstrakcja danych jest przydatna tylko wtedy, gdy trafią one do miejsca, w którym faktycznie wykonywana jest praca.
Żaden z nich nie jest powodem, dla którego istnieją systemy oceny zaufania i analizy z udziałem człowieka – i dla którego jakość dokumentów i dobrze opisane dane treningowe są równie ważne, jak wybór modelu.
Rynek OCR: źródła i aktualności
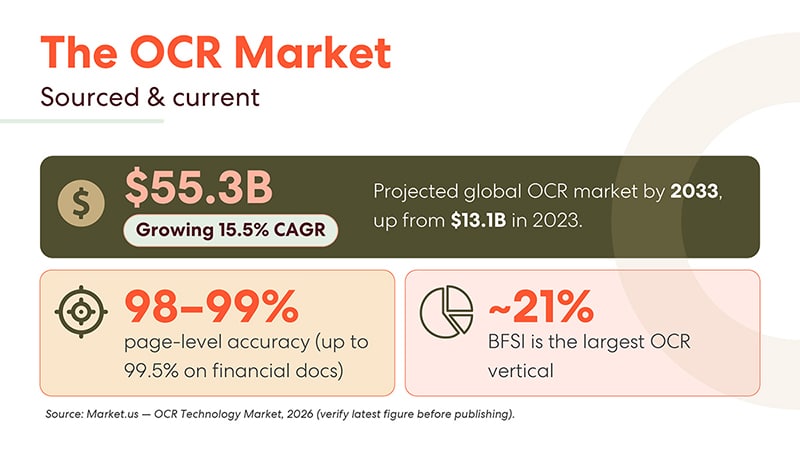
Liczby obrazują możliwości. Przewiduje się, że globalny rynek OCR osiągnie wartość 55.3 mld dolarów do 2033 roku , w porównaniu z 13.1 mld dolarów w 2023 roku – co oznacza 15.5% CAGR . Dokładność na poziomie strony osiągnęła 98–99% , a w przypadku dokumentów finansowych rośnie jeszcze bardziej. Sektor usług finansowych (BFSI) jest największym pionem, stanowiącym około 21% rynku, co wskazuje, że zwrot z inwestycji (ROI) jest tam najszybciej widoczny.
Co dalej: trendy OCR na rok 2026
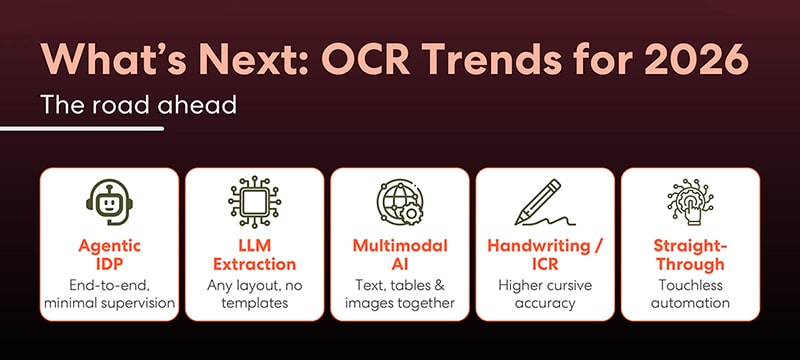
Pięć trendów wyznacza przyszłość. Agentowe IDP — przepływy pracy z dokumentami, które działają kompleksowo, bez ingerencji człowieka, na dobrej drodze. Ekstrakcja oparta na LLM — wykorzystanie dużych modeli językowych do pobierania ustrukturyzowanych danych z dokumentów z minimalną lub zerową konfiguracją szablonów. Multimodalna sztuczna inteligencja — modele przetwarzające tekst, tabele i obrazy w jednym przebiegu, rozumiejące dokumenty jako całość, a nie fragmenty. Postęp w dziedzinie pisma odręcznego i ICR — stale rosnąca dokładność w przypadku pisma kursywnego i nieuporządkowanego, otwierająca klasy dokumentów, które wcześniej były obsługiwane wyłącznie ręcznie. I przetwarzanie bezpośrednie — cel końcowy: dokumenty, które docierają, są czytane, weryfikowane i archiwizowane bez ingerencji człowieka.
Kierunek jest jednoznaczny: od czytania dokumentów po ich obsługę.
Bottom Line
W 2026 roku OCR nie polega już na przekształcaniu obrazów w tekst, lecz na przekształcaniu dokumentów w gotowe rozwiązania. 80% danych biznesowych jest przechowywanych w nieustrukturyzowanych dokumentach, a rynek zbliża się do 55 miliardów dolarów. Pytanie dla większości organizacji nie brzmi, czy wdrożyć OCR, ale jak daleko zajść: ekstrakcja zwykłego tekstu, ustrukturyzowane IDP czy w pełni agenckie przepływy pracy z dokumentami.
Dokumenty już się piętrzą. Technologia umożliwiająca ich odczytanie — i podjęcie działań na ich podstawie — jest już gotowa.