Duże modele językowe (LLM), takie jak GPT-4 i Llama 3, wpłynęły na krajobraz AI i zdziałały cuda, od obsługi klienta po generowanie treści. Jednak dostosowanie tych modeli do konkretnych potrzeb zwykle oznacza wybór między dwiema potężnymi technikami: generowaniem rozszerzonym o pobieranie (RAG) i dostrajaniem.
Chociaż oba te podejścia wzmacniają LLM, są one sformułowane w kierunku różnych celów i są skuteczne w różnych sytuacjach. Przyjrzyjmy się szczegółowo zaletom i wadom tych dwóch metod oraz temu, jak można wybrać jedną z nich do swoich potrzeb.
Generacja wspomagana wyszukiwaniem (RAG) – co to jest?
RAG to podejście, które synergizuje możliwości generatywne LLM z wyszukiwaniem odpowiedzi precyzyjnych kontekstowo. Zamiast wykorzystywać wyłącznie wiedzę, na której przeprowadzono test, RAG pobiera istotne informacje z zewnętrznych baz danych lub repozytoriów wiedzy, aby włączyć je do procesu generowania odpowiedzi.
Jak działa RAG
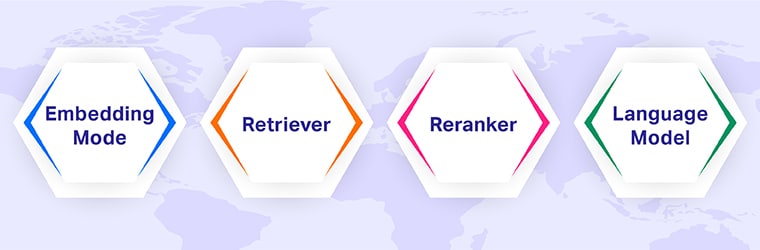
- Model osadzania: Osadza zarówno dokumenty, jak i zapytania w przestrzeni wektorowej, co zwiększa efektywność porównywania.
- Aporter:Przegląda bazę wiedzy poprzez osadzenia w celu pobrania odpowiednich dokumentów.
- Reranker: Ocenia wyszukane dokumenty według ich trafności.
- Model językowy: Łączy pobrane dane z zapytaniami użytkownika w jedną odpowiedź.
Zalety RAGA
- Dynamiczne aktualizacje wiedzy: Umożliwia wydajne dostarczanie informacji, a proces aktualizacji zostaje znacznie skrócony dzięki ponownemu szkoleniu modelu.
- Redukcja halucynacji: Dzięki odpowiedniemu uzasadnieniu reakcji na wiedzę zewnętrzną RAG minimalizuje nieścisłości faktyczne.
- Skalowalność: Można go z łatwością osadzić w dużych, zróżnicowanych zbiorach danych, co pozwala na wykorzystanie go do przydatnych, otwartych i dynamicznych zadań, takich jak obsługa klienta czy podsumowania wiadomości.
Ograniczenia RAG
- Opóźnienie: Nadmierna koncentracja na ekstrakcji informacji opóźnia czas uzyskania danych wyjściowych, co skutkuje większym opóźnieniem i czyni je nieistotnymi w środowiskach pracy w czasie rzeczywistym.
- Jakość bazy wiedzy: Niezawodność w wyszukiwaniu i trafności informacji pochodzących z zewnątrz staje się istotna, ponieważ odpowiedzi zależą wyłącznie od tych źródeł.
Dostrajanie – co to jest?
Dostrajanie to proces ponownego trenowania wstępnie wytrenowanego modelu LLM w określonym zestawie danych domenowych w celu przygotowania do wykonywania wyspecjalizowanych zadań, umożliwiający modelowi pełne zrozumienie niuansów wzorców istniejących w określonym kontekście.
Jak działa dostrajanie
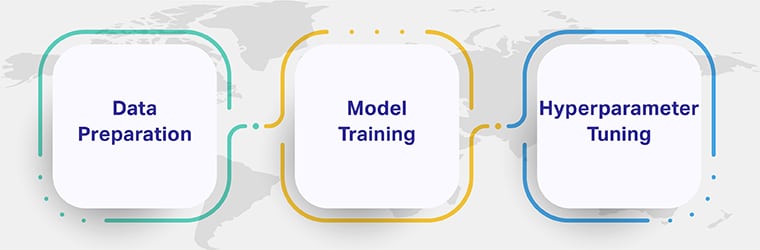
- Przygotowywanie danych: Zestawy danych specyficzne dla danego zadania będą musiały zostać oczyszczone i podzielone na podzbiory przeznaczone do szkolenia, walidacji i testowania.
- Trening modelowy: LLM będzie musiał trenować na tym zbiorze danych, stosując metody obejmujące propagację wsteczną i gradient spadkowy.
- Zawartość dostrajania hiperparametrów: Umożliwia precyzyjne dostrojenie kilku krytycznych elementów hiperparametrów, takich jak rozmiar partii, szybkość uczenia się i inne.
Zalety dostrajania precyzyjnego
- Dostosowywanie: Umożliwia kontrolę działań, tonu i stylu modelu w wynikach.
- Efektywność wnioskowania: Po dopracowaniu LLM uzyskuje się szybkie odpowiedzi bez konieczności korzystania z zewnętrznego procesu wyszukiwania.
- Specjalistyczne umiejętności: Najlepiej nadaje się do zastosowań wymagających jakości i dokładności w dobrze poznanych dziedzinach, takich jak zamrażanie, oceny medyczne i analiza umów.
Wady dostrajania
- Zasobochłonne: Wymaga zarówno dużej mocy obliczeniowej, jak i odpowiednio wysokiej jakości oznaczonych danych.
- Katastrofalne zapomnienie: Dopracowanie ma tendencję do nadpisywania wcześniej nabytej wiedzy ogólnej i tym samym ogranicza jej potencjał do radzenia sobie z nowymi zadaniami.
- Statyczna baza wiedzy: Po zakończeniu szkolenia wiedza pozostaje nienaruszona, chyba że zostanie powtórzona przy użyciu dodatkowych, nowych danych.
Kluczowe różnice między RAG a dostrajaniem precyzyjnym
| Cecha | Generacja rozszerzona o odzyskiwanie (SZMATA) | Strojenie |
|---|---|---|
| Źródło wiedzy | Bazy danych zewnętrzne (dynamiczne) | Zinternalizowane podczas treningu (statyczne) |
| Możliwość dostosowania do nowych danych | Wysoki; aktualizacje za pośrednictwem źródeł zewnętrznych | Niski; wymaga przekwalifikowania |
| Utajenie | Wyższe ze względu na kroki pobierania | Niski; generowanie odpowiedzi bezpośredniej |
| Personalizacja | Ograniczony; polega na danych zewnętrznych | Wysoki; dostosowany do konkretnych zadań |
| Skalowalność | Łatwe skalowanie przy dużych zestawach danych | Wymagające dużej ilości zasobów na dużą skalę |
| Przykłady użycia | Pytania i odpowiedzi w czasie rzeczywistym, sprawdzanie faktów | Analiza sentymentów, zadania specyficzne dla danej domeny |