Dzwonisz do banku o 21:00, aby zakwestionować opłatę. Odbiera głos, który za pierwszym razem rozumie problem, wyświetla transakcję, potwierdza Twoją tożsamość i rozwiązuje problem – bez muzyki w oczekiwaniu na połączenie, bez przelewu, bez „naciśnij 4, aby wrócić do menu głównego”. Ta interakcja to prawdziwy triumf sztucznej inteligencji.
Tak jest. Ale nie w sposób, w jaki większość ludzi zakłada. Ten model jest obecnie w dużej mierze powszechny. To, co sprawiło, że ta decyzja zadziałała, to tysiące godzin nagranych wypowiedzi osób mówiących tak jak ty, oznaczonych przez komentatorów, którzy zgodzili się co do znaczenia „kwestionowania zarzutu”, prześwietlonych pod kątem akcentów i fraz, które system faktycznie usłyszy, oraz tak regulowanych, aby żaden głos nie trafił do zestawu treningowego bez twojej zgody.
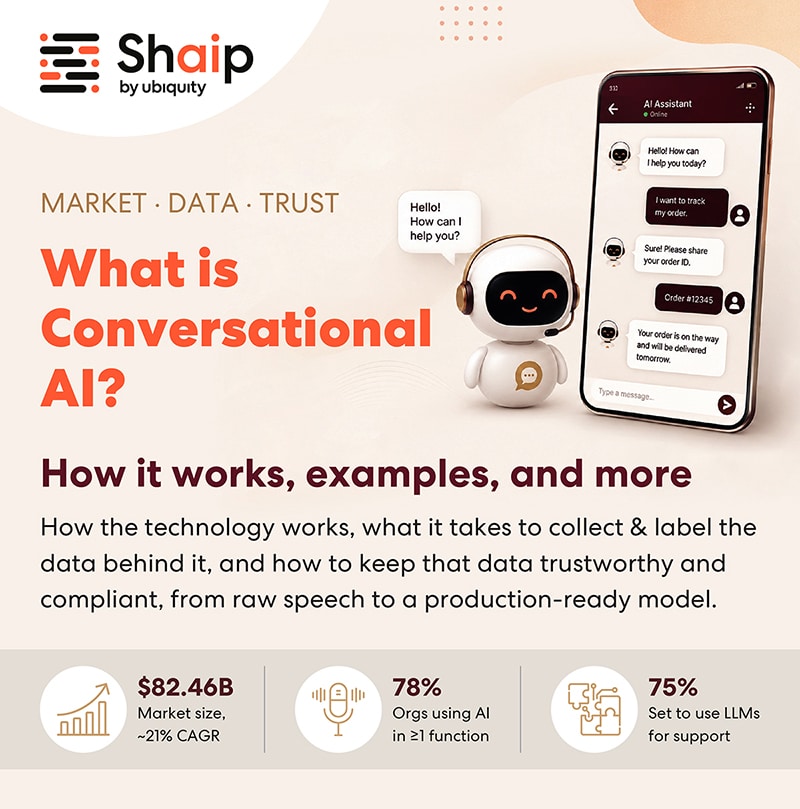
Oto prawdziwa historia sztucznej inteligencji konwersacyjnej w 2026 roku. Rynek zmierza w kierunku 82.46 mld dolarów przy średniorocznym tempie wzrostu (CAGR) wynoszącym około 21% , 78% organizacji wykorzystuje obecnie sztuczną inteligencję w co najmniej jednej funkcji biznesowej, a 75% planuje wdrożyć rozbudowane modele językowe do obsługi klienta. Technologia jest już ugruntowana. Wyróżnik przesunął się w dół stosu, do danych. Oto jak to wszystko się ze sobą łączy.
Czym właściwie jest sztuczna inteligencja konwersacyjna
Sztuczna inteligencja konwersacyjna to rodzina systemów — chatboty, wirtualni agenci, asystenci głosowi — które łączą rozpoznawanie mowy, rozumienie języka naturalnego i generowanie mowy, aby prowadzić naturalną, dwustronną rozmowę, a przy tym stają się coraz lepsze z każdym użyciem.
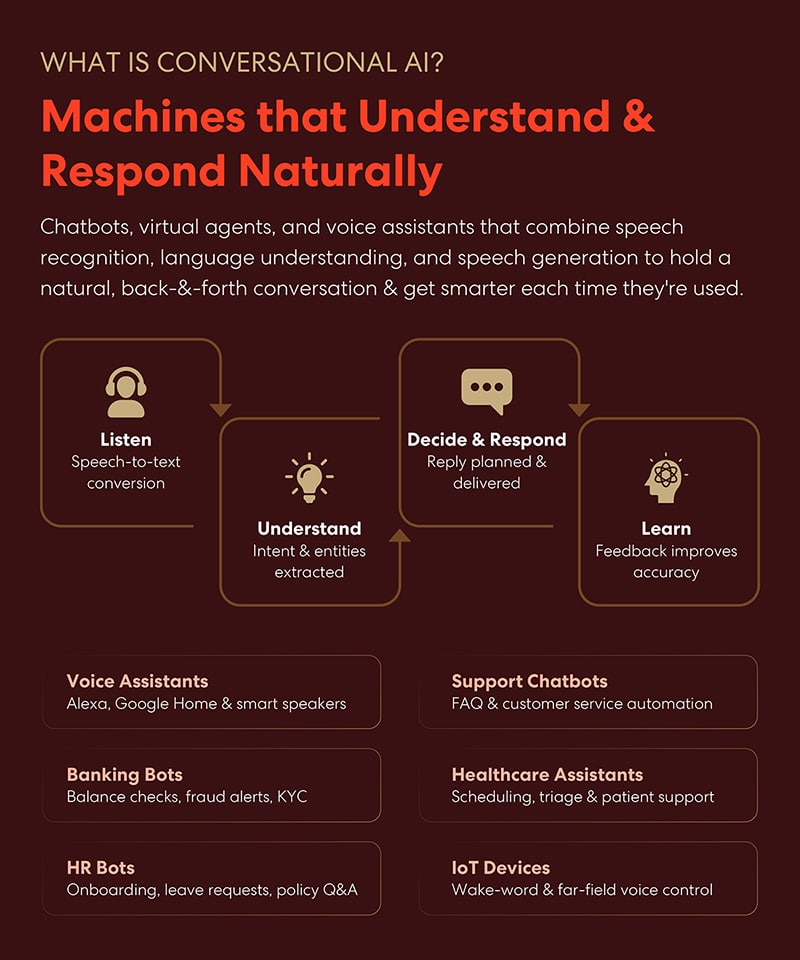
Pod spodem wszystkie one posiadają tę samą, czterostopniową pętlę.
- System słucha, zamiana mowy na tekst.
- It rozumie, wyodrębniając intencje i podmioty — to, czego chce użytkownik, oraz szczegółowe informacje związane z tym pragnieniem.
- It decyduje i odpowiada, zaplanowanie odpowiedzi i jej dostarczenie.
- I to uczy się, wykorzystując sygnały zwrotne w celu zwiększenia dokładności podczas następnego skrętu i dla następnego użytkownika.
Słuchaj → zrozum → podejmij decyzję → ucz się. Każdy produkt poniżej to inna domena owinięta wokół tej samej pętli.
- Asystenci głosowi podobnie jak Alexa i Google Home, obsługują one otwarte polecenia domowe za pomocą inteligentnych głośników.
- Wspieraj chatboty zautomatyzować obsługę FAQ i triaż obsługi klienta.
- Boty bankowe sprawdzanie salda, ostrzeganie o oszustwach i weryfikacja KYC.
- Asystenci służby zdrowia zarządzanie harmonogramem, triażem objawów i wsparciem pacjentów.
- Boty HR pytania dotyczące wdrażania pracowników w terenie, prośby urlopowe oraz pytania i odpowiedzi dotyczące polityki.
- oraz Urządzenia IoT opierają się na wykrywaniu słów wyzwalających i sterowaniu głosem z dużej odległości, gdzie mikrofon znajduje się po drugiej stronie pomieszczenia, a użytkownik nie patrzy na ekran.
Ten sam proces, radykalnie różne warunki awarii. Chatbot w handlu detalicznym, który błędnie odczytuje intencje, kosztuje konwersję. Asystent triażu w służbie zdrowia, który błędnie odczytuje intencje, to zdarzenie zagrażające bezpieczeństwu pacjenta. Ta różnica wynika z danych, a nie z architektury.
Jak surowa mowa staje się danymi treningowymi
Przejście od nagrania do gotowego do użycia w modelu zbioru danych wymaga dwóch odrębnych etapów: wyboru sposobu gromadzenia wypowiedzi, a następnie oznaczenia jej, aby model mógł się na niej uczyć. Zespoły, które traktują te kroki jako jeden krok, zazwyczaj uzyskują duży zbiór danych, który uczy niewłaściwych rzeczy.
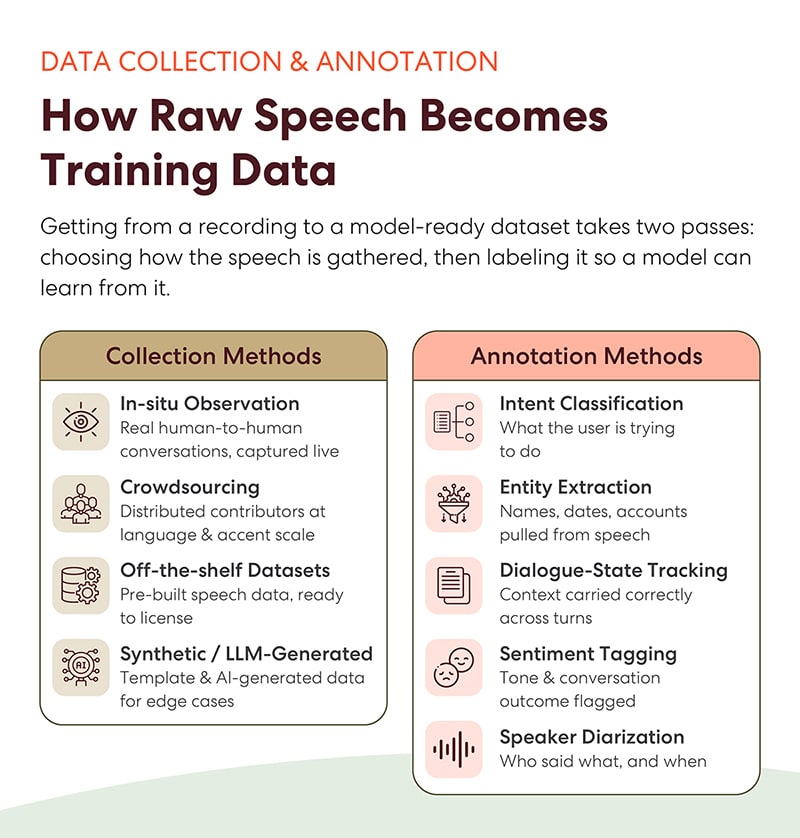
Jeśli chodzi o zbiórkę , cztery metody pokrywają większość potrzeb.
- Obserwacja in situ rejestruje na żywo prawdziwe rozmowy międzyludzkie — najwierniejszy dostępny sygnał, ale najtrudniejszy do uzyskania na dużą skalę.
- Crowdsourcing przekazuje nagrania osobom wybranym ze względu na język i akcent, dzięki czemu zasięg jest budowany w sposób przemyślany, a nie przypadkowy.
- Gotowe zbiory danych dostarczają wstępnie przygotowane, wstępnie oczyszczone dane głosowe gotowe do licencjonowania, skracając czas realizacji o kilka miesięcy, gdy domena jest sensownie dopasowana.
- oraz syntetyczne lub wygenerowane przez LLM dane wypełniają konkretne luki — oparte na szablonach i generowane przez sztuczną inteligencję wypowiedzi dotyczące skrajnych przypadków, na które nie warto czekać.
Po stronie adnotacji pięć warstw etykiet zamienia dźwięk w nadzór.
- Klasyfikacja intencji oznacza to, co użytkownik próbuje zrobić.
- Ekstrakcja podmiotu wyciąga z przemówienia nazwiska, daty i numery kont.
- Śledzenie stanu dialogu przenosi kontekst między turami, dzięki czemu system wie, że „druga” odnosi się do czegoś wspomnianego cztery tury temu.
- Tagowanie sentymentów ton flagi i wynik rozmowy.
- oraz diaryzacja mówcy ustala, kto, co i kiedy powiedział — nie podlega negocjacjom w przypadku nagrywania rozmów wieloosobowych, a co za tym idzie, w przypadku większości rzeczywistych danych rozmów.
Zbierz → transkrybuj → etykietuj intencje i encje → śledź stan → zapisuj w dzienniku → waliduj. Pomiń warstwę, a otrzymasz model, który transkrybuje płynnie i nic nie rozumie.
Czym właściwie mierzy się „dobre dane”
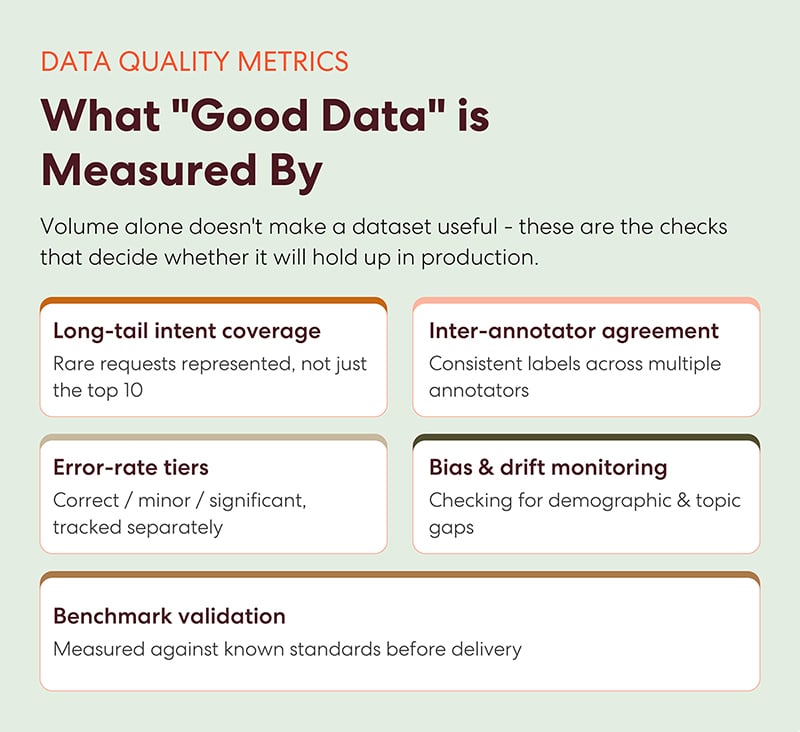
Sama objętość nie czyni zbioru danych użytecznym. Pięć kontroli decyduje o tym, czy zbiór danych sprawdzi się w środowisku produkcyjnym, i warto o nie zapytać bezpośrednio każdego dostawcę.
- Pokrycie intencji długiego ogona pyta, czy reprezentowane są rzadkie żądania, a nie tylko dziesięć najczęstszych. Większość zbiorów danych jest zdominowana przez garstkę intencji, z którymi użytkownicy korzystają regularnie — a większość awarii produkcyjnych ma miejsce w ogonie.
- Umowa między adnotatorami mierzy, czy wielu adnotatorów oznacza tę samą wypowiedź w ten sam sposób; niski poziom zgodności oznacza, że etykiety wyrażają raczej zamieszanie niż prawdę.
- Poziomy współczynnika błędów oddzielić błędy poprawne od drobnych i istotnych oraz śledzić je niezależnie, ponieważ 3% wskaźnik błędów składający się z katastrofalnych błędnych klasyfikacji nie jest tym samym produktem, co 3% wskaźnik błędów trywialnych.
- Monitorowanie odchyleń i dryftu sprawdza luki demograficzne i tematyczne i obserwuje je w czasie, gdy zmieniają się zachowania użytkowników i język.
- oraz walidacja porównawcza dokonuje pomiarów zbioru danych względem znanych standardów przed jego dostarczeniem, dzięki czemu jakość jest sprawdzona zanim stanie się problemem.
Te pięć elementów stanowi różnicę między zbiorem danych, który można wdrożyć, a zbiorem danych, który trzeba utworzyć ponownie.
Zaufanie jest wbudowane w warstwę danych, a nie do niej przykręcone
Dane dotyczące mowy zawierają głos i słowa danej osoby – dwie z jej najbardziej charakterystycznych cech. Zarządzanie musi być zaprojektowane od samego początku gromadzenia danych, ponieważ nie ma możliwości wstecznego dodania zgody do nagrania, na którym już się wyszkoliłeś.
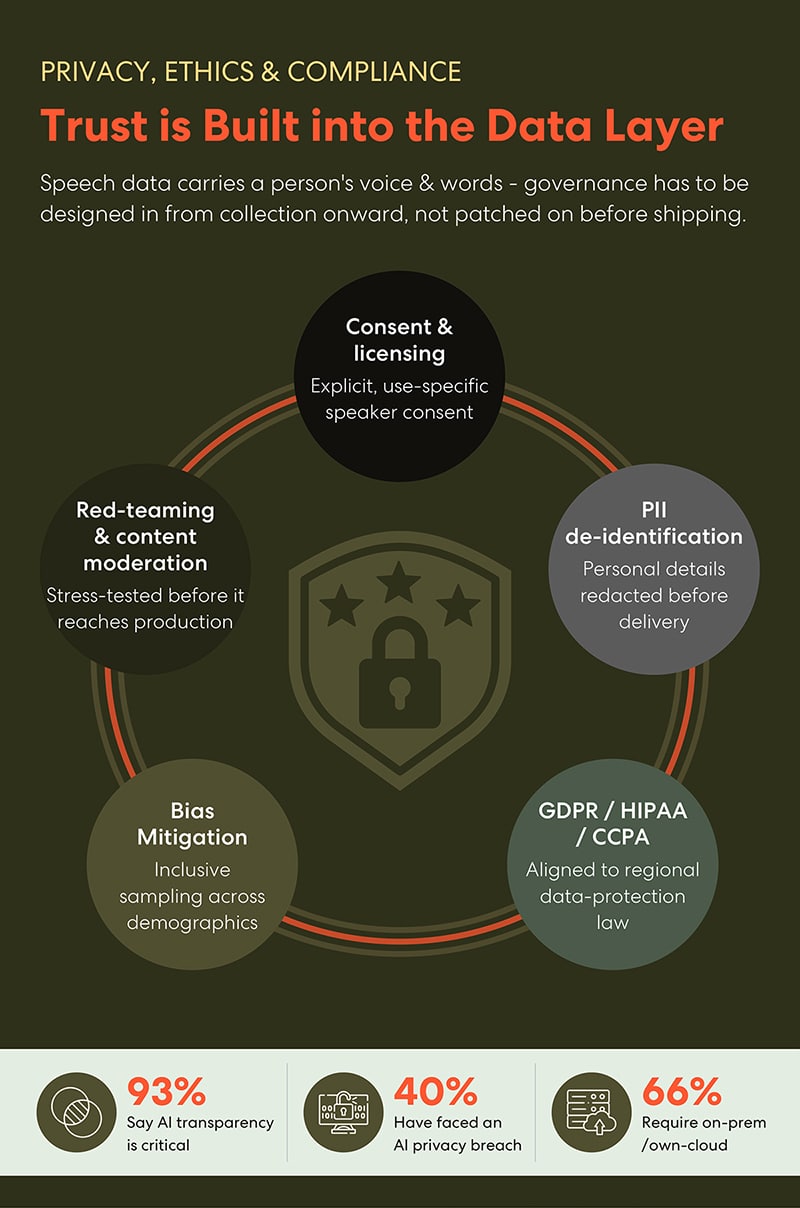
Pięć elementów sterujących definiuje warstwę danych, którą można obronić.
- Zgoda i licencja oznacza wyraźną zgodę mówiącego dotyczącą konkretnego zastosowania — nie ogólną klauzulę warunków korzystania z usługi.
- Anonimizacja danych osobowych usuwa dane osobowe przed dostawą, a nie po incydencie.
- Zgodność z RODO, HIPAA i CCPA mapuje potok do regionalnego prawa o ochronie danych, które faktycznie ma zastosowanie do wdrożenia.
- Łagodzenie uprzedzeń wprowadza inkluzywne pobieranie próbek z różnych grup demograficznych do planu zbierania danych, gdzie nie kosztuje to nic, a nie do działań naprawczych, gdzie kosztuje wszystko.
- oraz red-teaming i moderacja treści przeprowadza testy obciążeniowe systemu przed udostępnieniem go użytkownikom produkcyjnym.
Rynek to uwzględnił. 93% organizacji twierdzi, że transparentność sztucznej inteligencji (AI) jest kluczowa, 40% doświadczyło już naruszenia prywatności AI, a 66% wymaga obecnie wdrożenia lokalnego lub w chmurze. Klienci pytają, skąd pochodzą dane — i coraz częściej chcą uzyskać odpowiedź w umowie.
Gdzie pojawia się sztuczna inteligencja konwersacyjna
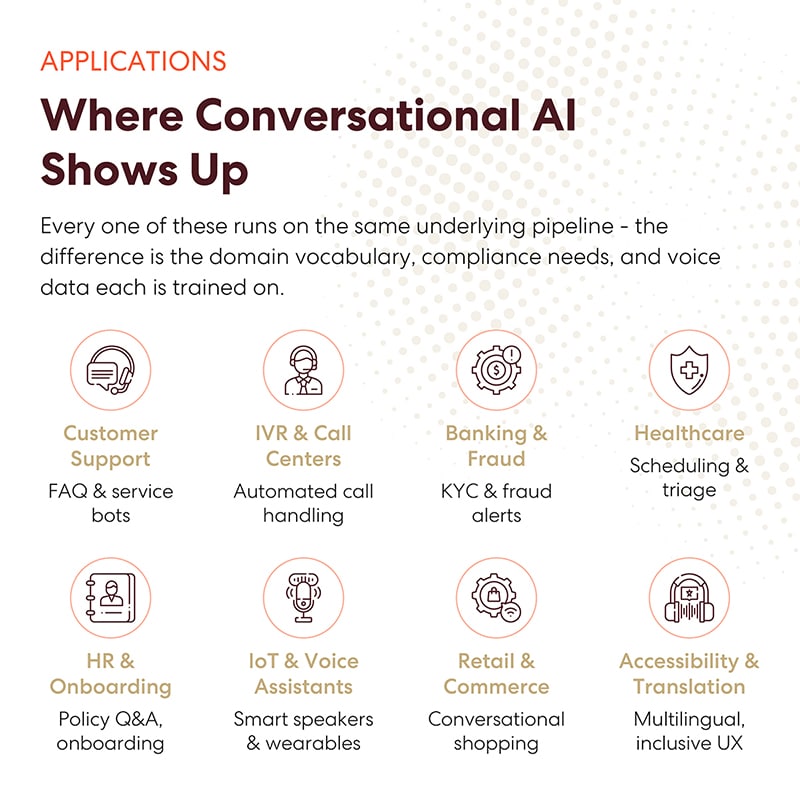
Osiem obszarów zastosowań odpowiada za większość wdrożeń w przedsiębiorstwach.
- Obsługa klienta obsługuje FAQ i boty serwisowe.
- Systemy IVR i centra telefonicznej obsługi klienta automatyzują obsługę i kierowanie połączeń.
- Bankowość i oszustwa obejmuje weryfikację KYC i ostrzeganie o oszustwach.
- Zdrowie zajmuje się planowaniem i selekcją.
- HR i onboarding zarządza pytaniami i odpowiedziami dotyczącymi polityki oraz przepływem pracy nowo zatrudnionych osób.
- IoT i asystenci głosowi zasilać inteligentne głośniki i urządzenia noszone.
- Handel detaliczny i handel umożliwia zakupy konwersacyjne.
- oraz dostępność i tłumaczenie zapewnia wielojęzyczne, kompleksowe środowisko użytkownika osobom, których standardowy interfejs nie obejmuje.
Każdy z nich działa w ramach tego samego, bazowego procesu. Różnią się one słownictwem domenowym, wymaganiami dotyczącymi zgodności oraz danymi głosowymi, na których trenowany jest każdy z nich. Ta ostatnia zmienna to ta, w którą zespoły inwestują za mało i która decyduje o tym, czy wdrożenie będzie działać poza wersją demonstracyjną.
Lepsza sztuczna inteligencja konwersacyjna zaczyna się od lepszych danych
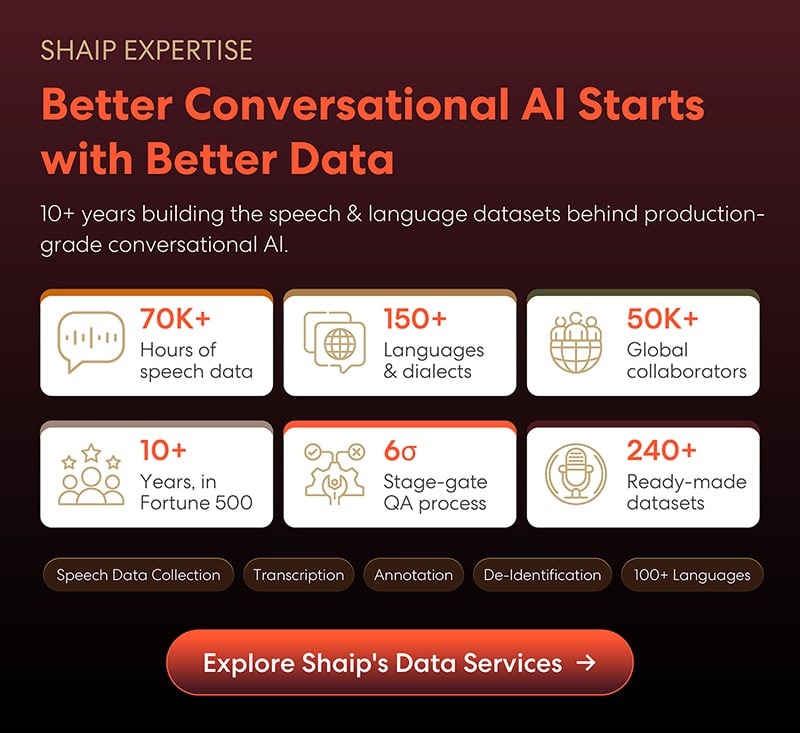
Zamknięcie luki między działającym prototypem a asystentem produkcyjnym to problem związany z operacjami na danych i to właśnie nad nim Shaip spędził ponad dekadę:
- Ponad 70 tys. godzin danych mowy,
- Ponad 150 języków i dialektów,
- Ponad 50 tys. globalnych współpracowników,
- 10 + lata obsługując zespoły ds. sztucznej inteligencji z listy Fortune 500,
- a proces zapewnienia jakości Six Sigma Stage-Gate,
- Ponad 240 gotowych zestawów danych dostępne od ręki, gdy terminy nie pozwalają na odbiór towaru od podstaw.
Podczas gromadzenia danych mowy, transkrypcji, adnotacji i anonimizacji, cel jest ten sam: dane szkoleniowe odzwierciedlające ludzi, do których Twój produkt będzie faktycznie przekazywał informacje, wraz ze śladem zgód i metrykami jakości, które to potwierdzą.
Bottom Line
Sztuczna inteligencja konwersacyjna przestała być kwestią technologii. Pętla jest dobrze zrozumiana, modele są powszechnie dostępne, a aplikacje są elementami budżetów w każdej branży. Prawdziwym wyzwaniem pozostaje warstwa danych – zasięg long tail, zgoda na etykietę, równowaga demograficzna, zgody i anonimizacja.
W tym właśnie tkwi przewaga. Dwa zespoły korzystające z tego samego modelu dostarczą produkty o bardzo różnej jakości, a różnica będzie wynikać z tego, na czym trenowano ich systemy. Jeśli tworzysz konwersacyjną sztuczną inteligencję, najważniejsze decyzje, jakie podejmiesz, nie będą dotyczyły architektury. Dotyczą one tego, czyje głosy znajdują się w zbiorze danych, jak dobrze są one oznaczone i czy miałeś prawo ich użyć.