Prawdopodobnie znasz taką sytuację: asystent głosowy doskonale rozumie Twojego znajomego, ale ma problem z Twoim akcentem lub sposobem mówienia Twoich rodziców.
Ten sam język. To samo żądanie. Zupełnie różne rezultaty.
Właśnie w tej luce kryje się socjofonetyka — i to właśnie dlatego nagle ma ona tak duże znaczenie dla sztucznej inteligencji.
Socjofonetyka bada interakcje między czynnikami społecznymi a dźwiękami mowy . Połączenie tego z technologią mowy staje się skutecznym narzędziem do tworzenia bardziej sprawiedliwych i niezawodnych systemów ASR, TTS i asystentów głosowych.
W tym artykule wyjaśnimy socjofonetykę prostym językiem, a następnie pokażemy, jak może ona zmienić sposób projektowania danych mowy, trenowania modeli i oceny wydajności.
1. Od lingwistyki do sztucznej inteligencji: dlaczego socjofonetyka nagle nabrała znaczenia
Przez dziesięciolecia socjofonetyka była głównie zagadnieniem akademickim. Naukowcy wykorzystywali ją do badania takich zagadnień jak:
- Jak różne grupy społeczne wymawiają „te same” dźwięki?
- W jaki sposób słuchacze wychwytują sygnały społeczne — wiek, region, tożsamość — na podstawie drobnych różnic w wymowie?
Teraz sztuczna inteligencja wniosła te pytania na spotkania produktowe.
Nowoczesne systemy mowy są wdrażane dla milionów użytkowników w różnych krajach, dialektach i środowiskach społecznych. Za każdym razem, gdy model ma problemy z konkretnym akcentem, grupą wiekową lub społecznością, nie jest to zwykły błąd — to socjofonetyczna niezgodność między sposobem mówienia ludzi a tym, czego model od nich oczekuje.
Dlatego zespoły pracujące nad ASR, TTS i UX głosowe zaczynają pytać:
„Jak możemy mieć pewność, że nasze szkolenia i ocena rzeczywiście odzwierciedlają osoby, którym chcemy służyć?”
2. Czym jest socjofonetyka? (Definicja w języku potocznym)
Formalnie rzecz biorąc, socjofonetyka jest działem językoznawstwa łączącym socjolingwistykę (badanie różnic językowych w różnych grupach społecznych) i fonetykę (naukę o dźwiękach mowy).
W praktyce zadaje takie pytania jak:
- Jaki wpływ na wymowę mają wiek, płeć, region, przynależność etniczna i klasa społeczna?
- W jaki sposób słuchacze wykorzystują subtelne różnice w dźwiękach, aby rozpoznać, skąd pochodzi dana osoba lub jak ona sama siebie postrzega?
- Jak wzorce te zmieniają się z czasem, wraz z przemianami społeczności i tożsamości?
Można to sobie wyobrazić w ten sposób: jeśli fonetyka jest kamerą rejestrującą dźwięki mowy, to socjofonetyka jest dokumentem pokazującym, jak prawdziwi ludzie używają tych dźwięków, aby sygnalizować tożsamość, przynależność i emocje.
Kilka konkretnych przykładów:
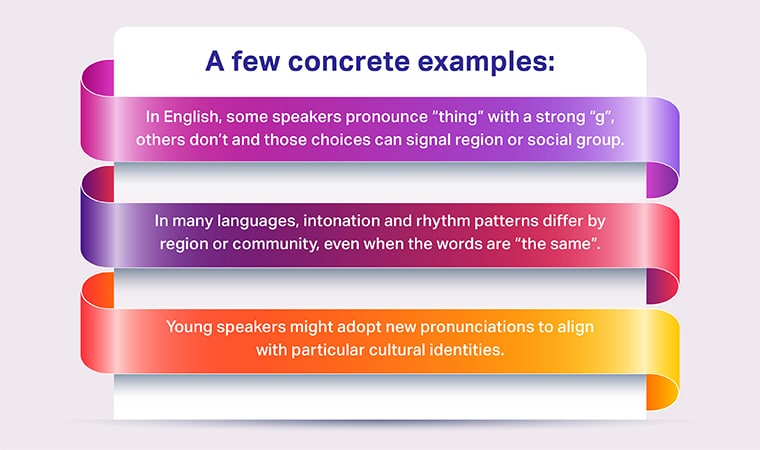
- W języku angielskim niektórzy użytkownicy wymawiają słowo „thing” z mocnym „g”, inni nie — a te wybory mogą sygnalizować region lub grupę społeczną.
- W wielu językach intonacja i rytm różnią się w zależności od regionu lub społeczności, nawet jeśli słowa są „takie same”.
- Młodzi użytkownicy języka mogą przyjmować nową wymowę, dostosowaną do określonej tożsamości kulturowej.
Socjofonetyka bada szczegółowo te wzorce — często za pomocą pomiarów akustycznych, testów percepcji i dużych korpusów — aby zrozumieć, w jaki sposób znaczenia społeczne są kodowane w dźwięku.
Przystępne wprowadzenie można znaleźć w wyjaśnieniu na stronie sociophonetics.com.
3. Jak socjofonetyka bada zmienność mowy
Badania socjofonetyczne zwykle koncentrują się na dwóch szerokich obszarach:
- Produkcja – jak ludzie faktycznie wytwarzają dźwięki.
- Postrzeganie – w jaki sposób słuchacze interpretują te dźwięki i niesione przez nie sygnały społeczne.
Niektóre z kluczowych składników:
- Cechy segmentowe: samogłoski i spółgłoski (na przykład, jak /r/ lub pewne samogłoski różnią się w zależności od regionu).
- Suprasegmentale (prozodia): rytm, akcent i wzorce intonacji.
- Jakość głosu: oddech, skrzypienie i inne cechy, które mogą mieć znaczenie społeczne.
Metodologicznie praca socjofonetyczna wykorzystuje:
- Analiza akustyczna (pomiar formantów, wysokości dźwięku, tempa).
- Eksperymenty percepcyjne (w jaki sposób słuchacze kategoryzują lub oceniają próbki mowy).
- Wywiady socjolingwistyczne i korpusy (duże zbiory danych prawdziwych konwersacji, z uwzględnieniem czynników społecznych).
Najważniejszym wnioskiem jest to, że zmienność nie jest „szumem” — jest ustrukturyzowana, znacząca i społecznie wzorcowana.
Właśnie dlatego sztuczna inteligencja nie może tego ignorować.
4. Gdzie socjofonetyka spotyka się ze sztuczną inteligencją i technologią mowy
Technologie mowy — ASR, TTS, boty głosowe — opierają się na danych dotyczących mowy . Jeśli dane te nie uwzględniają zmienności socjofonetycznej, modele nieuchronnie będą częściej zawodzić w przypadku niektórych grup.
Badania nad akcentowanym ASR pokazują, że:
- W przypadku niektórych akcentów i dialektów wskaźnik błędów może być znacznie wyższy.
- Mowa akcentowana przy ograniczonej ilości danych szkoleniowych jest szczególnie trudna.
- Uogólnianie na różne dialekty wymaga bogatych, zróżnicowanych zbiorów danych i starannej oceny.
Z punktu widzenia socjofonetycznego do typowych trybów awarii zalicza się:
- Błąd akcentu: System działa najlepiej w przypadku akcentów „standardowych” lub dobrze reprezentowanych.
- Niedostateczne rozpoznanie form lokalnych: wymowa regionalna, przesunięcia samogłosek i wzorce prozodii są błędnie rozpoznawane.
- Nierówne UX: Niektórzy użytkownicy uważają, że system „nie został stworzony dla ludzi takich jak ja”.
Socjofonetyka pomaga w nazywaniu i mierzeniu tych problemów. Daje zespołom AI słownik tego, czego brakuje w ich danych i metrykach.
5. Projektowanie danych mowy z wykorzystaniem soczewki socjofonetycznej
Większość organizacji już myśli o pokryciu językowym („Obsługujemy angielski, hiszpański, hindi…”). Socjofonetyka zachęca do głębszego poznania:
5.1 Zmapuj swój socjofonetyczny „wszechświat”
Zacznij od wypisania:
- Rynki docelowe i regiony (na przykład USA, Wielka Brytania, Indie, Nigeria).
- Klawisz odmiany w obrębie każdego języka (dialekty regionalne, etnolekty, socjolekt).
- Istotne segmenty użytkowników: przedziały wiekowe, różnorodność płci, obszary wiejskie/miejskie, domeny zawodowe.
To jest twój socjofonetyczny wszechświat — przestrzeń głosów, którym ma służyć twój system.
5.2 Zbierz wypowiedzi odzwierciedlające ten wszechświat
Gdy już poznasz swoją przestrzeń docelową, możesz zaprojektować wokół niej zbiór danych:
- Rekrutuj mówców w całym regiony, grupy wiekowe, płcie i społeczności.
- Nagrywanie wielu kanałów (telefon komórkowy, mikrofony dalekiego zasięgu, telefonia).
- Uwzględnij oba czytać mowa i naturalny rozmowa, aby ujawnić rzeczywiste różnice w tempie, rytmie i stylu.
Zbiory danych dotyczących mowy i dźwięku oraz usługi gromadzenia danych dotyczących mowy firmy Shaip zostały stworzone właśnie w tym celu — obejmując dialekty, tony i akcenty w ponad 150 językach.
5.3 Adnotuj metadane socjofonetyczne, a nie tylko słowa
Sam zapis transkrypcji nie mówi nic o tym, kto mówi, ani jak brzmi.
Aby Twoje dane były świadome socjofonetyki, możesz dodać:
- Metadane na poziomie mówcy: region, akcent, język dominujący, grupa wiekowa.
- Etykiety na poziomie wypowiedzi: styl mowy (swobodny lub formalny), kanał, szum tła.
- Do zadań specjalistycznych wąskie petykiety uczciwe lub adnotacje prozodyczne.
Metadane te umożliwiają późniejszą analizę wydajności według wycinków społecznych i fonetycznych , a nie tylko zbiorczo.
6. Socjofonetyka i ocena modelu: poza pojedynczym WER
Większość zespołów podaje jeden WER (wskaźnik błędów słownych) lub MOS (średni wynik opinii) dla każdego języka. Socjofonetyka podpowiada, że to za mało.
Musisz zapytać:
- Jak zmienia się WER według akcentu?
- Czy pewne grupy wiekowe lub regiony są konsekwentnie w gorszej sytuacji?
- Czy dla niektórych głosów TTS brzmi „bardziej naturalnie” niż dla innych?
Badanie ASR przeprowadzone z użyciem akcentów pokazuje, jak bardzo wyniki mogą się różnić w zależności od dialektu i akcentu — nawet w obrębie jednego języka.
Prosta, ale skuteczna zmiana polega na:
- Buduj zestawy testowe podzielone według akcentu, regionu i kluczowych danych demograficznych.
- Raportuj metryki według akcentu oraz na grupę socjofonetyczną.
- Duże różnice traktuj jako poważne błędy w produkcie, a nie tylko ciekawostki techniczne.
Nagle socjofonetyka nie jest już tylko teorią — jest obecna w twoich pulpitach.
Aby dokładniej przyjrzeć się planowaniu i ocenie danych rozpoznawania mowy, przewodnik Shaipa dotyczący danych szkoleniowych do rozpoznawania mowy pokazuje, jak projektować zestawy danych i podziały oceny odzwierciedlające rzeczywistych użytkowników.
7. Studium przypadku: korygowanie błędu akcentu za pomocą lepszych danych
Firma fintech wprowadza na rynek anglojęzycznego asystenta głosowego. W testach użytkowników wszystko wygląda dobrze. Po uruchomieniu, w jednym regionie gwałtownie wzrosła liczba zgłoszeń do pomocy technicznej. Zespół, analizując sprawę, odkrył:
- Użytkownicy posługujący się akcentem danego regionu odnotowują znacznie wyższy wskaźnik błędów.
- ASR ma problemy z systemem samogłosek i rytmem, co prowadzi do błędnego rozpoznawania numerów kont i poleceń.
- W zestawie szkoleniowym znalazło się bardzo niewielu mówców z tego regionu.
Z punktu widzenia socjofonetyki nie jest to wcale zaskakujące: od modelki nigdy nie żądano nauki tego akcentu.
Oto jak zespół rozwiązał ten problem:
Rezultat: mierzalny spadek liczby błędów w danym regionie, lepsze wyniki zadowolenia użytkowników i wyraźniejsze wewnętrzne zrozumienie, że pokrycie socjofonetyczne jest wymaganiem produktu , a nie czymś fajnym.
8. W jaki sposób Shaip pomaga w operacjonalizacji socjofonetyki
Aby przełożyć spostrzeżenia socjofonetyczne na systemy produkcyjne, potrzebne są trzy rzeczy:
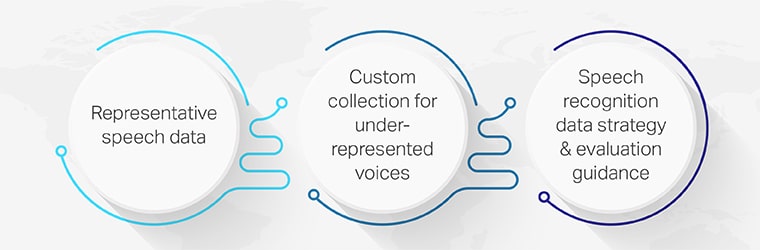
- Dane dotyczące reprezentatywnej mowy:Shaip oferuje na dużą skalę zestawy danych mowy i dźwięku które już obejmują mieszankę języków, dialektów i warunków nagrywania — mocny punkt wyjścia dla szerokości socjofonetycznej.
- Kolekcja niestandardowa dla głosów niedostatecznie reprezentowanych: W przypadku akcentów, socjolektów lub społeczności, których brakuje w gotowych danych, Shaip usługi gromadzenia danych mowy potrafi rekrutować i nagrywać odpowiednich mówców, kanały i scenariusze — na skalę, jakiej potrzebują Twoje modele.
- Strategia i wskazówki dotyczące oceny danych dotyczących rozpoznawania mowy: Przewodniki takie jak Shaip wybór zestawu danych rozpoznawania mowy a podręczniki danych szkoleniowych pomagają zespołom planować zestawy danych i zestawy testowe, które odzwierciedlają rzeczywistą zmienność socjofonetyczną, a nie tylko etykiety językowe.
Łącząc socjofonetykę z tego rodzaju infrastrukturą danych i ocen , przechodzimy od:
„Wspieramy język angielski” do:
„Wspieramy język angielski w formie, w jakiej faktycznie posługują się nim nasi użytkownicy — niezależnie od regionu, akcentu i społeczności — i możemy to udowodnić w naszych statystykach”.