Dlaczego neutralność danych jest ważniejsza niż kiedykolwiek w przypadku danych szkoleniowych AI
Jeśli sztuczna inteligencja jest silnikiem Twojego biznesu, dane szkoleniowe są paliwem.
Ale oto niewygodna prawda: to, kto kontroluje to paliwo – i jak je wykorzystuje – ma teraz równie duże znaczenie, co jakość samych danych. Właśnie na tym polega idea neutralności danych .
W ciągu ostatnich kilku lat, duże przejęcia w sektorze technologicznym, partnerstwa w modelu fundacyjnym i nowe regulacje sprawiły, że neutralność danych z niszowej koncepcji stała się priorytetowym problemem biznesowym i zgodności. Neutralne, wysokiej jakości dane szkoleniowe nie są już tylko „miłym dodatkiem” – są kluczowe dla ochrony własności intelektualnej, unikania stronniczości i utrzymania po swojej stronie regulatorów (i klientów).
W tym artykule wyjaśnimy, co w praktyce oznacza neutralność danych, dlaczego jest ważniejsza niż kiedykolwiek i jak ocenić, czy partner dostarczający dane do treningu sztucznej inteligencji jest naprawdę neutralny.
Co właściwie rozumiemy pod pojęciem „neutralności danych” w kontekście sztucznej inteligencji?
Pomińmy prawniczy żargon i mówmy wprost.
Neutralność danych w sztucznej inteligencji opiera się na założeniu, że dane treningowe są:
Zbierane i zarządzane niezależnie interesów Twoich konkurentów
Używane wyłącznie w sposób, na który wyrażasz zgodę (brak „tajemniczego ponownego wykorzystania” między klientami)
Kierując się przejrzystymi zasadami wokół uprzedzeń, dostępu i własności
Zabezpieczony przed konfliktami interesów w sposobie pozyskiwania, opisywania i przechowywania
Można porównać dane treningowe sztucznej inteligencji do zasobów wodnych miasta.
Gdyby jedna prywatna firma była właścicielem wszystkich rur i jednocześnie prowadziła konkurencyjny biznes, który zużywa dużo wody, martwiłbyś się o to, jak czyste, uczciwe i niezawodne są te dostawy. Neutralność polega na upewnieniu się, że Twoja sztuczna inteligencja nie uzależni się od źródła danych kontrolowanego przez kogoś, czyje motywacje nie do końca pokrywają się z Twoimi.
W przypadku danych szkoleniowych sztucznej inteligencji neutralność obejmuje:
Sprawiedliwość i stronniczość – Czy niektóre grupy lub perspektywy są systematycznie niedoreprezentowane?
Niezależność – Czy Twój dostawca również tworzy własne modele konkurencyjne?
Suwerenność danych – Kto ostatecznie kontroluje, gdzie przechowywane są Twoje dane i w jaki sposób mogą być ponownie wykorzystane?
Ochrona IP – Czy Twoje ciężko zdobyte spostrzeżenia mogą przedostać się do czyjegoś modelu?
Neutralność danych to dyscyplina polegająca na odpowiadaniu „tak, jesteśmy chronieni” na wszystkie te pytania – i umiejętności udowodnienia tego.
Dlaczego neutralność danych stała się rzeczywistością
Kilka lat temu „neutralne dane treningowe” brzmiały jak filozoficzny, przyjemny dodatek. Dziś to temat rozmów w sali konferencyjnej.
Konsolidacja rynku i uzależnienie od dostawcy
Ostatnie działania – takie jak zacieśnianie współpracy hiperskalowych firm z dostawcami danych i duże udziały w platformach danych szkoleniowych – zmieniły profil ryzyka dla każdej firmy, która zleca na zewnątrz gromadzenie i adnotację danych.
Jeśli Twój główny dostawca danych szkoleniowych jest obecnie częściowo własnością dużej firmy technologicznej, która:
Konkuruje z Tobą bezpośrednio lub
Czy budowanie modeli w Twojej domenie,
Następnie musisz zadać trudne pytania:
Czy moje dane, nawet w formie zbiorczej, zostaną wykorzystane do udoskonalenia modeli moich konkurentów?
Czy otrzymam ten sam priorytet i jakość, jeśli mój plan działania będzie kolidował z ich planem?
Jak łatwo jest się wyprowadzić, gdy coś się zmienia?
Regulacja i oczekiwania konsumentów
Organy regulacyjne nadrabiają zaległości. Artykuł 10 unijnej ustawy o sztucznej inteligencji wyraźnie wymaga wysokiej jakości zbiorów danych, które są istotne, reprezentatywne i odpowiednio zarządzane w przypadku systemów sztucznej inteligencji wysokiego ryzyka.
Jednocześnie badania pokazują, że zdecydowana większość amerykańskich konsumentów oczekuje przejrzystości w kwestii tego, w jaki sposób marki pozyskują dane dla modeli AI , i chętniej ufają organizacjom, które potrafią to jasno wyjaśnić.
Innymi słowy, poprzeczka się podnosi. Zasada „kupiliśmy trochę danych i rzuciliśmy je na model” nie jest już akceptowana przez organy regulacyjne, klientów ani zespół odpowiedzialny za własne ryzyko.
Krótka (hipotetyczna) historia
Wyobraź sobie, że jesteś liderem CX w szybko rozwijającej się firmie SaaS. Zlecasz zbieranie danych szkoleniowych i adnotacje dla swojego drugiego pilota ds. obsługi klienta znanemu dostawcy.
Sześć miesięcy później ten dostawca został przejęty przez dużą firmę technologiczną, która wprowadzała na rynek konkurencyjny produkt CX. Niektórzy członkowie zarządu pytają, czy dane szkoleniowe – zwłaszcza przypadki skrajne i wrażliwe informacje zwrotne – mogą ostatecznie posłużyć do opracowania ich modelu.
Twoje zespoły prawne i ds. zgodności zaczynają analizować umowy, umowy o ochronie danych i procesy wewnętrzne. Nagle sztuczna inteligencja nie jest już tylko historią innowacji, ale historią zarządzania i zaufania.
Oto co się dzieje, gdy neutralność danych nie jest kryterium wyboru od samego początku.
Jak neutralność danych wpływa na jakość danych szkoleniowych AI
Neutralność nie jest kwestią wyłącznie polityki i własności – jest ściśle powiązana z jakością danych i wydajnością modeli.
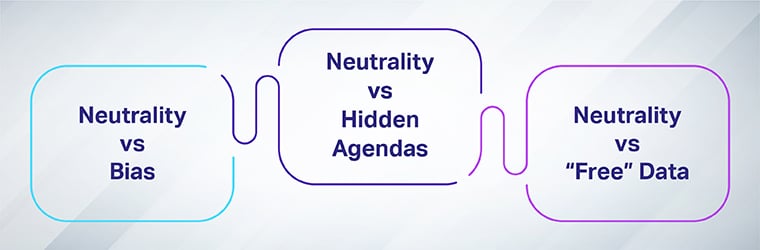
Neutralność kontra stronniczość: różnorodność w założeniu
Neutralni partnerzy chętniej będą traktować zróżnicowane, reprezentatywne dane szkoleniowe jako priorytet , ponieważ ich model biznesowy opiera się na byciu zaufanym, bezstronnym dostawcą, a nie na forsowaniu konkretnego programu.
Neutralność kontra ukryte motywy: Kto jest właścicielem rurociągu?
Jeśli Twój dostawca danych tworzy również konkurencyjne produkty, zawsze istnieje ryzyko – choćby pozorne – że:
Twoje najtrudniejsze przypadki brzegowe stają się „złotym materiałem treningowym” dla konkurencyjnego modelu.
Twoja wiedza specjalistyczna w danej dziedzinie wpływa na ich plan działania.
Alokacja zasobów faworyzuje projekty wewnętrzne, nie zapewniając terminów realizacji.
Naprawdę neutralny dostawca danych szkoleniowych dla sztucznej inteligencji ma jedno zadanie: pomóc Ci budować lepsze modele, a nie siebie.
Neutralność kontra „darmowe” dane: oprogramowanie typu open source ≠ neutralne
Otwarte lub zeskrobane zbiory danych mogą wydawać się kuszące: szybkie, tanie, obfite. Często jednak oferują:
Pytania dotyczące licencji i niejasności prawne
Nierównomierne rozkłady wzmacniające istniejące struktury władzy
Ograniczona dokumentacja dotycząca sposobu gromadzenia danych
Wiele analiz podkreśla obecnie ukryte zagrożenia związane z danymi udostępnianymi w otwartych źródłach – od narażenia prawnego po stronniczość systemową.
Neutralność w tym przypadku oznacza uczciwe podejście do sytuacji, w których „darmowe” dane mają sens, a w jakich sytuacjach potrzebne są starannie wyselekcjonowane, etycznie pozyskiwane, wysokiej jakości dane szkoleniowe dla sztucznej inteligencji.
Kluczowe zasady neutralności danych w danych szkoleniowych AI
Na co więc właściwie powinieneś zwrócić uwagę?
Niezależność i brak konkurencji
Neutralny dostawca:
Nie twórz produktów bazowych, które bezpośrednio konkurują z Twoją sztuczną inteligencją.
Posiada jasną politykę wewnętrzną dotyczącą oddzielania danych klientów.
Jest transparentny w kwestii inwestorów, partnerstw i interesów strategicznych.
Podobnie jest z wyborem niezależnego audytora – chcesz kogoś, kto kieruje się względami zaufania i dokładności, a nie rozwojem Twojej konkurencji.
Etyczne, zgodne z przepisami, dbające o prywatność pozyskiwanie
Biorąc pod uwagę przepisy takie jak unijna ustawa o sztucznej inteligencji, RODO oraz przepisy sektorowe, neutralność danych musi opierać się na solidnej ochronie danych i zarządzaniu nimi.
Udokumentowana zgoda i metody zbierania danych
Silna anonimizacja w razie potrzeby
Jasne zasady przechowywania i usuwania danych
Możliwość audytu śladów przepływu danych w kanale
W tym miejscu etyczne dane szkoleniowe sztucznej inteligencji w dużym stopniu pokrywają się z neutralnością: nie możesz twierdzić, że jesteś neutralny, jeśli źródła, z których korzystasz, są nieprzejrzyste lub mają charakter wyzyskujący.
Jakość, różnorodność i zarządzanie poprzez projektowanie
Wysokiej jakości dane szkoleniowe są nie tylko dokładne, ale również podlegają następującym zasadom :
Plany pobierania próbek zapewniające reprezentację w różnych językach, grupach demograficznych i kontekstach
Wielowarstwowe zapewnianie jakości (recenzenci, MŚP, złote zbiory danych)
Ciągły monitoring w celu wykrycia dryfu, wzorców błędów i nowych przypadków skrajnych.
Neutralni dostawcy inwestują duże sumy w te procesy, ponieważ ich produktem jest zaufanie.
Praktyczna lista kontrolna wyboru neutralnego partnera ds. danych szkoleniowych AI
Oto lista kontrolna dostawcy, którą możesz umieścić w swoim zapytaniu ofertowym.
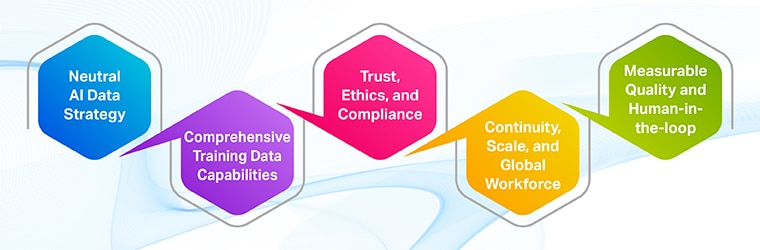
1. Neutralna strategia danych AI
Zapytaj:
Czy tworzysz lub planujesz tworzyć produkty, które będą dla nas konkurować?
W jaki sposób zapewniacie, że nasze dane nie zostaną ponownie wykorzystane – nawet w formie anonimowej – w sposób, na który nie wyraziliśmy zgody?
Co stanie się z naszymi danymi, jeśli zmieni się właściciel lub partnerzy?
2. Kompleksowe możliwości przetwarzania danych w ramach szkolenia AI
Neutralny dostawca powinien nadal wykazywać się dużą skutecznością w realizacji:
Zbieranie, adnotacja i walidacja w całym tekst, obraz, dźwięk i wideo
Doświadczenie w Twojej dziedzinie (np. opieka zdrowotna, motoryzacja, finanse) Możliwość obsługi zarówno klasycznych przypadków użycia uczenia maszynowego, jak i generatywnej sztucznej inteligencji
3. Zaufanie, etyka i zgodność
Twój dostawca powinien być w stanie pokazać:
Zgodność z odpowiednimi ramami (np. RODO, dostosowanie do zasad unijnej ustawy o sztucznej inteligencji)
Przejrzyste podejście do kwestii zgody, anonimizacji i bezpiecznego przechowywania
Audyty wewnętrzne i certyfikacje zewnętrzne, jeśli ma to zastosowanie
Przejrzyste procesy obsługi zgłoszeń incydentów i wniosków osób, których dane dotyczą
Aby zgłębić ten temat, można powiązać neutralność z szerszą dyskusją na temat etyki danych w sztucznej inteligencji – taką jak ta poruszona w artykule Shaipa na temat budowania zaufania do uczenia maszynowego za pomocą danych etycznych.
4. Ciągłość, skala i globalna siła robocza
Neutralność bez siły operacyjnej to za mało. Szukaj:
Udowodniona umiejętność prowadzenia dużych, wielonarodowych projektów na dużą skalę
Globalna sieć współpracowników i solidne działania terenowe
Solidne zarządzanie projektami, umowy SLA oraz wsparcie w zakresie przejścia na nowy system/wdrażania.
5. Mierzalna jakość i zaangażowanie człowieka
Na koniec sprawdź, czy neutralność jest poparta jakością, którą możesz zmierzyć :
Wielowarstwowy przegląd QA i SME
Złote zestawy danych i zestawy testów porównawczych
Przepływy pracy z udziałem człowieka w przypadku złożonych lub delikatnych zadań
Partnerzy neutralni chętnie zapisują wskaźniki jakości na papierze, ponieważ ich działalność opiera się na dostarczaniu spójnych, godnych zaufania wyników.
Jak Shaip podchodzi do neutralności danych w danych szkoleniowych
W firmie Shaip neutralność jest ściśle powiązana ze sposobem pozyskiwania, zarządzania i nadzorowania danych szkoleniowych :
Niezależne skupienie się na dane: Naszą specjalnością są dane szkoleniowe dotyczące sztucznej inteligencji – ich zbieranie, adnotacje, walidacja i konserwacja – zamiast konkurować z klientami na ich rynkach docelowych.
Etyczny, pozyskiwanie z uwzględnieniem prywatności na pierwszym miejscu: Nasze procesy robocze kładą nacisk na zgodę, odpowiednią anonimizację oraz bezpieczne środowisko dla poufnych danych, zgodnie z nowoczesnymi wymogami regulacyjnymi.
Jakość i różnorodność w projektowaniu: Od otwartych zestawów danych po niestandardowe kolekcje – stawiamy na pierwszym miejscu wysokiej jakości, reprezentatywne dane treningowe dla sztucznej inteligencji w różnych językach, grupach demograficznych i modalnościach.
Człowiek w obiegu i zarządzanie: Łączymy globalną wiedzę specjalistyczną z kontrolą na poziomie platformy w zakresie zapewnienia jakości, zarządzania współpracownikami i audytowalnych przepływów pracy.
Jeśli na nowo oceniasz swoją strategię dotyczącą danych, neutralność jest ważnym czynnikiem: czy nasi partnerzy w zakresie danych w pełni podzielają nasze cele – i tylko nasze cele?
Czym jest neutralność danych w sztucznej inteligencji?
Neutralność danych to praktyka gromadzenia, zarządzania i wykorzystywania danych szkoleniowych w sposób niezależny, uczciwy i wolny od konfliktów interesów . Gwarantuje ona, że dostawca danych nie wykorzysta ponownie Twoich danych w sposób, na który nie wyraziłeś zgody, nie będzie bezpośrednio z Tobą konkurował, wykorzystując Twoje własne spostrzeżenia, oraz będzie przestrzegał przejrzystych i etycznych zasad zarządzania.
Dlaczego neutralność danych jest ważna w przypadku danych szkoleniowych sztucznej inteligencji?
Ponieważ dane treningowe kształtują zachowanie Twoich modeli. Bez neutralności ryzykujesz:
Ukryte uprzedzenia wbudowane w zestawy danych
Wyciek IP do konkurencji
Problemy ze zgodnością z nowymi przepisami dotyczącymi sztucznej inteligencji
Utrata zaufania klientów w przypadku kwestionowania praktyk pozyskiwania danych
Jaki jest związek neutralności danych z suwerennością danych?
Suwerenność danych dotyczy tego, kto ostatecznie kontroluje i zarządza Twoimi danymi (często w powiązaniu z geografią i regulacjami). Neutralność danych dotyczy tego, czy kontrola ta jest sprawowana uczciwie i niezależnie. Potrzebujesz obu: suwerennej kontroli nad miejscem przechowywania Twoich danych oraz neutralnych partnerów, którzy nie mają sprzecznych motywacji. Network World+1
Jak mogę sprawdzić, czy dostawca danych szkoleniowych dotyczących sztucznej inteligencji jest naprawdę neutralny?
Poproś o:
Jasne oświadczenia dotyczące tego, czy tworzą produkty, które konkurują z Tobą
Zobowiązania umowne dotyczące ponownego wykorzystania danych i szkolenia modeli
Przejrzystość inwestorów i partnerstw strategicznych
Dowody etycznego i zgodnego z przepisami pozyskiwania danych i zarządzania nimi (audyty, certyfikacje, studia przypadków)
Jeśli odpowiedzi są niejasne, neutralność może być bardziej chwytem marketingowym niż rzeczywistością.
Czy dane szkoleniowe typu open source są neutralne?
Niekoniecznie. Zbiory danych typu open source mogą być cenne, ale często:
Odzwierciedlają uprzedzenia osób, które je stworzyły i opracowują
Brak szczegółowej dokumentacji dotyczącej metod zbierania danych
Masz luki w licencjach lub zgodach
Otwarte zbiory danych należy traktować jako jeden ze składników szerszej, kontrolowanej strategii danych, a nie jako coś automatycznie neutralnego lub wolnego od ryzyka.
Podobał Ci się ten artykuł? Obserwuj Shaipa na LinkedIn, aby być na bieżąco.
Używamy plików cookie, aby poprawić Twoje doświadczenia na naszej stronie. Korzystając z naszej strony, wyrażasz zgodę na pliki cookie.
plików cookie
Zarządzaj swoimi preferencjami dotyczącymi plików cookie poniżej:
Niezbędne pliki cookie umożliwiają podstawowe funkcje i są niezbędne do prawidłowego funkcjonowania strony internetowej.
Imię i nazwisko
OPIS
Czas trwania:
plików cookie
Ten plik cookie służy do przechowywania preferencji użytkownika dotyczących zgody na pliki cookie.
180 dni
plików cookie
Ten plik cookie służy do przechowywania preferencji użytkownika dotyczących zgody na pliki cookie.
180 dni
Konfiguracja geolokalizacji
Ten plik cookie służy do przechowywania ustawień zgody na podstawie lokalizacji odwiedzającego.
180 dni
plików cookie
Ten plik cookie służy do przechowywania preferencji użytkownika dotyczących zgody na pliki cookie.
180 dni
Menedżer tagów Google ułatwia zarządzanie tagami marketingowymi na Twojej stronie internetowej bez konieczności zmiany kodu.
Imię i nazwisko
OPIS
Czas trwania:
TRINITY_USER_ID
-
DANE_UŻYTKOWNIKA_TRINITY
-
td
Rejestruje dane statystyczne dotyczące zachowań użytkowników w serwisie. Wykorzystywane do wewnętrznych analiz przez operatora strony internetowej.
Sesja
Preferencje plików cookie
Rejestruje preferencje użytkownika dotyczące plików cookie
2 roku
Pliki cookie statystyczne zbierają informacje anonimowo. Informacje te pomagają nam zrozumieć, w jaki sposób odwiedzający korzystają z naszej witryny.
Google Analytics to potężne narzędzie, które śledzi i analizuje ruch w witrynie internetowej, umożliwiając podejmowanie świadomych decyzji marketingowych.
Zawiera informacje związane z kampaniami marketingowymi użytkownika. Dane te są udostępniane Google AdWords/Google Ads, gdy konta Google Ads i Google Analytics są połączone.
90 dni
__utma
ID używane do identyfikacji użytkowników i sesji
2 lata od ostatniej aktywności
__utmt
Służy do monitorowania liczby żądań serwera Google Analytics
10 minut
__utmb
Służy do rozróżniania nowych sesji i wizyt. Ten plik cookie jest ustawiany, gdy ładowana jest biblioteka JavaScript GA.js, a plik cookie __utmb nie istnieje. Plik cookie jest aktualizowany za każdym razem, gdy dane są wysyłane do serwera Google Analytics.
30 minut po ostatniej aktywności
__utmc
Stosowane wyłącznie w starszych wersjach Urchin usługi Google Analytics i niedostępne w przypadku GA.js. Służył do rozróżniania nowych sesji i wizyt na koniec sesji.
Koniec sesji (przeglądarka)
__utmz
Zawiera informacje o źródle ruchu lub kampanii, która skierowała użytkownika na stronę internetową. Plik cookie jest ustawiany, gdy skrypt GA.js JavaScript jest ładowany i aktualizowany, gdy dane są wysyłane do serwera Google Analytics
6 miesięcy od ostatniej aktywności
__utmv
Zawiera niestandardowe informacje ustawione przez twórcę strony internetowej za pomocą metody _setCustomVar w Google Analytics. Ten plik cookie jest aktualizowany za każdym razem, gdy nowe dane są wysyłane do serwera Google Analytics.
2 lata od ostatniej aktywności
__utmx
Służy do ustalenia, czy użytkownik jest uwzględniony w teście A/B lub teście wielowymiarowym.
18 miesięcy
_ga
Identyfikator używany do identyfikacji użytkowników
2 roku
_gali
Używany przez Google Analytics do określania, które linki na stronie są klikane
30 sekund
_ga_
Identyfikator używany do identyfikacji użytkowników
2 roku
_gid
Identyfikator używany do identyfikacji użytkowników przez 24 godziny od ostatniej aktywności
24 godzin
_gat
Służy do monitorowania liczby żądań serwera Google Analytics podczas korzystania z Menedżera tagów Google
1 minut
Pliki cookie marketingowe służą do śledzenia odwiedzających strony internetowe. Celem jest wyświetlanie reklam, które są istotne i angażujące dla poszczególnych użytkowników.
Google Ads to internetowa platforma reklamowa umożliwiająca firmom tworzenie ukierunkowanych reklam wyświetlanych w wynikach wyszukiwania Google i witrynach partnerskich.
Plik cookie targetujący. Służy do tworzenia profilu użytkownika i wyświetlania użytkownikowi odpowiednich i spersonalizowanych reklam Google Ads.
2 roku
__Bezpieczne-1PSID
Plik cookie targetujący. Służy do tworzenia profilu użytkownika i wyświetlania użytkownikowi odpowiednich i spersonalizowanych reklam Google Ads.
2 roku
__Bezpieczny-3PAPISID
Tworzy profile zainteresowań użytkowników witryny internetowej, aby wyświetlać im trafne i spersonalizowane reklamy za pomocą remarketingu.
2 roku
AEC
Pliki cookie AEC zapewniają, że żądania w ramach sesji przeglądania są składane przez użytkownika, a nie przez inne witryny. Te pliki cookie zapobiegają działaniu złośliwych witryn w imieniu użytkownika bez jego wiedzy.
6 miesięcy
ADS_VISITOR_ID
Plik cookie wymagany do korzystania z opcji i usług internetowych na stronie
2 miesięcy
__Bezpieczne-3PSIDCC
Plik cookie targetujący. Służy do tworzenia profilu użytkownika i wyświetlania użytkownikowi odpowiednich i spersonalizowanych reklam Google Ads.
2 roku
__Secure-3PSIDTS
Plik cookie targetujący. Służy do tworzenia profilu użytkownika i wyświetlania użytkownikowi odpowiednich i spersonalizowanych reklam Google Ads.
2 roku
__Secure-1PSIDTS
Plik cookie targetujący. Służy do tworzenia profilu użytkownika i wyświetlania użytkownikowi odpowiednich i spersonalizowanych reklam Google Ads.
2 roku
__Bezpieczny-1PAPISID
Plik cookie targetujący. Służy do tworzenia profilu użytkownika i wyświetlania użytkownikowi odpowiednich i spersonalizowanych reklam Google Ads.
2 roku
__Bezpieczne-3PSID
Plik cookie targetujący. Służy do profilowania zainteresowań odwiedzających witrynę i wyświetlania odpowiednich i spersonalizowanych reklam Google.
2 roku
Konwersja
Google używa plików cookie do celów reklamowych, m.in. do wyświetlania i renderowania reklam, personalizowania reklam (w zależności od ustawień reklam na stronie g.co/adsettings), ograniczania liczby wyświetleń reklamy użytkownikowi, wyciszania reklam, których nie chcesz oglądać, oraz mierzenia skuteczności reklam.
90 dni
_gcl_aw
Google używa plików cookie do celów reklamowych, m.in. do wyświetlania i renderowania reklam, personalizowania reklam (w zależności od ustawień reklam na stronie g.co/adsettings), ograniczania liczby wyświetleń reklamy użytkownikowi, wyciszania reklam, których nie chcesz oglądać, oraz mierzenia skuteczności reklam.
90 Dni
_gcl_gs
Google używa plików cookie do celów reklamowych, m.in. do wyświetlania i renderowania reklam, personalizowania reklam (w zależności od ustawień reklam na stronie g.co/adsettings), ograniczania liczby wyświetleń reklamy użytkownikowi, wyciszania reklam, których nie chcesz oglądać, oraz mierzenia skuteczności reklam.
90 Dni
_gcl_pl
Google używa plików cookie do celów reklamowych, m.in. do wyświetlania i renderowania reklam, personalizowania reklam (w zależności od ustawień reklam na stronie g.co/adsettings), ograniczania liczby wyświetleń reklamy użytkownikowi, wyciszania reklam, których nie chcesz oglądać, oraz mierzenia skuteczności reklam.
90 Dni
_gac_gb_
Google używa plików cookie do celów reklamowych, m.in. do wyświetlania i renderowania reklam, personalizowania reklam (w zależności od ustawień reklam na stronie g.co/adsettings), ograniczania liczby wyświetleń reklamy użytkownikowi, wyciszania reklam, których nie chcesz oglądać, oraz mierzenia skuteczności reklam.
90 Dni
FPGCLGB
Google używa plików cookie do celów reklamowych, m.in. do wyświetlania i renderowania reklam, personalizowania reklam (w zależności od ustawień reklam na stronie g.co/adsettings), ograniczania liczby wyświetleń reklamy użytkownikowi, wyciszania reklam, których nie chcesz oglądać, oraz mierzenia skuteczności reklam.
90 Dni
FPGCLAW
Google używa plików cookie do celów reklamowych, m.in. do wyświetlania i renderowania reklam, personalizowania reklam (w zależności od ustawień reklam na stronie g.co/adsettings), ograniczania liczby wyświetleń reklamy użytkownikowi, wyciszania reklam, których nie chcesz oglądać, oraz mierzenia skuteczności reklam.
90 Dni
HubSpot to kompleksowa platforma łącząca marketing, sprzedaż i obsługę klienta, która usprawnia rozwój firmy.
Ten plik cookie jest używany do rozpoznawania odwiedzających, którzy czatują z Tobą za pomocą narzędzia chatflows. Jeśli odwiedzający opuści Twoją witrynę, zanim zostanie dodany jako kontakt, będzie miał ten plik cookie powiązany ze swoją przeglądarką.
13 miesięcy
__hs_do_not_track
Ten plik cookie można ustawić tak, aby zapobiec wysyłaniu przez kod śledzący jakichkolwiek informacji do HubSpot.
13 miesięcy
__hs_cookie_cat_pref
Ten plik cookie służy do rejestrowania kategorii, na które użytkownik wyraził zgodę.
6 miesięcy
__hs_initial_opt_in
Ten plik cookie jest używany do zapobiegania wyświetlaniu banera zawsze, gdy użytkownicy przeglądają strony w trybie ścisłym.
7 dni
__hs_gpc_banner_dismiss
Ten plik cookie jest używany po zamknięciu baneru Global Privacy Control.
180 dni
hs_ab_test
Ten plik cookie służy do konsekwentnego wyświetlania odwiedzającym tej samej wersji strony testu A/B, którą widzieli wcześniej.
Sesja
__hs_notify_banner_dismiss
Ten plik cookie jest używany, gdy witryna internetowa używa banera z prośbą o zgodę.
180 dni
hs-messages-is-open
Ten plik cookie jest używany do określania i zapisywania, czy widżet czatu będzie otwarty podczas przyszłych wizyt.
30 minut
hs-messages-hide-welcome-message
Ten plik cookie jest używany do zapobiegania wyświetlaniu powitalnego komunikatu w widżecie czatu przez jeden dzień po jego zamknięciu.
Dzień 1
__hsmem
Ten plik cookie jest ustawiany, gdy odwiedzający logują się do witryny hostowanej w HubSpot.
1 rok
członkostwo hs-csrf
Ten plik cookie jest używany w celu zapewnienia, że dane logowania do członkostwa w serwisie treści nie mogą zostać sfałszowane.
Sesja
hs_langswitcher_choice
Ten plik cookie jest używany do zapisywania wyboru języka wybranego przez odwiedzającego podczas przeglądania stron w wielu językach.
2 roku
__hstc
Główny plik cookie służący do śledzenia odwiedzających.
13 miesięcy
hubspotutk
Ten plik cookie śledzi tożsamość odwiedzającego. Jest on przekazywany do HubSpot podczas przesyłania formularza i używany podczas usuwania duplikatów kontaktów.
13 miesięcy
__hssc
Ten plik cookie śledzi sesje.
30 minut
__hssrc
Za każdym razem, gdy HubSpot zmienia plik cookie sesji, ten plik cookie jest również ustawiany w celu ustalenia, czy użytkownik ponownie uruchomił przeglądarkę.
Sesja
preferencje hubspotapi
Używa się tego w połączeniu z plikiem cookie hubspotapi, aby zapamiętać, czy użytkownik zaznaczył pole „zapamiętaj mnie” (kontroluje wygaśnięcie uwierzytelnienia głównego pliku cookie).
Rok 1
hubspotapi-csrf
Służy do zapobiegania atakom CSRF – uniemożliwia stronom internetowym osób trzecich dostęp do Twoich danych. Wygasa po roku.
1 rok
__hs_opcja_wyłączenia
Ten plik cookie jest używany przez politykę prywatności dotyczącą opcji opt-in, aby pamiętać, aby nie prosić odwiedzającego ponownie o zaakceptowanie plików cookie.
13 miesięcy
hubspotapi
Ten plik cookie umożliwia użytkownikowi dostęp do aplikacji z odpowiednimi uprawnieniami.