
Zestaw danych do uczenia maszynowego
Kup i uzyskaj licencję na zestawy danych szkoleniowych AI klasy premium | Katalog danych AI i rynek licencji
Katalog danych AI i rynek licencji Shaip to jedno źródło zakupu i licencjonowania wstępnie oznakowanych, dopuszczonych komercyjnie zestawów danych szkoleniowych w formatach tekstowych, głosowych, graficznych, wideo i multimodalnych. Każdy zestaw danych jest oznaczony przez człowieka, pochodzi z etycznych źródeł i jest dostarczany w stanie gotowym do szkolenia — z pełną dokumentacją zgodności z RODO, HIPAA i wymogami zarządzania danymi w przedsiębiorstwie.
Niezależnie od tego, czy dopracowujesz duży model językowy, szkolisz system diagnostyki medycznej, czy przyspieszasz proces przetwarzania wizji komputerowej, katalog Shaip obejmuje ponad 10 branż z elastycznymi opcjami licencjonowania: jednorazowy zakup, dostęp subskrypcyjny lub niestandardowe umowy korporacyjne. Poproś o bezpłatny przykładowy zestaw danych, aby zweryfikować jakość przed podjęciem decyzji.
W naszych działaniach priorytetowo traktujemy etyczne pozyskiwanie danych, zapewniając odpowiedzialny i uczciwy rozwój AI. Nasze rygorystyczne i przejrzyste praktyki w zakresie gromadzenia, walidacji i przetwarzania danych chronią prywatność i utrzymują zaufanie zarówno naszych klientów, jak i podmiotów dostarczających dane.
Katalog danych fizycznej sztucznej inteligencji
Programy uczenia się robotów zależą od jakości i spójności danych demonstracyjnych. Nasz katalog Physical AI zawiera demonstracje z udziałem ludzi, dane percepcji multimodalnej oraz epizody stanu i działania robotów zebrane w oparciu o standardową bibliotekę zadań – zapewniając Twoim potokom VLA, humanoidalnym, manipulacyjnym i Real2Sim czyste, porównywalne epizody niezbędne do ich niezawodnego szkolenia i oceny.
Gotowy katalog danych fizycznych AI i licencjonowanie:
- Ponad 1,400 udokumentowanych scenariuszy zadań w 9 rzeczywistych środowiskach (gospodarstwo domowe, przemysł, handel detaliczny, hotelarstwo i inne)
- Demonstracje z udziałem ludzi i epizody szkoleniowe VLA ze spójnymi stanami początkowymi i kryteriami sukcesu
- Egocentryczne i wielowidokowe wideo z uchwyceniem ruchu, pozy i zręczności
- Czas trwania odcinka od 0.5 do 10 minut na 4 poziomach trudności, wliczając w to używanie narzędzi

Katalog danych mowy
Istnieje wiele różnych typowych zastosowań danych mowy w projektach AI. Oferujemy ogromne ilości wysokiej jakości danych gotowych dla produktów do rozpoznawania głosu, które mieszczą się w Twoim budżecie i mogą być skalowane wraz z rozwojem, aby trenować modele AI / ML.
Gotowy katalog danych mowy i licencjonowanie:
- Ponad 55 50 godzin danych mowy (100+ języków/XNUMX+ dialektów)
- 70+ tematów objętych
- Częstotliwość próbkowania – 8/16/44/48 kHz
- Typ dźwięku - spontaniczne, skryptowane, monolog, budzące słowa
- W pełni transkrybowane zestawy danych dźwiękowych w wielu językach do rozmów z ludźmi, rozmów z ludźmi, rozmów z agentami, monologów, przemówień, podcastów itp.
- Leksykon wymowy, zarówno ogólny, jak i dziedzinowy (np. nazwy, miejsca, liczby naturalne)

Katalog danych medycznych
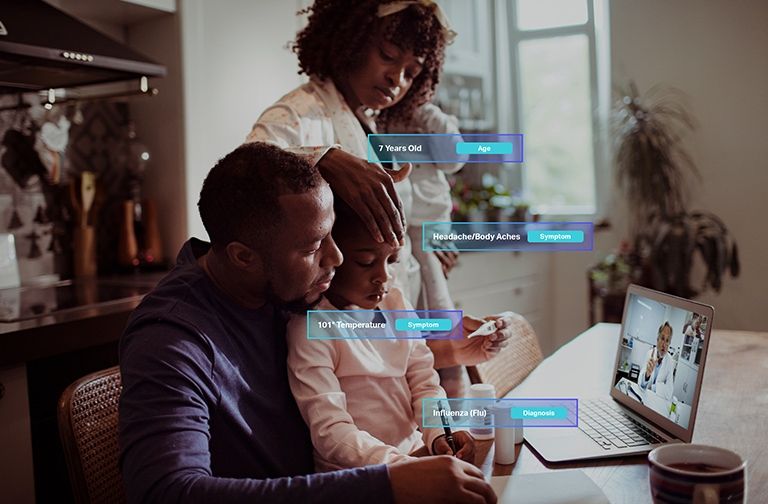
Nasze zbiory danych z katalogami danych medycznych są nie tylko ogromne, ale zawierają również dane o złotym standardzie jakości. . Zapewniamy, że dane, z których korzystasz, są bezpieczne, pozbawione możliwości identyfikacji i można im zaufać, jeśli chodzi o osiąganie najwyższych i najdokładniejszych wyników Twojej inicjatywy AI, modeli uczenia maszynowego, przetwarzania języka naturalnego i innych projektów programistycznych.
Gotowy katalog danych medycznych i licencjonowanie:
- Ponad 5 milionów elektronicznych kart zdrowia i plików dźwiękowych lekarzy w 31 specjalnościach
- 2 mln+ obrazów medycznych w radiologii i innych specjalnościach (MRI, CT, USG, XR)
- Ponad 30 tys. klinicznych dokumentów tekstowych z jednostkami o wartości dodanej i adnotacjami o relacjach
Katalog danych wizji komputerowej
Istnieje wiele różnych typowych zastosowań wizji komputerowej w projektach AI. Oferujemy ogromne ilości wysokiej jakości danych obrazu i wideo, gotowych dla modeli wizji komputerowych, które mieszczą się w Twoim budżecie i mogą być skalowane w miarę rozwoju.
Katalog danych obrazów i wideo oraz licencjonowanie:
- Kolekcja obrazów żywności/dokumentów
- Kolekcja wideo bezpieczeństwa w domu
- Kolekcja obrazów twarzy/wideo
- Faktury, PO, Pokwitowania Inkaso dokumentów dla OCR
- Zbieranie obrazów do wykrywania uszkodzeń pojazdów
- Kolekcja obrazów tablic rejestracyjnych pojazdu
- Kolekcja obrazów wnętrza samochodu
- Kolekcja obrazów z kierowcą samochodu w centrum uwagi
- Kolekcja obrazów związanych z modą
- Zbieranie filmów i adnotacje z użyciem dronów
- Kolekcja filmów/obrazów osób niepełnosprawnych
- Kolekcja obrazów punktów orientacyjnych
- Kolekcja obrazów do skanowania kodów kreskowych

Katalog danych tekstowych
Duże modele językowe i systemy przetwarzania języka naturalnego (NLP) wymagają tekstu odzwierciedlającego rzeczywisty język, rzeczywiste domeny i rzeczywiste zróżnicowanie regionalne. Nasz Katalog Danych Tekstowych oferuje gotowe do licencjonowania zbiory danych tekstowych w 8 kategoriach: konwersacyjne pytania i odpowiedzi, kod, wiadomości, materiały kliniczne, surowy tekst internetowy, zeskanowane dokumenty, materiały akademickie i rozrywka. Są one przeznaczone do wstępnego trenowania, dostrajania, analizy i ewaluacji, a każdy z nich można dostosować do potrzeb Twojego projektu.
Katalog gotowych danych tekstowych i licencjonowanie:
- Ponad 170 tys. par pytań i odpowiedzi tworzonych przez ludzi w języku angielskim i arabskim, obejmujących dialekty saudyjskie, emirackie, egipskie i lewantyńskie
- Ponad 50 milionów linii kodu w 9 językach programowania, w tym kilka z pełną historią żądań ściągnięcia i zatwierdzenia
- Archiwum wiadomości liczące 975 tys. artykułów, sięgające 1999 r., plus bieżące kanały informacyjne w języku angielskim, hiszpańskim i arabskim
- Pytania i odpowiedzi kliniczne, streszczenia przypadków i artykuły, dostępne jako zestawy złote/srebrne, z de-id.
- Korpus tekstów surowych w języku arabskim o objętości 20 milionów słów, plus korpusy skryptów podpowiedzi i syntezatora mowy do wstępnego treningu
- Ponad 1.3 mln artykułów w czasopismach i ponad 4,100 tytułów książek z 12 dziedzin nauki i inżynierii
- Zeskanowane dokumenty i formularze ze świata rzeczywistego (ponad 12 tys. plików PDF) do wykorzystania sztucznej inteligencji w dokumentach i ekstrakcji informacji
- Ponad 90 tys. godzin scenariuszy filmowych, programów telewizyjnych, animacji i mikrodramatów do modelowania narracji i dialogów
Otwarte zbiory danych
Dzięki bibliotece otwartych zbiorów danych Shaip Twój zespół ma bezpłatny dostęp do obszernego repozytorium danych AI. Teraz możesz szybko i dokładnie opracować modele AI i ML pod kątem określonych wyników biznesowych bez powiązanych kosztów.
Dostępne otwarte zbiory danych:
- Dostępny w wygodnej i modyfikowalnej formie
- Ogromne kategorie zbiorów danych
- Bezpłatnie do użytku z projektami AI i ML
- Wysokiej jakości dane o złotym standardzie

Bezpieczeństwo i zgodność


Zaplanuj prezentację, aby dowiedzieć się, jak Shaip może spełnić wszystkie Twoje wymagania dotyczące danych treningowych.
Od gromadzenia danych, przez adnotacje, licencjonowanie, po walidację — pomożemy Ci szybciej wprowadzić produkt na rynek, korzystając z danych, którym możesz zaufać.
KontaktCzęsto Zadawane Pytania (FAQ)
1. Czym jest licencjonowanie katalogu danych?
Licencjonowanie katalogu danych umożliwia firmom zakup lub licencjonowanie dostępu do wyselekcjonowanych zestawów danych do wykorzystania w projektach AI. Te zestawy danych obejmują dane tekstowe, mowy, obrazy lub wideo, starannie przygotowane w celu spełnienia określonych wymagań. Licencjonowanie zapewnia, że firmy mogą legalnie korzystać z danych, przestrzegając standardów prywatności i zgodności.
2. W jaki sposób gromadzone i oznaczane są zbiory danych szkoleniowych sztucznej inteligencji Shaip?
Shaip gromadzi dane za pośrednictwem globalnej, zweryfikowanej sieci dostawców w ponad 60 krajach, korzystając z autorskiej platformy Shaip. Wszystkie zbiory danych przechodzą wielostopniową kontrolę jakości przez annotatorów-ekspertów z danej dziedziny, automatyczne kontrole walidacyjne oraz ostateczną weryfikację z udziałem człowieka przed dostarczeniem. Docelowa dokładność etykietowania przekracza 95% we wszystkich kategoriach katalogu.
3. Czy Shaip jest w stanie skalować zestawy danych, aby sprostać rosnącym potrzebom projektu?
Tak, zestawy danych Shaip są skalowalne. Niezależnie od tego, czy potrzebujesz małych zestawów danych do testowania, czy dużych wolumenów do trenowania modeli AI klasy korporacyjnej, globalna sieć Shaip może dostarczyć dane, które spełnią wymagania Twojego projektu.
4. Ile kosztuje licencjonowanie gotowych zestawów danych?
Koszt licencji zależy od takich czynników, jak typ danych, wolumen, dostosowanie i prawa użytkowania. Shaip oferuje elastyczne ceny dostosowane do różnych budżetów i potrzeb projektu. Skontaktuj się z zespołem, aby uzyskać spersonalizowaną wycenę.
5. Czy mogę poprosić o przykładowy zestaw danych?
Tak, Shaip oferuje przykładowe zestawy danych, które pomogą Ci ocenić ich jakość i trafność w kontekście Twojego projektu. Skontaktuj się z zespołem, aby umówić się na demo lub zamówić próbkę.
6. Gdzie mogę kupić licencjonowane zestawy danych szkoleniowych AI do użytku komercyjnego?
Katalog danych AI firmy Shaip oferuje wstępnie oznakowane zestawy danych dostępne do natychmiastowego licencjonowania komercyjnego w formatach tekstowych, głosowych, graficznych, wideo i multimodalnych. Wszystkie zestawy danych zawierają przejrzystą dokumentację licencyjną – zgodną z RODO i HIPAA – z możliwością zakupu jednorazowego, rocznej subskrypcji lub umowy korporacyjnej. Zamów bezpłatną próbkę, aby sprawdzić jakość przed zakupem.
7. Jak kupić zestawy danych zgodne z RODO i HIPAA do szkolenia modeli AI?
Cały katalog zbiorów danych Shaip został stworzony tak, aby spełniać wymogi RODO i HIPAA. Każdy zbiór danych zawiera dokumentację zgody, dane anonimizujące (w przypadku danych medycznych), metadane pochodzenia danych oraz artefakty zgodności gotowe do audytu. Organizacje korzystające z ram RODO, HIPAA, CCPA lub ISO 27001 mogą licencjonować zbiory danych z pełną dokumentacją bez dodatkowych kosztów.
8. Jakie rodzaje wstępnie oznakowanych zestawów danych multimodalnych mogę licencjonować od Shaip?
Shaip oferuje multimodalne zbiory danych łączące dane tekstowe, mowę, obrazy i wideo — w tym egocentryczne wideo dla fizycznej sztucznej inteligencji, zestawy danych demonstracyjnych dla robotyki oraz połączone korpusy tekstowo-obrazowe do precyzyjnego dostrajania GenAI. Wszystkie multimodalne zbiory danych zawierają metadane, adnotacje na poziomie modalności oraz komercyjne warunki licencji. Bezpłatne próbki są dostępne na życzenie.
