Usługi gromadzenia danych obrazowych dla wizji komputerowej

Niestandardowe, w pełni zatwierdzone zestawy danych obrazów — dowolny temat, dowolny scenariusz, zbudowane według specyfikacji Twojego modelu.

Gromadzenie danych obrazu

Dlaczego zestaw danych treningowych obrazu jest potrzebny do widzenia komputerowego?

Gromadzenie danych obrazowych to proces pozyskiwania, pozyskiwania i selekcjonowania zestawów danych obrazowych w celu trenowania modeli rozpoznawania obrazu i uczenia maszynowego. Shaip gromadzi niestandardowe, w pełni zatwierdzone obrazy – obejmujące twarze, dokumenty, obiekty, sceny i obrazy medyczne – dostosowane do domeny, rozdzielczości i wymagań demograficznych każdego modelu, a następnie sprawdza jakość każdego obrazu w procesie Six Sigma.

Modele i konfiguracje Smart ML, których zadaniem jest identyfikowanie obiektów i wzorców w ramach ich funkcjonowania, muszą być intensywnie szkolone. Począwszy od śledzenia interakcji po ludzkie emocje, inteligentne systemy muszą przede wszystkim mieć podstawę do identyfikowania bytów. Siłę identyfikacji zapewniają niestandardowe rozwiązania do gromadzenia danych obrazowych.

Zbieranie danych obrazowych dla komputerowych systemów wizyjnych niesie ze sobą następujące korzyści:

  • Unikalne repozytorium obrazów
  • Możliwość etykietowania obrazów zgodnie z wymaganiami
  • Dostęp do ciężarówek danych historycznych

Profesjonalne zestawy danych szkoleniowych w zakresie obrazu

Dowolny temat. Dowolny scenariusz.

Aplikacjom, które wymagają znakowania twarzy i gestów, nie można podawać informacji powierzchownie. Zamiast tego zbieranie danych obrazów dla modeli uczenia maszynowego musi być zgodne z najnowszymi standardami. W Shaip koncentrujemy się na zapewnianiu dostępu do kompleksowych zestawów danych treningowych dotyczących obrazów, przy wsparciu na poziomie ekspertów w zakresie skalowalności.

Profesjonalne zestawy danych do szkoleń z zakresu obrazowania w Shaip koncentrują się na kompleksowych rozwiązaniach, takich jak śledzenie obiektów, analiza pisma ręcznego, identyfikacja obiektów i rozpoznawanie wzorców. To nie wszystko! Usługi gromadzenia danych obrazowych oferowane przez Shaip obejmują również:

Kolekcja obrazów
  • Zdalne i w terenie zasilanie danych
  • Możliwość skalowania rozwiązań – ciągłe pozyskiwanie zbiorów danych
  • Wysokiej jakości dane podzielone na segmenty, które są gotowe do eksploracji
  • Obsługa transkrypcji obrazu na tekst dla OCR wyszkolonych modelek
  • Szerokie wsparcie dla analizy specyficznej dla człowieka
  • Bezpieczna obsługa i zarządzanie danymi

Nasza wiedza

Kolekcja obrazów poprzedzająca Tematy i Scenariusze

W Shaip mamy całą gamę typów gromadzenia danych obrazowych, z algorytmami równoznacznymi z konkretnymi przypadkami użycia. Dodaj widzenie komputerowe do swoich możliwości uczenia maszynowego, gromadząc duże ilości zestawów danych obrazowych (zestaw danych obrazów medycznych, zestaw danych obrazów faktur, zbiór zestawów danych twarzy lub dowolny niestandardowy zestaw danych) dla różnych przypadków użycia. W Shaip mamy całą gamę typów gromadzenia danych obrazowych, z algorytmami równoznacznymi z konkretnymi przypadkami użycia. Różne typy zestawów danych obrazowych, które oferujemy:

Adnotacja dokumentu finansowego

Kolekcja dokumentów i obrazów OCR

Shaip przechwytuje faktury, paragony, dowody osobiste, paszporty i formularze pisane odręcznie na potrzeby modeli OCR i rozumienia dokumentów, w wielu językach i warunkach przechwytywania. Zastosowanie: OCR, KYC, klasyfikacja dokumentów.

Rozpoznawanie twarzy

Zbieranie obrazów twarzy i danych demograficznych

Shaip gromadzi zbiory danych o obrazach twarzy uwzględniające pochodzenie etniczne, wiek, ułożenie głowy i oświetlenie, aby ograniczyć stronniczość sztucznej inteligencji, oferując opcje punktów orientacyjnych do rozpoznawania i modelowania emocji. Przykład zastosowania: rozpoznawanie twarzy, sztuczna inteligencja w zakresie emocji, monitorowanie kierowców ADAS.
Licencjonowanie danych medycznych

Zbieranie danych dotyczących opieki zdrowotnej

Popraw jakość konfiguracji cyfrowej opieki zdrowotnej i dokładność diagnostyki medycznej dzięki oferowanym jakościowym i ilościowym zestawom danych dotyczących opieki zdrowotnej. Wykonujemy obrazy medyczne tj. CT, MRI, USG, RTG z różnych specjalności medycznych takich jak Radiologia, Onkologia, Patologia itp.

Zbieranie zbiorów danych o żywności

Zbieranie danych o żywności

Jeśli kiedykolwiek planujesz opracować inteligentną aplikację, która może rejestrować i identyfikować obrazy żywności w różnych warunkach oświetleniowych, nasz zbiór danych o żywności może być bardzo przydatny.

Zbiór danych motoryzacyjnych

Zbieranie danych motoryzacyjnych

Szkolenie baz danych autonomicznych samochodów z elementami pobocza drogi, spostrzeżeniami dotyczącymi konkretnego kąta, obiektami, danymi sematycznymi i nie tylko jest możliwe dzięki zestawom danych motoryzacyjnych.
Gest ręki

Zbieranie danych gestów dłoni Hand

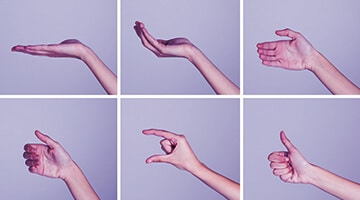
Jeśli kiedykolwiek zdarzyło Ci się przesunąć ręką komórkę do snu, będziesz w stanie się z nią powiązać. Urządzenia inteligentne i IoT z czujnikami mogą korzystać z naszych usług gromadzenia danych o gestach dłoni.
Kolekcja obrazów obiektów

Kolekcja obrazów obiektów

Nasza usługa gromadzenia obrazów obiektów zapewnia szeroką gamę obrazów przedstawiających różne obiekty w różnych kontekstach i warunkach oświetleniowych.

Kolekcja obrazów charakterystycznych

Kolekcja obrazów punktów orientacyjnych

Specjalizujemy się w kolekcjonowaniu zdjęć zabytków z całego świata. Nasze zbiory danych obejmują różne kąty, pory dnia i warunki pogodowe

Odręczne obrazy tekstowe

Kolekcja tekstów pisanych odręcznie

Zbiór odręcznych obrazów tekstowych w różnych językach i stylach w celu opracowania modeli sztucznej inteligencji zdolnych do dokładnego rozpoznawania i interpretowania tekstu pisanego odręcznie.

Zbiory danych obrazu

Kierowca samochodu w centrum uwagi Zbiór danych obrazu

450 20,000 zdjęć twarzy kierowcy z ustawieniem samochodu w różnych pozach i odmianach, obejmujących 10 XNUMX unikalnych uczestników z ponad XNUMX grup etnicznych

Kierowca samochodu w zestawie danych obrazu ostrości

  • Przypadek użycia: Samochodowy model ADAS
  • Format: Obrazy
  • Tom: 455,000 +
  • Adnotacja: Nie

Zbiór danych obrazu punktu orientacyjnego

Ponad 80 40 zdjęć punktów orientacyjnych z ponad XNUMX krajów, zebranych na podstawie niestandardowych wymagań.

Zbiór danych obrazu punktu orientacyjnego

  • Przypadek użycia: Wykrywanie punktów orientacyjnych
  • Format: Obrazy
  • Tom: 80,000 +
  • Adnotacja: Nie

Zbiór danych obrazu twarzy

12 tys. zdjęć z różnymi pozycjami głowy, pochodzeniem etnicznym, płcią, tłem, kątem uchwycenia, wiekiem itp. z 68 punktami orientacyjnymi

Zbiór danych obrazu twarzy

  • Przypadek użycia: Rozpoznawanie twarzy
  • Format: Obrazy
  • Tom: 12,000 +
  • Adnotacja: Adnotacja do punktu orientacyjnego

Zbiór danych obrazu żywności

55 tys. obrazów w ponad 50 odmianach (rodzaj żywności, oświetlenie, pomieszczenia i na zewnątrz, tło, odległość kamery itp.) z adnotacjami

Zbiór danych obrazu żywności/dokumentu z segmentacją semantyczną

  • Przypadek użycia: Rozpoznawanie żywności
  • Format: Obrazy
  • Tom: 55,000 +
  • Adnotacja: Tak

Jak to działa / Proces

Krok 1 – zakres i specyfikacje

Zakres i specyfikacje

Zdefiniuj temat, objętość, ustawienia regionalne, dane demograficzne, formaty i wymagania dotyczące zgody.

Krok 2 – pilot i kalibracja

Pilot i kalibracja

Przed skalowaniem przeprowadź mały pilotaż, aby sprawdzić wytyczne i przypadki skrajne.

Krok 3 – pełna kolekcja

Kolekcja w pełnej skali

Zdobądź jak najwięcej dzięki sprawdzonej globalnej sieci współpracowników Shaip.

Krok 4-sześć-sigma-qa

Six Sigma QA

Wieloetapowa walidacja, zadania kontrolne i kontrola zgodności każdej partii.

Dostawa i odświeżenie

Dostarcz w wybranym formacie wraz z metadanymi, a następnie rozszerz zakres w razie potrzeby.
Platforma danych

Dlaczego warto wybrać Shaip

Spersonalizowane, nie skopiowane: Shaip zbiera nowe, w pełni zaakceptowane obrazy dokładnie według Twoich wymagań — domeny, rozdzielczości i zestawu danych demograficznych — zamiast ponownie pakować publiczne zestawy.

Jakość Six Sigma: Dedykowany zespół specjalistów Six Sigma posiadających czarne pasy przeprowadza proces zapewnienia jakości etap-bramka z ciągłymi pętlami sprzężenia zwrotnego, dzięki czemu zestawy danych są wysyłane w formie zweryfikowanej.

Relacja uwzględniająca uprzedzenia: Shaip wykorzystuje dane pochodzące z różnych grup etnicznych, grup wiekowych, regionów geograficznych i warunków oświetleniowych, aby wyeliminować stronniczość sztucznej inteligencji wizualnej na poziomie warstwy danych.

Usługi oferowane

Zbieranie danych tekstowych przez ekspertów to nie wszystko, co trzeba zrobić, jeśli chodzi o kompleksowe konfiguracje sztucznej inteligencji. W Shaip możesz nawet rozważyć następujące usługi, aby modele były bardziej rozpowszechnione niż zwykle:

Zbieranie danych mowy

Usługi gromadzenia danych dźwiękowych

Ułatwiamy karmienie modelek danymi głosowymi, aby pomóc im w bardziej zrównoważony sposób odkrywać korzyści płynące z przetwarzania języka naturalnego

Zbieranie danych tekstowych

Usługi gromadzenia danych tekstowych

Prawdziwą wartością usług gromadzenia danych kognitywnych Shaip jest to, że dają one organizacjom klucz do odblokowania krytycznych informacji znajdujących się w danych nieustrukturyzowanych

Zbieranie danych wideo

Usługi gromadzenia danych wideo

Teraz skup się na wizji komputerowej wraz z NLP, aby trenować swoje modele do perfekcyjnego identyfikowania obiektów, osób, środków odstraszających i innych elementów wizualnych

Wyróżnieni klienci

Umożliwianie zespołom tworzenia wiodących na świecie produktów AI.

Skontaktuj się z nami

Chcesz zbudować własne repozytorium zbiorów danych obrazu?

Sięgnij po zbiory danych treningowych z lotu ptaka i zdobądź repozytorium dla swojego modelu Computer Vision.

  • To pole jest dla celów walidacji i powinny być pozostawione bez zmian.
  • Rejestrując się, zgadzam się z Shaip Polityka Prywatności oraz Regulamin i wyrazić zgodę na otrzymywanie komunikacji marketingowej B2B od Shaip.

Gromadzenie danych obrazowych na potrzeby sztucznej inteligencji (AI/ML) to proces gromadzenia danych wizualnych – fotografii, skanów lub grafik – w celu trenowania, testowania i walidacji modeli uczenia maszynowego interpretujących obrazy. Zebrane obrazy dostarczają systemom wizyjnym przykładów potrzebnych do precyzyjnego rozpoznawania obiektów, twarzy, scen i wzorców w warunkach rzeczywistych.

Gromadzenie danych obrazowych rozpoczyna się od zdefiniowania wymagań i celów projektu. Następnie obrazy są pobierane z baz danych, świeżo rejestrowane za pomocą kamer lub generowane w razie potrzeby, przy czym priorytetem jest różnorodność i jakość. Po zebraniu obrazy są zazwyczaj oznaczane lub opatrywane adnotacjami, aby dodać kontekst i klasyfikację, na których opiera się model uczenia maszynowego podczas szkolenia.

Gromadzenie danych obrazowych jest podstawą każdego projektu uczenia maszynowego, który zajmuje się informacjami wizualnymi. Wysokiej jakości, zróżnicowane zbiory danych obrazowych zapewniają dokładniejsze i bardziej niezawodne trenowanie modelu, co przekłada się na lepszą wydajność w warunkach rzeczywistych. Dobrze zebrane dane zapewniają systemom AI możliwość niezawodnego rozpoznawania, interpretowania i reagowania na sygnały wizualne w różnych warunkach produkcyjnych.

W zależności od celu, można gromadzić wiele typów danych, w tym zdjęcia, obrazy satelitarne, dokumenty pisane ręcznie i skanowane, zdjęcia twarzy, obrazy termiczne oraz obrazy z rozszerzonej rzeczywistości (AR) i wirtualnej rzeczywistości (VR). Wybrany typ danych powinien być zgodny ze specyficznymi wymaganiami projektu AI/ML, ponieważ dopasowanie domeny bezpośrednio wpływa na dokładność modelu.

Kolekcja niestandardowa gromadzi świeże, w pełni zatwierdzone obrazy dopasowane do domeny, rozdzielczości i potrzeb demograficznych Twojego modelu. Publiczne zbiory danych, takie jak ImageNet czy COCO, są uniwersalne i często obejmują jedynie model do etapu prototypu. Shaip gromadzi dane dokładnie według Twoich specyfikacji, dzięki czemu odzwierciedlają rzeczywiste warunki, tematy i przypadki brzegowe, z którymi musi zmierzyć się Twoja aplikacja.

Shaip stosuje proces kontroli jakości Six Sigma Stage-Gate, prowadzony przez dedykowanych właścicieli procesów z certyfikatem Black Belt, z walidacją i pętlami sprzężenia zwrotnego dla każdej partii. Aby zredukować stronniczość wizualno-sztucznej inteligencji na poziomie danych, Shaip pozyskuje dane z różnych grup etnicznych, grup wiekowych, regionów geograficznych i warunków oświetleniowych, dzięki czemu modele działają uczciwie i spójnie, a nie faworyzują grup nadreprezentowanych.

Tak. Shaip gromadzi dane wizerunkowe za pełną zgodą użytkowników, z udokumentowanymi zwolnieniami uczestników oraz bezpiecznym przetwarzaniem i przesyłaniem z kontrolą dostępu. Ma to znaczenie w przypadku użytku komercyjnego, gdzie niejednoznacznie licencjonowane obrazy publiczne stwarzają ryzyko prawne. 

Koszt zależy od objętości i rodzaju obrazu, regionów docelowych, wymaganych metadanych oraz wymogów dotyczących zgody, dlatego nie obowiązuje stała stawka. Shaip przedstawia indywidualną wycenę po krótkiej rozmowie wstępnej na temat tematu, specyfikacji i harmonogramu, dzięki czemu nie musisz płacić za zakres kolekcji, którego Twój model tak naprawdę nie potrzebuje.