
-
-
-
Trenuj i dostrajaj
-
Zarządzana ocena ekspercka
-
-
Specjalne
-
-
Firma
Od dawna rozważa się, jak sztuczna inteligencja (AI) zmieni każdy aspekt ludzkiego życia. Z pewnością zdałeś już sobie sprawę, że ma ona potencjał, by stać się najbardziej przełomową technologią w historii. Dziś możemy komunikować się z Siri, Cortaną czy Google, aby uzyskać odpowiedzi na podstawowe pytania, ale wiele z ich rzeczywistego potencjału pozostaje nieznanych.
Stworzenie sztucznej inteligencji, która naprawdę rozumie język ludzki, wymaga czegoś więcej niż surowych danych – wymaga precyzyjnie oznakowanych, specjalistycznych pod względem językowym zestawów danych szkoleniowych dostarczanych na skalę korporacyjną. Shaip to wiodący dostawca usług NLP, oferujący kompleksowe usługi i rozwiązania w zakresie przetwarzania języka naturalnego dla zespołów AI na całym świecie: od niestandardowego gromadzenia danych tekstowych i audio, przez profesjonalne adnotacje, gotowe zestawy danych NLP, po w pełni zarządzane dostarczanie rozwiązań dla kadry pracowniczej w ponad 150 językach.
Niezależnie od tego, czy trenujesz system sztucznej inteligencji konwersacyjnej, dostrajasz duży model językowy (LLM), budujesz silnik analizy sentymentów, czy skalujesz proces rozpoznawania jednostek nazwanych (NER) – ponad 30 tysięcy akredytowanych współpracowników Shaip dostarcza ustrukturyzowane, wysokiej jakości dane treningowe NLP, niezbędne Twoim modelom do prawidłowego działania w świecie rzeczywistym. Rozwiązania NLP firmy Shaip, którym zaufały firmy z listy Fortune 500 z branży opieki zdrowotnej, finansów, technologii i handlu detalicznego, łączą w sobie autorskie narzędzia platformowe, procesy jakości 6 Sigma oraz ekspertów dziedzinowych, aby sprostać wymaganiom w zakresie dokładności i przepustowości sztucznej inteligencji klasy produkcyjnej.

Każdy wydajny model językowy zaczyna się od specjalnie opracowanych danych treningowych, specyficznych dla danej dziedziny. Usługi gromadzenia danych NLP firmy Shaip dostarczają precyzyjne dane wejściowe, których potrzebuje Twój model – w odpowiedniej objętości, w Twoim języku i z uwzględnieniem zmienności językowej, jakiej wymaga rzeczywiste wdrożenie.
Pozyskujemy obszerne, spersonalizowane korpusy tekstowe w różnych formatach: e-maile, recenzje klientów, posty w mediach społecznościowych, zgłoszenia do pomocy technicznej, umowy prawne, dokumenty finansowe i wiele innych. Nasze usługi gromadzenia tekstów, dostępne w ponad 150 językach i dialektach regionalnych, umożliwiają szkolenie chatbotów, dostrajanie programów LLM, systemy trafności wyszukiwania oraz procesy zrozumienia dokumentów.
Od skryptowanych komunikatów po spontaniczne dialogi konwersacyjne, Shaip gromadzi wysokiej jakości nagrania audio dostosowane do wymagań ASR lub sztucznej inteligencji głosowej (Voice AI) – uwzględniając konkretne akcenty, hałas otoczenia, dane demograficzne mówców i warunki panujące na kanale. Dostarczane jako samodzielne zbiory lub jako kompletne pakiety ASR z transkrypcją, leksykonami wymowy i dokumentacją językową do natychmiastowego trenowania modelu. Wszystkie zebrane dane są dostarczane wraz z pełnymi metadanymi, atrybucją mówców i weryfikacją jakości za pośrednictwem autorskiej platformy adnotacji Shaip.
Dokładne modele NLP wymagają precyzyjnie adnotowanych danych treningowych. Usługi adnotacji danych firmy Shaip łączą wykwalifikowaną, wielojęzyczną kadrę z autorską platformą, aby dostarczać spójne i precyzyjne etykiety w skali całego przedsiębiorstwa — z wbudowanymi bramkami jakości i przejrzystym śledzeniem dostaw.

Nasze możliwości adnotacji NLP obejmują wszystkie najważniejsze typy zadań:
Wszystkie adnotacje dostarczane są w ramach procesu kontroli jakości 6 Sigma z oceną zgodności między adnotatorami i ciągłymi pętlami sprzężenia zwrotnego.

Przeglądaj nasz zbiór danych audio zawierający różnorodne gotowe zestawy danych NLP, składający się z ponad 20 000 godzin nagrań audio na różnorodne tematy, takie jak: call center, rozmowy ogólne, debaty, przemówienia, wykłady, filmy dokumentalne, wydarzenia, rozmowy ogólne, filmy, wiadomości itp., w ponad 40 językach.
Oferujemy wykwalifikowaną kadrę, która stanie się rozszerzeniem Twojego zespołu, wspierającą zadania związane z adnotacją danych, za pomocą preferowanych przez Ciebie narzędzi, przy jednoczesnym zachowaniu pożądanej jakości. Nasi doświadczeni pracownicy rozumieją niuanse języka ludzkiego i stosują najlepsze praktyki zdobyte podczas etykietowania milionów dokumentów audio i tekstowych, aby dostarczać światowej klasy rozwiązania do etykietowania danych w zakresie przetwarzania języka naturalnego.

Od gromadzenia tekstu/audio po adnotacje, zapewniamy głębsze zrozumienie świata mówionego dzięki szczegółowemu, precyzyjnie opisanemu tekstowi i dźwiękowi, co poprawia wydajność Twoich modeli NLP. Niezależnie od tego, czy szkolisz wirtualnego/cyfrowego asystenta, chcesz przeanalizować umowę prawną, czy stworzyć algorytm analizy finansowej, dostarczamy dane najwyższej jakości, niezbędne do działania Twoich modeli w świecie rzeczywistym. Nasz zespół rozumie język, dialekt, składnię i strukturę zdań, aby precyzyjnie oznaczyć tekst, zgodnie z Twoimi wymaganiami biznesowymi.
Jesteśmy jedną z niewielu firm NLP, które szczycą się swoimi doskonałymi umiejętnościami językowymi. Zatrudniamy ponad 30 000 współpracowników z całego świata, biegle władających ponad 150 językami . Pomagaliśmy startupom we wczesnej fazie rozwoju, małym i średnim przedsiębiorstwom oraz firmom z listy Fortune 500 z różnych branż , takich jak opieka zdrowotna, handel detaliczny/e-commerce, finanse, technologia i wiele innych, aby osiągnąć cele ich projektów NLP.
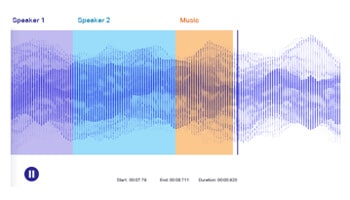
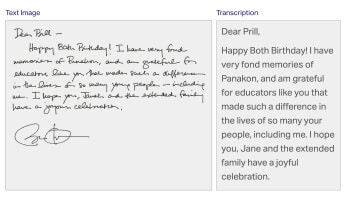
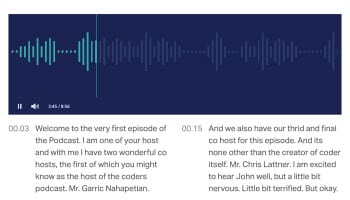
Ponad 50 XNUMX godzin gotowych zestawów danych audio/mowy, które pomogą Ci zacząć.
Analizuj ludzkie emocje, interpretując niuanse w opiniach klientów, mediach społecznościowych itp.

Zbieraj zbiory danych tekstowych, tj. e-maile, SMS-y, blogi, dokumenty, prace badawcze itp.

Szkolenie cyfrowych asystentów wymaga dużego zestawu wysokiej jakości danych z różnych obszarów geograficznych, języków, dialektów, konfiguracji i formatów. W Shaip oferujemy dane szkoleniowe dla modeli AI z obsługą człowieka w pętli, którzy posiadają wymaganą wiedzę, doświadczenie w dziedzinie i są świadomi specyficznych potrzeb klienta.
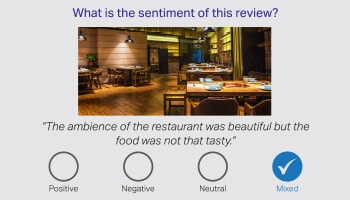
Słusznie mówi się, że same słowa nie oddają całej historii, a na ludzkich adnotatorach spoczywa ciężar zinterpretowania niejednoznaczności w ludzkim języku. Dlatego tak ważne jest zidentyfikowanie Sentymentu klienta na podstawie rozmowy. Nasi eksperci językowi z różnych dziedzin potrafią zinterpretować niuanse w recenzjach produktów, wiadomościach finansowych i mediach społecznościowych.
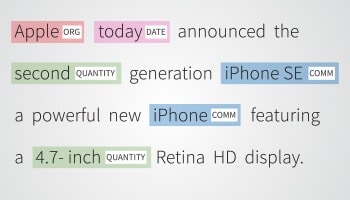
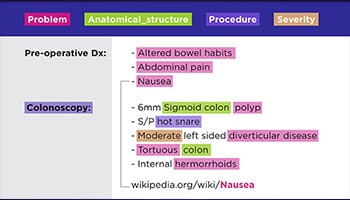
Rozpoznawanie nazwanych jednostek (NER) to identyfikowanie, wyodrębnianie i klasyfikowanie nazwanych jednostek w tekście do wstępnie zdefiniowanych kategorii. Tekst może być skategoryzowany jako miejsce, nazwa, organizacja, produkt, ilość, wartość, procent itp. Dzięki NER możesz odpowiedzieć na rzeczywiste pytania, takie jak, które organizacje zostały wymienione w artykule itp.
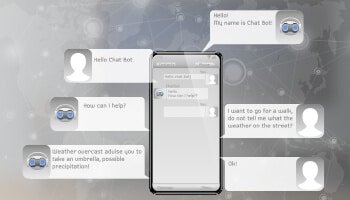
Solidne, dobrze wyszkolone wirtualne chatboty lub asystenci cyfrowi zrewolucjonizowali sposób, w jaki klienci komunikują się ze sprzedawcami, przyczyniając się do znacznej poprawy obsługi klienta.
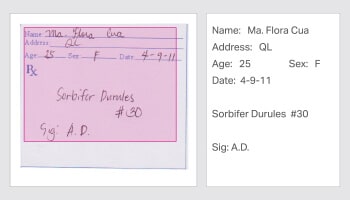
Od odręcznych recept lekarzy po notatki z telekonferencji, nasi specjaliści mogą zdigitalizować dowolną formę danych, tj. dokumenty archiwalne, umowy prawne, dokumentację medyczną pacjentów itp.
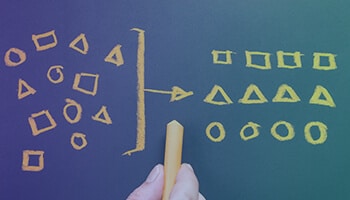
Kategoryzacja, znana również jako klasyfikacja lub oznaczanie, to proces klasyfikowania tekstu w zorganizowane grupy i oznaczania go na podstawie interesujących go cech.
Ludzka ocena i postedycja wyników tłumaczenia maszynowego w celu zmierzenia płynności, adekwatności i dokładności domeny — co pozwala na stworzenie niezawodnych systemów tłumaczenia maszynowego dla wdrożeń wielojęzycznych.
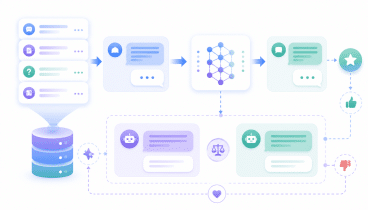
Skrupulatnie dobrane zestawy danych dotyczące przestrzegania instrukcji, pary szybkich odpowiedzi i dane dotyczące preferencji RLHF umożliwiają precyzyjne dostrojenie i dopasowanie dużych modeli językowych do Twojej dziedziny, tonu i wymagań zadania.
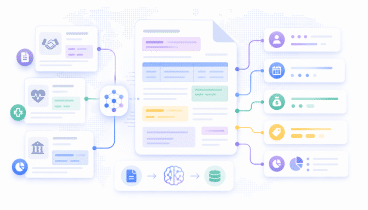
Adnotacje do złożonych struktur dokumentów — umów, dokumentacji medycznej, sprawozdań finansowych — w celu trenowania modeli sztucznej inteligencji dokumentów, które potrafią wyodrębniać, klasyfikować i rozumować na podstawie niestrukturyzowanego tekstu na dużą skalę.
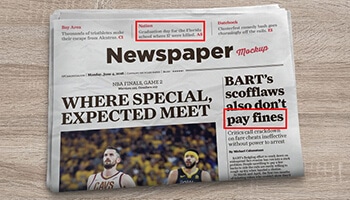
Analiza tematyczna lub etykietowanie tematów polega na identyfikowaniu i wydobywaniu znaczenia z danego tekstu poprzez identyfikowanie powtarzających się tematów/tematów.
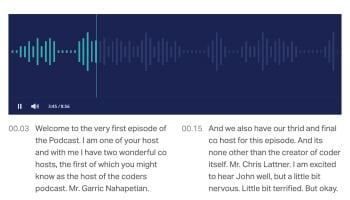
Transkrybuj mowę/podcast/seminarium, zadzwoń do rozmowy na tekst. Wykorzystaj ludzi do dokładnego opisywania plików audio/mowy, aby dokładnie trenować modele NLP.

Kategoryzuj dźwięki lub wypowiedzi, aby sklasyfikować mowę/dźwięk na podstawie języka, dialektu, semantyki, leksykonów itp.
Nasza grupa ekspertów, którzy są biegli w adnotacjach tekstowych/dźwiękowych/oznaczaniu, może pozyskać dokładne i skutecznie opatrzone adnotacjami zestawy danych NLP.
Nasz zespół pomaga przygotować dane tekstowe/dźwiękowe do trenowania silników AI, oszczędzając cenny czas i zasoby.
Nasz zespół współpracowników może pomieścić dodatkową objętość, zachowując jednocześnie jakość danych wyjściowych dla Twoich rozwiązań NLP.
Jako eksperci w zakresie szkoleń i zarządzania zespołami zapewniamy realizację projektów w ramach określonego budżetu.
Zespół analizuje dane z wielu źródeł i jest w stanie wydajnie i w dużych ilościach wytwarzać dane szkoleniowe dotyczące sztucznej inteligencji we wszystkich branżach.
Szeroka gama danych audio/tekstowych zapewnia sztucznej inteligencji mnóstwo informacji potrzebnych do szybszego trenowania.

Dedykowane i przeszkolone zespoły:

Najwyższą wydajność procesu zapewniają:

Opatentowana platforma oferuje korzyści:
Chatboty AI zapewniają lepsze wrażenia użytkownika, ucząc się na podstawie poprzednich interakcji, rozumiejąc zachowania użytkowników i rozumiejąc różne języki przy użyciu zaawansowanych umiejętności podejmowania decyzji.

Automatyczne rozpoznawanie mowy (ASR) przeszło długą drogę. Chociaż został wynaleziony dawno temu, prawie nigdy nie był używany przez nikogo. Jednak czas i technologia znacznie się zmieniły.

Globalny rynek przetwarzania języka naturalnego ma wzrosnąć z 1.8 mld USD w 2021 r. do 4.3 mld USD w 2026 r., osiągając w tym okresie wzrost o 19.0%.
Umożliwianie zespołom tworzenia wiodących na świecie produktów AI.


NLP to dziedzina sztucznej inteligencji, która umożliwia maszynom rozumienie, analizowanie i reagowanie na język ludzki (zarówno tekst, jak i mowę) poprzez interpretację kontekstu, sentymentu i intencji.
NLP polega na przetwarzaniu języka ludzkiego za pomocą algorytmów analizujących gramatykę, składnię, semantykę i kontekst. Wykorzystuje duże ilości danych z adnotacjami do trenowania modeli sztucznej inteligencji w celu wydobywania znaczenia, identyfikowania wzorców i generowania trafnych odpowiedzi.
NLP jest wykorzystywane w aplikacjach takich jak wirtualni asystenci, chatboty, analiza sentymentu, tłumaczenie maszynowe, streszczanie tekstu, wykrywanie spamu i korekta gramatyczna. Umożliwia to systemom, które zwiększają efektywność i naturalność interakcji człowiek-komputer.
Usługi przetwarzania języka naturalnego obejmują gromadzenie tekstu (pozyskiwanie różnorodnych danych tekstowych), gromadzenie dźwięku (nagrywanie danych głosowych), adnotację danych (etykietowanie tekstu i dźwięku w celu szkolenia sztucznej inteligencji) oraz transkrypcję (przekształcanie mowy w tekst w celu analizy).
Rozwiązania NLP wzbogacają modele AI, dostarczając precyzyjnie oznakowane zbiory danych, które pomagają modelom lepiej rozumieć język ludzki. Usprawnia to zadania takie jak analiza sentymentów, rozpoznawanie jednostek nazwanych (NER), sztuczna inteligencja konwersacyjna i szkolenie chatbotów.
Do najważniejszych branż zalicza się opiekę zdrowotną (analiza dokumentacji medycznej i opinii pacjentów), finanse (wykrywanie oszustw i analiza dokumentów) oraz handel elektroniczny (spersonalizowane rekomendacje i automatyzacja obsługi klienta).
Harmonogramy różnią się w zależności od rozmiaru i złożoności projektu, ale są zoptymalizowane w celu wydajnego dostarczania wysokiej jakości danych.
Jakość gwarantują rygorystyczne procesy walidacji, eksperci zajmujący się komentowaniem danych oraz zaawansowane narzędzia, dzięki którym dane spełniają najwyższe standardy.
Koszty zależą od takich czynników, jak zakres projektu, złożoność danych i potrzeby personalizacji. Skontaktuj się z Shaip, aby uzyskać spersonalizowaną wycenę dostosowaną do Twoich potrzeb.
NLP jako usługa (ang. NLP as a Service) to w pełni zarządzany model dostarczania danych, w którym dostawca usług NLP zajmuje się każdym etapem procesu przetwarzania danych językowych – ich gromadzeniem, adnotacją, zapewnieniem jakości i dostarczaniem – w Państwa imieniu. Shaip oferuje modele dostarczania oparte na projektach, subskrypcji i osadzone w zespołach, dopasowane do różnych potrzeb organizacji i skali projektów.
Każda pula językowa składa się z native speakerów lub osób posługujących się językiem niemal native speaker, zrekrutowanych i sprawdzonych pod kątem znajomości danej dziedziny. Adnotacje są kalibrowane względem wzorcowych zestawów referencyjnych, a proces kontroli jakości 6 Sigma Stage-Gate z oceną zgodności między adnotatorami zapewnia spójność we wszystkich parach językowych i dialektach.
Shaip obsługuje przepływy pracy zgodne z HIPAA dla projektów NLP w ochronie zdrowia i dostosowuje się do wymogów RODO dotyczących zarządzania zgodami w zakresie gromadzenia danych w UE. Wszystkie projekty obejmują dokumentację ścieżki audytu, rejestry pochodzenia danych oraz kontrolę dostępu opartą na rolach dla zespołów ds. zgodności w przedsiębiorstwie.
Tak. Shaip dostarcza zestawy danych dotyczące przestrzegania instrukcji, pary szybkich odpowiedzi oraz dane dotyczące preferencji RLHF do precyzyjnego dostrajania i dopasowania LLM. Nasza strona poświęcona rozwiązaniom Generative AI obejmuje pełen zakres usług danych szkoleniowych LLM.
Gromadzenie danych polega na pozyskiwaniu surowego tekstu lub dźwięku — materiału wejściowego, z którego będzie czerpał wiedzę Twój model. Adnotacja polega na oznaczaniu surowych danych za pomocą ustrukturyzowanych tagów, kategorii, encji lub wskaźników sentymentu, które informują model, co ma rozumieć. Shaip oferuje zarówno samodzielne usługi, jak i zintegrowane, kompleksowe rozwiązanie do przetwarzania języka naturalnego (NLP).
Tak. Shaip współpracował ze startupami na wczesnym etapie rozwoju, MŚP i przedsiębiorstwami z listy Fortune 500. Oferujemy elastyczne ustalanie zakresu projektu, minimalne pakiety danych dla AI na etapie MVP oraz skalowalne modele dostaw, które rosną wraz z Twoimi wymaganiami dotyczącymi adnotacji. Skontaktuj się z nami, aby otrzymać indywidualną wycenę.

Używamy plików cookie, aby poprawić Twoje doświadczenia na naszej stronie. Korzystając z naszej strony, wyrażasz zgodę na pliki cookie.
Zarządzaj swoimi preferencjami dotyczącymi plików cookie poniżej:
Niezbędne pliki cookie umożliwiają podstawowe funkcje i są niezbędne do prawidłowego funkcjonowania strony internetowej.
Menedżer tagów Google ułatwia zarządzanie tagami marketingowymi na Twojej stronie internetowej bez konieczności zmiany kodu.
Pliki cookie statystyczne zbierają informacje anonimowo. Informacje te pomagają nam zrozumieć, w jaki sposób odwiedzający korzystają z naszej witryny.
Google Analytics to potężne narzędzie, które śledzi i analizuje ruch w witrynie internetowej, umożliwiając podejmowanie świadomych decyzji marketingowych.
Adres URL usługi: policies.google.com (otwiera się w nowym oknie)
Pliki cookie marketingowe służą do śledzenia odwiedzających strony internetowe. Celem jest wyświetlanie reklam, które są istotne i angażujące dla poszczególnych użytkowników.
Google Ads to internetowa platforma reklamowa umożliwiająca firmom tworzenie ukierunkowanych reklam wyświetlanych w wynikach wyszukiwania Google i witrynach partnerskich.
Adres URL usługi: policies.google.com (otwiera się w nowym oknie)
HubSpot to kompleksowa platforma łącząca marketing, sprzedaż i obsługę klienta, która usprawnia rozwój firmy.
Adres URL usługi: legal.hubspot.com (otwiera się w nowym oknie)
Więcej informacji znajdziesz w naszej Polityce plików cookie i Polityce prywatności.