
Usługi danych szkoleniowych AI dla uczenia maszynowego i generatywnej sztucznej inteligencji
Shaip to wiodący dostawca danych szkoleniowych do sztucznej inteligencji, który pomaga zespołom zajmującym się sztuczną inteligencją i uczeniem maszynowym tworzyć dokładne, obiektywne modele gotowe do produkcji — od gromadzenia danych i adnotacji po dostrajanie LLM i ocenę modelu. Usługi te są dostępne w ponad 65 językach i ponad 60 krajach.
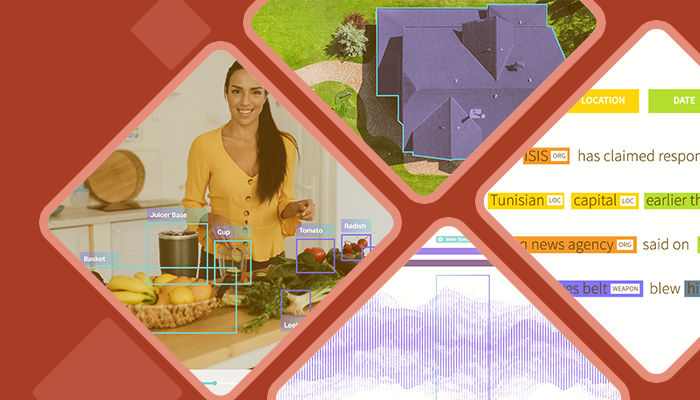
Podstawy każdego modelu sztucznej inteligencji
Czym są dane szkoleniowe AI?
Dane treningowe sztucznej inteligencji to oznaczone lub ustrukturyzowane informacje wykorzystywane do uczenia modelu uczenia maszynowego, jak rozpoznawać wzorce i formułować prognozy. Jakość, różnorodność i dokładność tych danych bezpośrednio decydują o skuteczności modelu w świecie rzeczywistym.
Wysokiej jakości dane treningowe AI odzwierciedlają rzeczywiste wykorzystanie, są precyzyjnie oznaczone, zrównoważone w celu ograniczenia stronniczości i zgodne z przepisami o ochronie danych. Dane niskiej jakości są główną przyczyną niedokładnych prognoz, halucynacji modeli i kosztownych cykli ponownego trenowania – dlatego wiodące zespoły AI współpracują ze specjalistyczną firmą zajmującą się danymi treningowymi AI, taką jak Shaip, zamiast polegać na doraźnym, wewnętrznym etykietowaniu.
Kompleksowe usługi danych AI
Nasze usługi danych szkoleniowych AI
Wszystko, czego potrzebujesz w całym cyklu życia modelu — od pozyskiwania surowych danych po dostrajanie i ocenę modelu.
Usługi gromadzenia danych
Niestandardowe zestawy danych audio, mowy, obrazów, wideo i tekstu — rzeczywiste dane zebrane za pełną zgodą użytkowników w ponad 60 krajach i 65 ponad językach, dzięki czemu Twój model uczy się na podstawie zróżnicowanych, reprezentatywnych przykładów.
→ Dowiedz się więcejAdnotacje i etykiety danych
Dokładne co do piksela etykietowanie przez przeszkolonych adnotatorów i ekspertów dziedzinowych — pola ograniczające, segmentacja, NER, tagowanie sentymentu i intencji oraz transkrypcja — weryfikowane za pomocą wielostopniowej kontroli jakości.
→ Dowiedz się więcejGeneratywna sztuczna inteligencja i dane LLM
SFT, RLHF, pary szybkich odpowiedzi, ranking preferencji ludzkich i zbiory danych RAG dostarczone przez ekspertów przedmiotowych w celu zwiększenia dokładności, ograniczenia halucynacji i dostosowania zachowań modelu.
→ Dowiedz się więcejWalidacja i ocena danych
Walidacja z udziałem człowieka, audyty stronniczości i uczciwości oraz testy porównawcze jakości w celu pomiaru i poprawy dokładności modelu przed i po wdrożeniu.
→ Dowiedz się więcejGotowe zbiory danych
Gotowe do użycia, wstępnie oznaczone zestawy danych z naszego katalogu danych — ponad 30 mln zanonimizowanych dokumentacji medycznych, ponad 70 000 godzin nagrań głosowych i scenariusze fizycznej sztucznej inteligencji.
Przeglądaj katalog danych →Dane fizyczne dotyczące sztucznej inteligencji i robotyki
LiDAR i adnotacje do chmur punktów, łączenie czujników, trójwymiarowe pola ograniczające, trajektorie robotów i scenariusze zadań ze świata rzeczywistego, które służą do szkolenia autonomicznych maszyn, robotów i ucieleśnionej sztucznej inteligencji.
Zobacz sztuczną inteligencję i robotykę fizyczną →Każda modalność, jeden partner
Dane szkoleniowe AI według typu danych
W każdym przypadku realizujemy obie połowy zadania – pozyskujemy surowe dane, których nie znajdziesz od ręki, i oznaczamy je zgodnie ze standardem wymaganym przez Twój model. Jeden partner, jeden proces zapewnienia jakości – od gromadzenia, przez adnotację, po dostarczenie.
Zbieranie i adnotacja danych tekstowych
Gromadzimy: teksty i dokumenty dotyczące konkretnej dziedziny — notatki kliniczne, umowy, transkrypcje rozmów na czacie i podczas pomocy technicznej oraz zestawy szybkich odpowiedzi napisane przez sprawdzonych specjalistów w ponad 65 językach.
Adnotujemy: NER, klasyfikacja sentymentu, intencji, łączenie encji i tagowanie dokumentów, które przekształcają niestrukturyzowany tekst w dane szkoleniowe NLP i LLM.
Zbieranie i adnotacja mowy i dźwięku
Gromadzimy: przygotowane, spontaniczne i nagrane w call center przemówienia rodzimych użytkowników ponad 65 języków, akcentów, dialektów i rzeczywistych środowisk akustycznych.
Adnotujemy: transkrypcja, dziennikowanie i identyfikacja mówcy, znaczniki czasu, oznaczanie emocji i intencji na potrzeby ASR, asystentów głosowych i konwersacyjnej sztucznej inteligencji.
Usługi gromadzenia i adnotacji obrazów
Gromadzimy: niestandardowe zestawy danych obrazowych dostosowane do Twoich wymagań — twarze i dane biometryczne, dokumenty i paragony, półki sklepowe, obrazowanie medyczne oraz skrajne przypadki w oświetleniu i regionach geograficznych, w których będzie prezentowany Twój model.
Adnotujemy: Pola ograniczające 2D/3D, wielokąty, segmentacja semantyczna z dokładnością do jednego piksela, punkty orientacyjne i kluczowe.
Usługi gromadzenia i adnotacji wideo
Gromadzimy: egocentryczne, wielokamerowe, z monitoringu, kamer samochodowych i nagrań ze sklepów, nagrane przez globalną sieć współpracowników w scenariuszach skryptowych i rzeczywistych.
Adnotujemy: śledzenie obiektów klatka po klatce, szacowanie aktywności i pozycji oraz klasyfikacja zdarzeń na potrzeby sztucznej inteligencji w robotyce, autonomicznej jeździe, sporcie i sprzedaży detalicznej.
Fizyczna sztuczna inteligencja, robotyka i dane z czujników
Gromadzimy: rejestrowanie obrazu z wielu czujników w rzeczywistych środowiskach — LiDAR, głębokość, IMU, przechwytywanie ruchu VR, teleoperacja i trajektorie robotów w ponad 1,400 scenariuszach zadań i 9 środowiskach.
Adnotujemy: Trójwymiarowe pola ograniczające, segmentacja chmury punktów, łączenie czujników i etykietowanie wizyjno-językowe dla ucieleśnionej sztucznej inteligencji.
Generowanie i walidacja danych syntetycznych
Generujemy: reprezentatywne syntetyczne dane tekstowe, graficzne i sensorowe, w przypadku których gromadzenie danych w świecie rzeczywistym jest ograniczone, wrażliwe lub niebezpieczne — rzadkie zdarzenia, skrajne przypadki typu „długi ogon” i domeny o ograniczonej prywatności.
Sprawdzamy: recenzja ludzka, sprawdzanie stronniczości oraz łączenie zestawów rzeczywistych i syntetycznych, dzięki czemu jakość utrzymuje się w produkcji.
Ekspertyza ludzka dla nowoczesnej sztucznej inteligencji
Generative AI i dane szkoleniowe LLM
Zbudowanie lub dopracowanie dużego modelu językowego wymaga czegoś więcej niż tylko surowego tekstu. Shaip oferuje specjalistyczną wiedzę, dzięki której modele generatywne są dokładne, bezpieczne i spójne.
Nadzorowane dostrajanie (SFT)
Wysokiej jakości teksty typu „szybka odpowiedź” napisane przez ekspertów w danej dziedzinie.
RLHF i ranking preferencji
Porównania opinii i odpowiedzi człowieka w celu ujednolicenia zachowań modelu.
RAG i dane rozszerzone o wyszukiwanie
Bazy wiedzy dziedzinowej, dzielenie dokumentów na fragmenty i pary zapytanie-fragment, które pozwalają na osadzanie odpowiedzi modelu we własnych treściach.
Ocena modelu
Audyt halucynacji, weryfikacja faktów i ocena jakości.
Dane ekspertów domenowych
Monity, odpowiedzi i oceny przygotowane przez sprawdzonych specjalistów z zakresu opieki zdrowotnej, prawa, finansów i innych dziedzin.
Wielojęzyczny zasięg
Doświadczeni adnotatorzy w ponad 65 językach i specjalistycznych dziedzinach.
Dane dla świata rzeczywistego
Dane dotyczące fizycznego treningu sztucznej inteligencji i robotyki
Roboty, pojazdy autonomiczne i ucieleśniona sztuczna inteligencja uczą się ze świata fizycznego – a to wymaga precyzyjnych danych 3D, czujników i ruchu. Shaip dostarcza multimodalne, rzeczywiste zestawy danych obejmujące ponad 1,400 scenariuszy zadań i 9 środowisk, aby trenować percepcję, nawigację i manipulację.
LiDAR i adnotacje do chmury punktów
Trójwymiarowe pola ograniczające, segmentacja semantyczna i śledzenie obiektów w chmurach punktów.
Połączenie czujnika
Dopasowane dane z kamery, LiDAR-u, radaru i IMU umożliwiają solidną percepcję wieloczujnikową.
Trajektorie robotów i teleoperacja
Dane demonstracyjne, działania i manipulacje służące uczeniu się przez naśladownictwo i wzmacnianie.
Aktywność człowieka i ocena pozycji
Kluczowe punkty, gesty i dane dotyczące interakcji na rzecz bezpiecznej współpracy człowieka i robota.
Wykrywanie i śledzenie obiektów
Wykrywanie, klasyfikowanie i śledzenie wielu obiektów za pośrednictwem strumieni kamer i czujników w celu zapewnienia percepcji w czasie rzeczywistym.
Scenariusze zadań ze świata rzeczywistego
Ponad 1,400 scenariuszy w 9 środowiskach dla robotyki magazynowej, domowej, przemysłowej i zewnętrznej.
Dlaczego warto wybrać Shaip jako dostawcę danych szkoleniowych dla sztucznej inteligencji
Możliwości gromadzenia danych
Twórz, selekcjonuj i zbieraj niestandardowe zestawy danych (tekst, mowa, obrazy, wideo) z całego świata w oparciu o niestandardowe wytyczne.
Elastyczna globalna siła robocza
Wykorzystaj ponad 10 000 pracowników na całym świecie i ponad 500 000 akredytowanych współpracowników w modelu crowdsourcing. Aktualizowane w czasie rzeczywistym możliwości i wydajność siły roboczej.
Jakość
Nasza autorska platforma i wykwalifikowana kadra stosują wiele metod kontroli jakości w celu spełnienia, a nawet przekroczenia standardów jakościowych.
Różnorodny, dokładny i szybki
Nasz proces usprawnia proces gromadzenia danych dzięki łatwiejszemu podziałowi zadań i przechwytywaniu danych bezpośrednio z aplikacji i sieci.
Zabezpieczenia danych
Zachowaj pełną poufność danych, traktując prywatność jako priorytet. Zapewniamy, że formaty danych są kontrolowane i zachowywane zgodnie z zasadami.
Pełny cykl życia
Jeden partner zajmujący się gromadzeniem, adnotacją, dostrajaniem generatywnej sztucznej inteligencji i oceną
Jak to działa
W jaki sposób dostarczamy Twoje dane treningowe
Bezpieczeństwo i zgodność


Opowiedz nam o swojej kolejnej inicjatywie w dziedzinie sztucznej inteligencji.
Od gromadzenia danych, przez adnotacje, licencjonowanie, po walidację — pomożemy Ci szybciej wprowadzić produkt na rynek, korzystając z danych, którym możesz zaufać.
KontaktCzęsto Zadawane Pytania (FAQ)
1. Czym są dane szkoleniowe AI?
Dane treningowe AI to oznaczone lub ustrukturyzowane dane wykorzystywane do nauki modelu uczenia maszynowego rozpoznawania wzorców i formułowania prognoz. Mogą to być dane tekstowe, audio, obrazy, wideo lub multimodalne, a ich jakość bezpośrednio decyduje o dokładności modelu.
2. Do czego służą dane szkoleniowe AI?
Służy do szkolenia, dostrajania i oceny modeli sztucznej inteligencji (AI) i uczenia maszynowego — w tym systemów przetwarzania obrazu, rozpoznawania mowy, sztucznej inteligencji konwersacyjnej i rozbudowanych modeli językowych.
3. Jakiego rodzaju dane szkoleniowe AI dostarcza Shaip?
Shaip dostarcza dane tekstowe, głosowe i dźwiękowe, obrazy, wideo, multimodalne, fizyczno-sztucznej inteligencji/czujników oraz syntetyczne — poprzez usługi gromadzenia, adnotacji i etykietowania, dostrajania LLM i walidacji.
4. W jaki sposób Shaip zapewnia jakość danych szkoleniowych?
W każdym projekcie wykorzystujemy adnotatorów będących ekspertami w danej dziedzinie oraz wielostopniową kontrolę jakości z udziałem człowieka, obejmującą przegląd konsensusu, próbkowanie i sprawdzanie stronniczości, z uwzględnieniem ilościowych raportów dotyczących jakości.
5. Jakie języki i kraje obejmuje Shaip?
Shaip obsługuje ponad 65 języków i pozyskuje dane za zgodą użytkowników z ponad 60 krajów, dysponując siecią ponad 1,000 sprawdzonych specjalistów ds. danych.
6. Czy moje dane są bezpieczne i jakie certyfikaty posiada Shaip?
Tak. Shaip posiada certyfikaty ISO 27001 i ISO 9001:2015, przeszedł audyt SOC 2 typu II, jest zgodny z HIPAA i gotowy do wdrożenia RODO/CCPA, a także oferuje maskowanie danych osobowych, szyfrowanie i dostęp oparty na rolach.
7. Czy Shaip może dostarczyć danych szkoleniowych dla LLM i generatywnej sztucznej inteligencji?
Tak. Shaip oferuje nadzorowane dostrajanie (SFT), RLHF, ranking preferencji ludzkich, zestawy danych RAG, pary szybka-odpowiedź oraz ocenę modeli dla dużych modeli językowych i generatywnej sztucznej inteligencji.
8. Czy Shaip udostępnia dane dotyczące fizycznego szkolenia w zakresie sztucznej inteligencji i robotyki?
Tak. Shaip dostarcza fizyczne dane szkoleniowe dotyczące sztucznej inteligencji i robotyki, w tym dane LiDAR i adnotacje chmur punktów, łączenie czujników, trójwymiarowe pola ograniczające, trajektorie robotów, dane SLAM i nawigacyjne oraz scenariusze zadań w świecie rzeczywistym, obejmujące ponad 1,400 scenariuszy i 9 środowisk dla systemów autonomicznych i ucieleśnionej sztucznej inteligencji.
9. Jak wyceniane są dane szkoleniowe AI?
Cena zależy od typu danych, ich wolumenu, złożoności adnotacji, języków i czasu realizacji. Shaip przygotowuje indywidualną wycenę po określeniu zakresu zastosowania — poproś o bezpłatną wycenę, aby rozpocząć.
10. Czy Shaip oferuje gotowe zestawy danych?
Tak. Gotowe do użycia, wstępnie oznakowane zestawy danych są dostępne w katalogu danych Shaip, obejmującym dokumentację medyczną, mowę wielojęzyczną i scenariusze fizycznej sztucznej inteligencji, na zasadzie licencji.
11. Jak zacząć korzystać z Shaip?
Skontaktuj się z Shaip, aby przedstawić swój przypadek użycia i określić zakres pilotażu. Ustalamy wytyczne i cele jakościowe, a następnie dostarczamy próbkę lub partię pilotażową przed skalowaniem.
