W naszych dążeniach do budowania solidnych i obiektywnych rozwiązań AI, istotne jest, aby skupić się na trenowaniu modeli na obiektywnym, dynamicznym i reprezentatywnym zbiorze danych. Nasz proces gromadzenia danych jest niezwykle ważny dla rozwoju wiarygodnych rozwiązań AI. W związku z tym, gromadzenie danych szkoleniowych AI za pośrednictwem crowdworkingu staje się kluczowym aspektem strategii gromadzenia danych.
W tym artykule przyjrzymy się roli pracowników społecznościowych, ich wpływowi na opracowywanie algorytmów uczenia się sztucznej inteligencji i modeli uczenia maszynowego oraz potrzebie i korzyściom, jakie niosą dla całego procesu.
Dlaczego pracownicy społecznościowi są potrzebni do tworzenia modeli AI?
Jako ludzie generujemy mnóstwo danych, jednak tylko ułamek tych generowanych i gromadzonych danych ma wartość. Z powodu braku standardów benchmarkingu danych, większość gromadzonych danych jest stronnicza, obarczona problemami jakościowymi lub niereprezentatywna dla środowiska. Ponieważ opracowywanych jest coraz więcej modeli uczenia maszynowego i głębokiego uczenia, które działają na ogromnych ilościach danych, coraz bardziej odczuwalna jest potrzeba lepszych, nowszych i bardziej zróżnicowanych zbiorów danych.
W tym miejscu do gry wchodzą pracownicy masowi.
Crowd-sourcing danych to budowanie zbioru danych z udziałem dużych grup ludzi. Pracownicy z tłumu wprowadzają ludzką inteligencję do sztucznej inteligencji.
Platformy crowdsourcingowe oferują mikrozadania związane ze zbieraniem danych i ich adnotacją dużej i zróżnicowanej grupie osób. Crowdsourcing pozwala firmom uzyskać dostęp do ogromnej, dynamicznej, ekonomicznej i skalowalnej siły roboczej.
Najpopularniejsza platforma crowdsourcingowa – Amazon Mechanical Turk – była w stanie pozyskać 11 tysięcy dialogów międzyludzkich w ciągu 15 godzin, płacąc pracownikom 0.35 dolara za każdy udany dialog. Pracownicy crowdsourcingowi są angażowani za tak skromne wynagrodzenie, co podkreśla wagę budowania etycznych standardów pozyskiwania danych.
Teoretycznie brzmi to jak sprytny plan, ale nie jest to łatwa strategia do wykonania. Anonimowość pracowników społecznościowych doprowadziła do problemów z niskimi płacami, lekceważeniem praw pracowniczych i niską jakością pracy, które mają wpływ na wydajność modelu AI.
Korzyści z posiadania pracowników społecznościowych do pozyskiwania danych
Angażując zróżnicowaną grupę pracowników społecznościowych, twórcy rozwiązań opartych na sztucznej inteligencji mogą rozdzielać mikrozadania i gromadzić różnorodne i rozległe obserwacje szybko i stosunkowo niskim kosztem.
Niektóre z najważniejszych korzyści płynących z zatrudniania pracowników społecznościowych do projektów AI to:
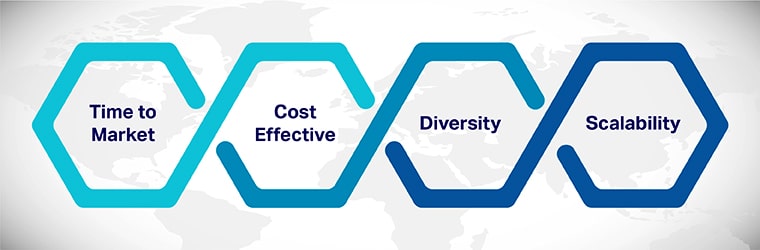
Krótszy czas wprowadzania na rynek: Według badań Cognilytica, prawie 80% czasu projektów sztucznej inteligencji poświęcane jest na czynności związane ze zbieraniem danych, takie jak oczyszczanie, etykietowanie i agregacja. Tylko 20% czasu poświęca się na rozwój i szkolenia. Tradycyjne bariery w generowaniu danych zostają wyeliminowane, ponieważ w krótkim czasie można zrekrutować dużą liczbę współpracowników.
Ekonomiczne rozwiązanie: Gromadzenie danych w modelu crowdsourcingu skraca czas i energię poświęcaną na szkolenie, rekrutację i wdrażanie pracowników. Eliminuje to koszty, czas i zasoby potrzebne do zatrudnienia, ponieważ pracownicy są zatrudniani w oparciu o metodę płatności za zadanie.
Zwiększa różnorodność w zbiorze danych: Różnorodność danych ma kluczowe znaczenie dla całego procesu szkolenia rozwiązań AI. Aby model generował obiektywne wyniki, musi zostać wytrenowany na zróżnicowanym zbiorze danych. Dzięki crowdsourcingowi danych możliwe jest generowanie zróżnicowanych (geograficznych, językowych, dialektowych) zbiorów danych przy niewielkim nakładzie pracy i kosztów.
Zwiększona skalowalność: Rekrutując niezawodnych pracowników crowdworkingowych, możesz mieć pewność, że wysokiej jakości dane będą zbierane w sposób skalowalny w zależności od potrzeb Twojego projektu.

In-house vs. crowdsourcing – kto wygrywa?
| Dane wewnętrzne | Dane pochodzące z crowdsourcingu |
|---|---|
| Można zagwarantować dokładność i spójność danych. | Jakość, dokładność i spójność danych można utrzymać, jeśli zaangażowane zostaną niezawodne platformy crowdsourcingowe ze standardowymi środkami kontroli jakości |
| Wewnętrzne pozyskiwanie danych nie zawsze jest praktyczną decyzją, ponieważ wewnętrzny zespół może nie sprostać wymaganiom projektu. | Różnorodność danych może być zapewniona, ponieważ możliwa jest rekrutacja heterogenicznej grupy pracowników społecznościowych w oparciu o potrzeby projektu. |
| Kosztowna rekrutacja i szkolenie pracowników na potrzeby projektu. | Ekonomiczne rozwiązanie do zbieranie danych ponieważ możliwe jest rekrutowanie, szkolenie i wdrażanie pracowników przy mniejszych nakładach inwestycyjnych. |
| Czas wprowadzenia produktu na rynek jest długi, ponieważ wewnętrzne gromadzenie danych zajmuje dużo czasu. | Czas wprowadzenia na rynek jest znacznie krótszy, ponieważ wiele wkładów przychodzi szybko. |
| Niewielka grupa wewnętrznych współpracowników i znawców | Duża i zróżnicowana grupa współpracowników i etykiety danych |
| Poufność danych jest bardzo wysoka dzięki wewnętrznemu zespołowi. | Poufność danych jest trudna do utrzymania podczas pracy z dużymi pracownikami na całym świecie. |
| Łatwiejsze śledzenie, szkolenie i ocena osób zbierających dane | Trudne do śledzenia i szkolenia zbieraczy danych. |
Wypełnienie luki między pracownikami crowdsourcingu a wnioskodawcą.
Zleceniodawca wyraźnie nie przekazuje informacji, ponieważ pracownicy otrzymują jedynie informacje dotyczące konkretnego zadania. Na przykład, chociaż pracownicy otrzymują mikrozadania, takie jak nagrywanie dialogów w ich ojczystym dialekcie, rzadko otrzymują kontekst. Nie dysponują oni wymaganymi informacjami o tym, dlaczego wykonują to, co robią, i jak najlepiej to zrobić. Ten brak informacji wpływa na jakość pracy wykonywanej w ramach crowdsourcingu.
Dla człowieka posiadanie całego kontekstu zapewnia jasność i cel jego pracy.
Dodaj do tego inny wymiar NDA – umowy o zachowaniu poufności, które ograniczają ilość informacji dostarczanych pracownikowi społecznościowemu. Z punktu widzenia pracowników społecznościowych to wycofanie informacji świadczy o braku zaufania i zmniejszeniu znaczenia ich pracy.
Patrząc na tę samą sytuację z drugiej strony, widać brak przejrzystości ze strony pracownika. Zleceniodawca nie do końca rozumie pracownika, któremu zlecono wykonanie pracy. Niektóre projekty mogą wymagać określonego typu pracownika, jednak w większości projektów występuje niejasność. Prawda jest taka, że może to utrudniać ocenę, przekazywanie informacji zwrotnych i szkolenia w przyszłości.
Aby przeciwdziałać tym trudnościom, ważna jest współpraca z ekspertami w zakresie gromadzenia danych, którzy mają doświadczenie w dostarczaniu różnorodnych, wyselekcjonowanych i dobrze reprezentowanych danych od szerokiego grona współpracowników.
Wybór firmy Shaip jako dostawcy danych może przynieść wiele korzyści. Stawiamy na różnorodność i reprezentatywne rozkłady danych. Nasz doświadczony i oddany personel rozumie komplikacje każdego projektu i opracowuje zestawy danych, które mogą błyskawicznie trenować solidne rozwiązania oparte na sztucznej inteligencji.
[Przeczytaj także: Podręcznik dla początkujących dotyczący danych szkoleniowych AI: definicja, przykład, zestawy danych ]