Sztuczna inteligencja, Big Data i uczenie maszynowe nadal wpływają na decydentów, firmy, naukę, domy mediowe i wiele branż na całym świecie. Raporty wskazują, że globalny wskaźnik adopcji sztucznej inteligencji (AI) w 2022 roku wyniósł 35% – aż o 4% więcej niż w 2021 roku. Dodatkowo 42% firm podobno odkrywa liczne korzyści płynące ze sztucznej inteligencji dla swojego biznesu.
Siłą napędową wielu inicjatyw AI i rozwiązań uczenia maszynowego są dane. Sztuczna inteligencja może być tylko tak dobra, jak dane zasilające algorytm. Dane niskiej jakości mogą prowadzić do niskiej jakości wyników i niedokładnych prognoz.
Chociaż wiele uwagi poświęcono rozwojowi rozwiązań ML i AI, brakuje świadomości, co kwalifikuje się jako wysokiej jakości zbiór danych. W tym artykule analizujemy chronologię danych szkoleniowych wysokiej jakości AI i wskazujemy przyszłość AI poprzez zrozumienie procesu gromadzenia i trenowania danych.
Definicja danych treningowych AI
Podczas budowania rozwiązania ML liczy się ilość i jakość zestawu danych szkoleniowych. System ML nie tylko wymaga dużych ilości dynamicznych, obiektywnych i cennych danych szkoleniowych, ale także potrzebuje ich dużo.
Ale czym są dane szkoleniowe AI?
Dane szkoleniowe AI to zbiór oznaczonych danych służących do uczenia algorytmu uczenia maszynowego w celu wykonywania dokładnych prognoz. System ML stara się rozpoznawać i identyfikować wzorce, rozumieć relacje między parametrami, podejmować niezbędne decyzje i oceniać je na podstawie danych treningowych.
Weźmy na przykład samochody autonomiczne. Szkoleniowy zestaw danych dla samojezdnego modelu ML powinien zawierać oznaczone obrazy i filmy przedstawiające samochody, pieszych, znaki drogowe i inne pojazdy.
Krótko mówiąc, aby poprawić jakość algorytmu ML, potrzebujesz dużej ilości dobrze ustrukturyzowanych, opatrzonych adnotacjami i oznaczonych danych treningowych.
Znaczenie wysokiej jakości danych treningowych i ich ewolucja
Wysokiej jakości dane szkoleniowe to kluczowy wkład w tworzenie aplikacji AI i ML. Dane są zbierane z różnych źródeł i prezentowane w niezorganizowanej formie, nieodpowiedniej do celów uczenia maszynowego. Wysokiej jakości dane szkoleniowe — oznaczone, opatrzone adnotacjami i oznaczone — są zawsze w zorganizowanym formacie — idealnym do szkolenia ML.
Wysokiej jakości dane treningowe ułatwiają systemowi ML rozpoznawanie obiektów i klasyfikowanie ich według z góry określonych cech. Zestaw danych może dawać złe wyniki modelu, jeśli klasyfikacja nie jest dokładna.
Wczesne dni danych szkoleniowych AI
Mimo że współczesny świat biznesu i badań naukowych zdominowany jest przez sztuczną inteligencję, początki, zanim uczenie maszynowe zdominowało sztuczną inteligencję, były zupełnie inne.
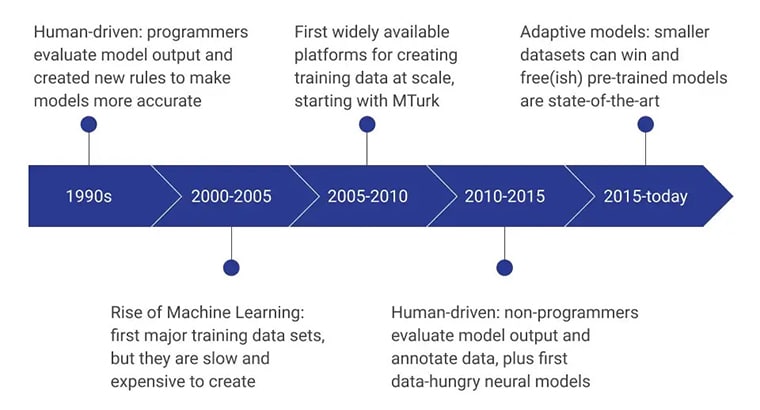
Kilka następnych lat koncentrowało się na tworzeniu i ocenie modeli danych przez osoby niebędące programistami. Obecnie nacisk kładziony jest na wstępnie wytrenowane modele opracowane przy użyciu zaawansowanych metod gromadzenia danych treningowych.
Ilość ponad jakość
Kiedyś, oceniając integralność zbiorów danych szkoleniowych sztucznej inteligencji, naukowcy zajmujący się danymi skupiali się na ilości danych szkoleniowych sztucznej inteligencji, a nie na ich jakości.
Na przykład panowało powszechne błędne przekonanie, że duże bazy danych dostarczają dokładnych wyników. Uważano, że sama ilość danych jest dobrym wskaźnikiem wartości danych. Ilość to tylko jeden z podstawowych czynników decydujących o wartości zbioru danych – uznano rolę jakości danych.
Wzrosła świadomość, że jakość danych zależy od ich kompletności, wiarygodności, trafności, dostępności i aktualności. Co najważniejsze, przydatność danych dla projektu determinowała jakość zebranych danych.
Ograniczenia wczesnych systemów AI z powodu słabych danych treningowych
Słabe dane szkoleniowe w połączeniu z brakiem zaawansowanych systemów obliczeniowych były jedną z przyczyn kilku niespełnionych obietnic wczesnych systemów AI.
Ze względu na brak wysokiej jakości danych treningowych rozwiązania ML nie były w stanie dokładnie zidentyfikować wzorców wizualnych hamujących rozwój badań neuronowych. Chociaż wielu badaczy dostrzegało obietnicę rozpoznawania języka mówionego, badania lub rozwój narzędzi do rozpoznawania mowy nie mogły przynieść rezultatu z powodu braku zbiorów danych dotyczących mowy. Kolejną poważną przeszkodą w opracowywaniu wysokiej klasy narzędzi sztucznej inteligencji był brak możliwości obliczeniowych i pamięci masowej komputerów.
Przejście do danych treningowych wysokiej jakości
Nastąpiła wyraźna zmiana w świadomości, że jakość zbioru danych ma znaczenie. Aby system uczenia maszynowego dokładnie naśladował ludzką inteligencję i możliwości podejmowania decyzji, musi działać na dużej ilości danych szkoleniowych o wysokiej jakości.
Wyobraź sobie swoje dane ML jak ankietę – im większa próba danych , tym lepsza prognoza. Jeśli dane z próby nie obejmują wszystkich zmiennych, mogą one nie rozpoznać wzorców lub prowadzić do błędnych wniosków.
Postępy w technologii sztucznej inteligencji i potrzeba lepszych danych szkoleniowych

Zrozumienie, że lepsze dane treningowe zwiększają szansę na niezawodne modele ML, dało początek lepszym metodologiom gromadzenia danych, adnotacji i etykietowania. Jakość i trafność danych miały bezpośredni wpływ na jakość modelu AI.

Większy nacisk na jakość i dokładność danych
Aby model ML zaczął zapewniać dokładne wyniki, jest zasilany wysokiej jakości zestawami danych, które przechodzą przez iteracyjne etapy udoskonalania danych.
Na przykład człowiek może być w stanie rozpoznać określoną rasę psa w ciągu kilku dni po zapoznaniu się z rasą – na podstawie zdjęć, filmów lub osobiście. Ludzie czerpią ze swojego doświadczenia i powiązanych informacji, aby zapamiętać i wyciągnąć tę wiedzę, gdy jest to konieczne. Jednak nie działa to tak łatwo dla maszyny. Maszyna musi być zasilana wyraźnie opisanymi i oznaczonymi obrazami – setkami lub tysiącami – tej konkretnej rasy i innych ras, aby mogła nawiązać połączenie.
Model sztucznej inteligencji przewiduje wynik, korelując informacje uzyskane w trakcie treningu z informacjami prezentowanymi w świecie rzeczywistym . Algorytm staje się bezużyteczny, jeśli dane treningowe nie zawierają istotnych informacji.
Znaczenie zróżnicowanych i reprezentatywnych danych treningowych
Zbiór danych może być ukierunkowany na określoną populację, rasę, płeć, wybory i opinie intelektualne, co może prowadzić do niedokładnego modelu.
Ważne jest, aby zapewnić, że cały przebieg procesu gromadzenia danych, w tym wybór puli tematów, kuracja, adnotacja i etykietowanie, jest odpowiednio zróżnicowany, zrównoważony i reprezentatywny dla populacji.

Przyszłość danych szkoleniowych AI
Przyszły sukces modeli AI zależy od jakości i ilości danych szkoleniowych wykorzystywanych do uczenia algorytmów uczenia maszynowego. Bardzo ważne jest, aby zdać sobie sprawę, że ta zależność między jakością i ilością danych jest specyficzna dla zadania i nie ma jednoznacznej odpowiedzi.
Ostatecznie adekwatność zestawu danych szkoleniowych jest definiowana przez jego zdolność do niezawodnego działania w celu, w którym został zbudowany.
Postępy w gromadzeniu danych i technikach adnotacji
Ponieważ uczenie maszynowe jest wrażliwe na podawane dane, niezbędne jest usprawnienie zasad gromadzenia danych i adnotacji. Błędy w gromadzeniu danych, kuracji, wprowadzaniu w błąd, niekompletnych pomiarach, niedokładnej treści, powielaniu danych i błędnych pomiarach przyczyniają się do niewystarczającej jakości danych.
Zautomatyzowane gromadzenie danych poprzez eksplorację danych, pobieranie danych z sieci i ekstrakcję danych toruje drogę do szybszego generowania danych. Ponadto wstępnie spakowane zestawy danych działają jako szybka technika gromadzenia danych.
Crowdsourcing to kolejna przełomowa metoda gromadzenia danych. Choć nie można zagwarantować wiarygodności danych, jest to doskonałe narzędzie do budowania wizerunku publicznego. Wreszcie, wyspecjalizowani eksperci w zakresie gromadzenia danych dostarczają również dane pozyskane w określonych celach.
Większy nacisk na względy etyczne w danych szkoleniowych
Ponieważ dane obejmują teraz wszystko, od obrazów twarzy, odcisków palców, nagrań głosu i innych krytycznych danych biometrycznych, niezwykle ważne staje się zapewnienie przestrzegania praktyk prawnych i etycznych w celu uniknięcia kosztownych procesów sądowych i uszczerbku na reputacji.
Potencjał jeszcze lepszej jakości i zróżnicowanych danych treningowych w przyszłości
W przyszłości istnieje ogromny potencjał dla wysokiej jakości i różnorodności danych treningowych . Dzięki świadomości jakości danych i dostępności dostawców danych, którzy spełniają wymagania jakościowe rozwiązań AI.
Obecni dostawcy danych są biegli w wykorzystywaniu przełomowych technologii do etycznego i legalnego pozyskiwania ogromnych ilości różnorodnych zbiorów danych. Mają również wewnętrzne zespoły do oznaczania, opisywania i prezentowania danych dostosowanych do różnych projektów ML.

Wniosek
Współpraca z rzetelnymi dostawcami, którzy posiadają dogłębną wiedzę na temat danych i ich jakości, jest kluczowa dla tworzenia zaawansowanych modeli AI . Shaip to wiodąca firma zajmująca się adnotacjami, specjalizująca się w dostarczaniu niestandardowych rozwiązań w zakresie danych, które spełniają potrzeby i cele Twojego projektu AI. Nawiąż z nami współpracę i odkryj nasze kompetencje, zaangażowanie i możliwości współpracy.