
Każdego dnia Twoja organizacja produkuje górę słów. Zgłoszenia pomocy technicznej, umowy, notatki kliniczne, opinie klientów, e-maile, transkrypcje rozmów. Około 80% wszystkich danych przedsiębiorstwa istnieje w postaci nieustrukturyzowanego tekstu, takiego jak ten — i do niedawna prawie nic z nich nie dało się przeanalizować na dużą skalę. Po prostu tam leżały.
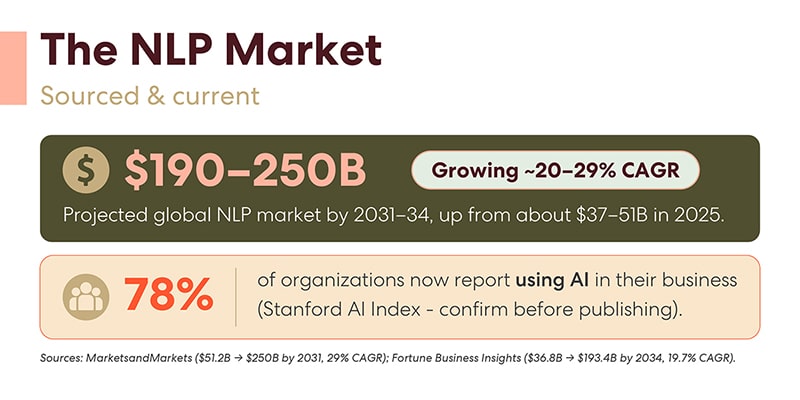
Przetwarzanie języka naturalnego to zmieniło. A w 2026 roku, gdy duże modele językowe przejmują teraz główną rolę, przetwarzanie języka naturalnego (NLP) przeszło z niszowej dziedziny badań do siły napędowej niemal każdego produktu AI, z którym się stykamy. Rynek to odzwierciedla: analitycy przewidują, że NLP wzrośnie z około 37–51 mld dolarów w 2025 roku do 190–250 mld dolarów na początku lat 2030. XXI wieku, a 78% organizacji już deklaruje wykorzystanie sztucznej inteligencji (AI) w swojej działalności.
Czym właściwie jest dziś NLP, jak właściwie działa i dokąd zmierza? Przyjrzyjmy się temu bliżej.
Najpierw wyjaśnijmy największe nieporozumienie: NLP kontra LLM
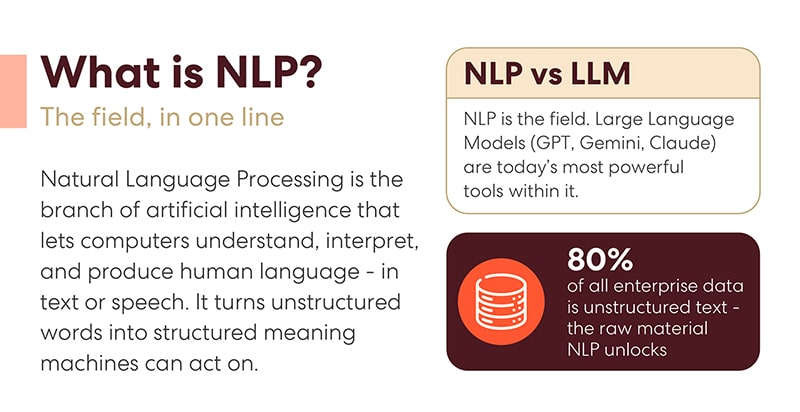
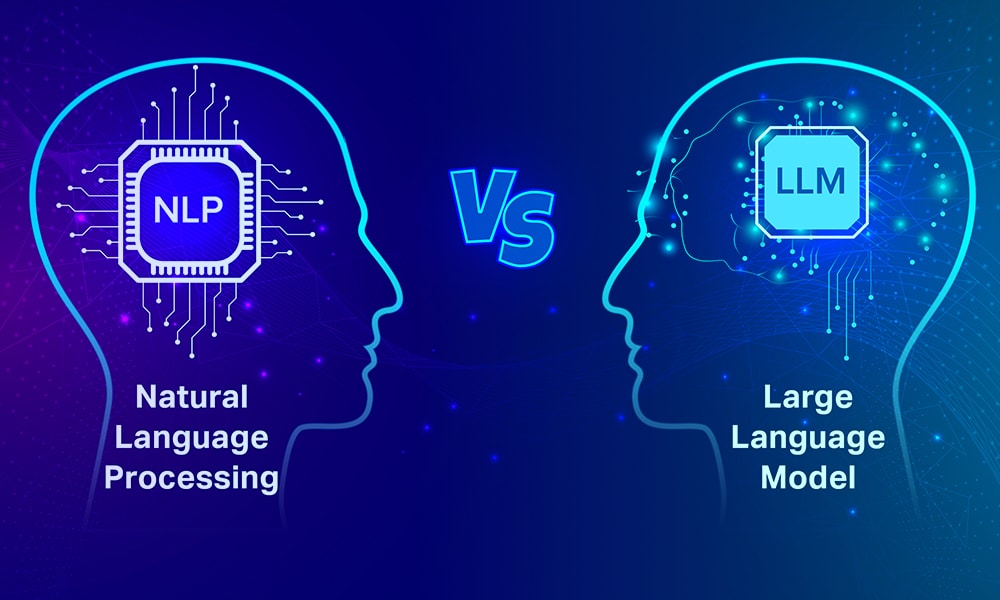
Zapytaj dziesięć osób o różnicę między NLP a LLM, a otrzymasz dziesięć wymijających odpowiedzi. Oto prostsza wersja: NLP to dziedzina – cała gałąź sztucznej inteligencji zajmująca się maszynowym rozumieniem, interpretowaniem i generowaniem języka ludzkiego. Duże Modele Językowe, takie jak GPT, Gemini i Claude, to narzędzia w tej dziedzinie. Są to najpotężniejsze narzędzia, jakie NLP kiedykolwiek stworzyło, dlatego te dwa terminy są ze sobą mylone.
Pomyśl o tym jak o medycynie i rezonansie magnetycznym. Rezonans magnetyczny zrewolucjonizował medycynę, ale nikt nie mówi, że medycyna to rezonans magnetyczny. Ta sama zależność. Każdy LLM to system NLP; NLP jest o wiele większy niż jakikolwiek pojedynczy model.
To rozróżnienie ma również znaczenie praktyczne. Wiele problemów biznesowych – takich jak kierowanie zgłoszeń do pomocy technicznej, zgłaszanie klauzul umownych, oznaczanie sentymentów w recenzjach – nie wymaga specjalistycznego LLM. Potrzebują odpowiedniego podejścia NLP, które często jest mniejsze, tańsze i szybsze.
Jak właściwie działa współczesne NLP
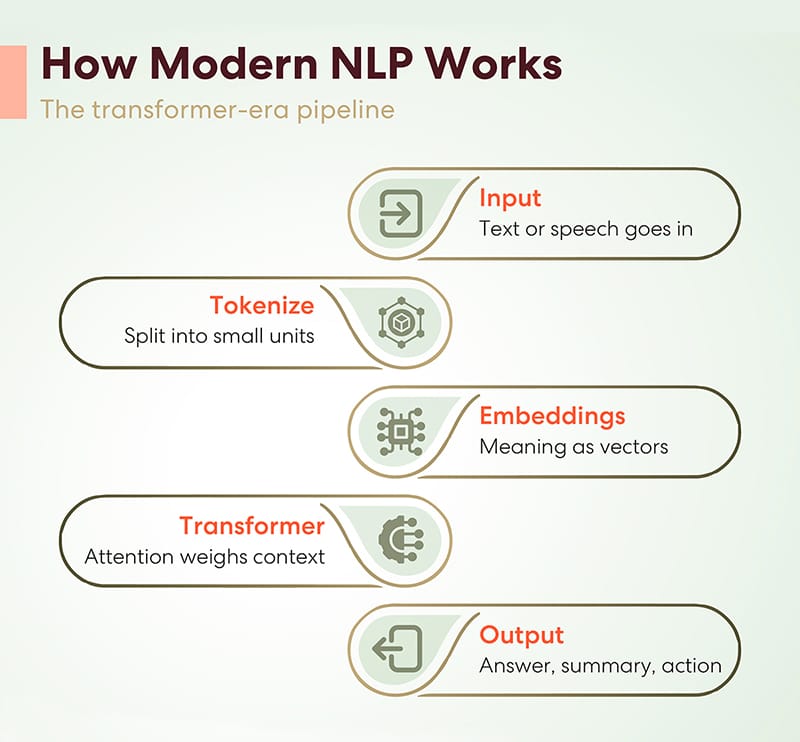
Odrzućmy ten szum informacyjny i przekonajmy się, że niemal każdy współczesny system przetwarzania języka naturalnego działa w oparciu o ten sam pięcioetapowy proces.
Pojawia się tekst lub mowa. System tokenizuje je, dzieląc język na małe jednostki, które model może obsłużyć. Te tokeny stają się osadzeniami — wektorami numerycznymi, które kodują znaczenie, dzięki czemu „lekarz” i „doktor” lądują blisko siebie w przestrzeni matematycznej. Następnie pojawia się część, która wszystko zmieniła: transformator , którego mechanizm uwagi waży każdy token względem każdego innego tokena, aby ustalić, co tak naprawdę ma znaczenie w kontekście. W ten sposób model wie, że w zdaniu „bank zatwierdził pożyczkę” nie mówisz o rzece. Na koniec model generuje wynik — odpowiedź, podsumowanie, tłumaczenie, działanie.
To wszystko. Wejście → tokenizacja → osadzanie → uczestnictwo → wyjście. Architektura transformatorowa, wprowadzona niecałą dekadę temu, leży teraz u podstaw praktycznie każdego systemu sztucznej inteligencji opartego na języku w produkcji. Kiedy ludzie mówią o „erze LLM”, tak naprawdę mają na myśli erę transformatorów na dużą skalę.
Co potrafi NLP — i jak zmienił się opis stanowiska pracy
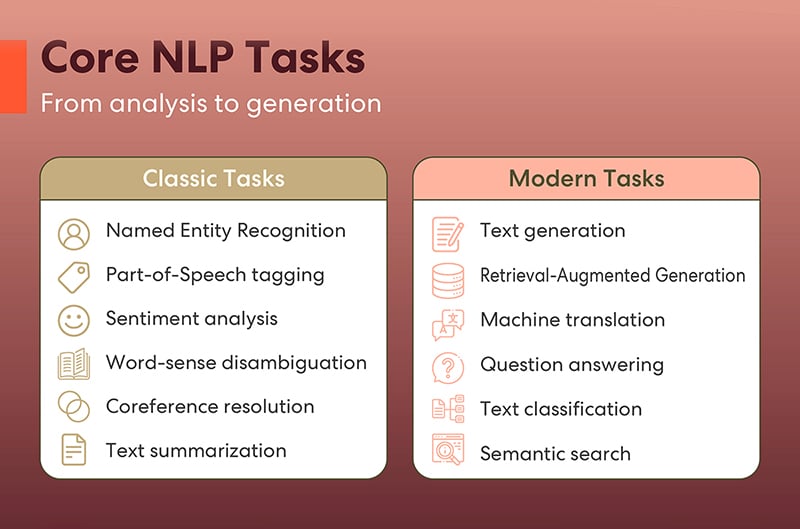
Lista zadań NLP opowiada historię ewolucji tej dziedziny.
Klasyczne zadania polegały na analizie : wyciąganiu nazw, firm i dat z tekstu (rozpoznawanie jednostek nazwanych), tagowaniu części mowy, wykrywaniu sentymentu, określaniu, które znaczenie słowa pasuje do kontekstu (ujednoznacznianie sensu słowa), określaniu, do czego odnosi się „to” (rozwiązywanie koreferencji) oraz skróceniu długich dokumentów do streszczeń. Nadal są to konie pociągowe – po cichu napędzające systemy zgodności, wyszukiwarki i procesy obiegu dokumentów na całym świecie.
Ale era współczesna dodała do tego wszystkiego pokolenie . Dzisiejsze systemy nie tylko odczytują język, ale go produkują: tworzą tekst, odpowiadają na pytania, tłumaczą między językami, klasyfikują dokumenty na dużą skalę, obsługują wyszukiwanie semantyczne, które dopasowuje intencję, a nie słowa kluczowe, oraz realizują generowanie wspomagane wyszukiwaniem – więcej o tym poniżej, ponieważ zasługuje ono na osobne wyróżnienie.
Przejście od analizy do generowania to największa zmiana w historii przetwarzania języka naturalnego. Maszyny przeszły od oceniania esejów do ich pisania.
Siedem idei napędzających obecnie NLP
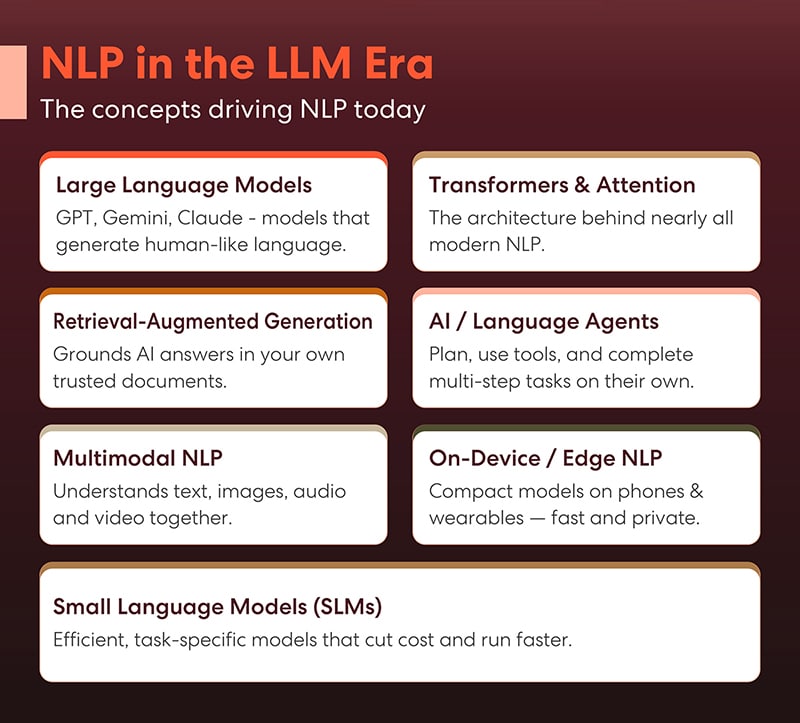
Obecną sytuację definiuje siedem koncepcji — a ich znajomość pomoże Ci przeanalizować ofertę każdego dostawcy sztucznej inteligencji w roku 2026.
Duże Modele Językowe (LLM) to sztandarowy wyczyn: GPT, Gemini i Claude generują język zbliżony do ludzkiego z płynnością, która jeszcze kilka lat temu wydawała się niemożliwa. To dzięki nim NLP przestało być narzędziem w zapleczu, a stało się narzędziem do rozmów w salach konferencyjnych.
Transformatory i uwaga to mechanizmy leżące u podstaw. Niemal każdy współczesny system przetwarzania języka naturalnego (NLP) – od pionierskich systemów LLM po autouzupełnianie w telefonie – opiera się na tej architekturze, która pozwala modelom na jednoczesne analizowanie kontekstu w całym dokumencie.
Generacja Wzbogaconego Pobierania (RAG) jest ulubioną generacją przedsiębiorstw spośród siedmiu, ponieważ opiera odpowiedzi sztucznej inteligencji na własnych, zaufanych dokumentach. Zamiast ufać pamięci modelu, kierujesz go do swojej zweryfikowanej bazy wiedzy — a halucynacje gwałtownie spadają.
Agenci AI i językowi stosują modele od odpowiadania na pytania do realizacji zadań: planowania kroków, korzystania z narzędzi i wykonywania wieloetapowych zadań przy minimalnym nadzorze. Jeśli rok 2024 był rokiem chatbotów, to rok 2026 zapowiada się jako rok agentów.
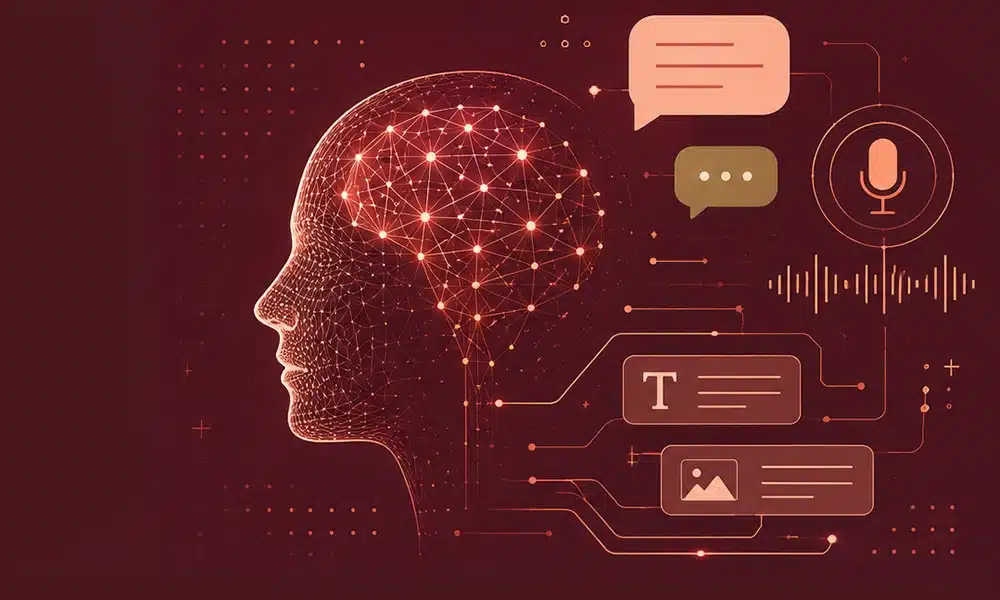
Multimodalne przetwarzanie języka naturalnego (NLP) zaciera granicę między tekstem a wszystkim innym. Nowoczesne systemy przetwarzają tekst, obrazy, dźwięk i wideo jednocześnie – odczytując wykres, słuchając rozmowy i podsumowując oba te elementy w jednym przebiegu.
Przetwarzanie języka naturalnego na urządzeniu/krawędzi urządzenia (NLP) wprowadza kompaktowe modele do telefonów i urządzeń noszonych, gdzie wnioskowanie odbywa się lokalnie. Korzyścią jest szybkość i prywatność: Twoje dane nigdy nie opuszczają urządzenia.
Małe modele językowe (ang. Small Language Models, SLM) stanowią przeciwwagę dla trendu „im większy, tym lepszy”: są to wydajne modele ukierunkowane na konkretne zadania, kosztujące ułamek ceny pionierskiego LLM i działające szybciej — często stanowiąc mądrzejszy wybór w przypadku ściśle określonego zadania.
Gdzie NLP zarabia na swoje utrzymanie
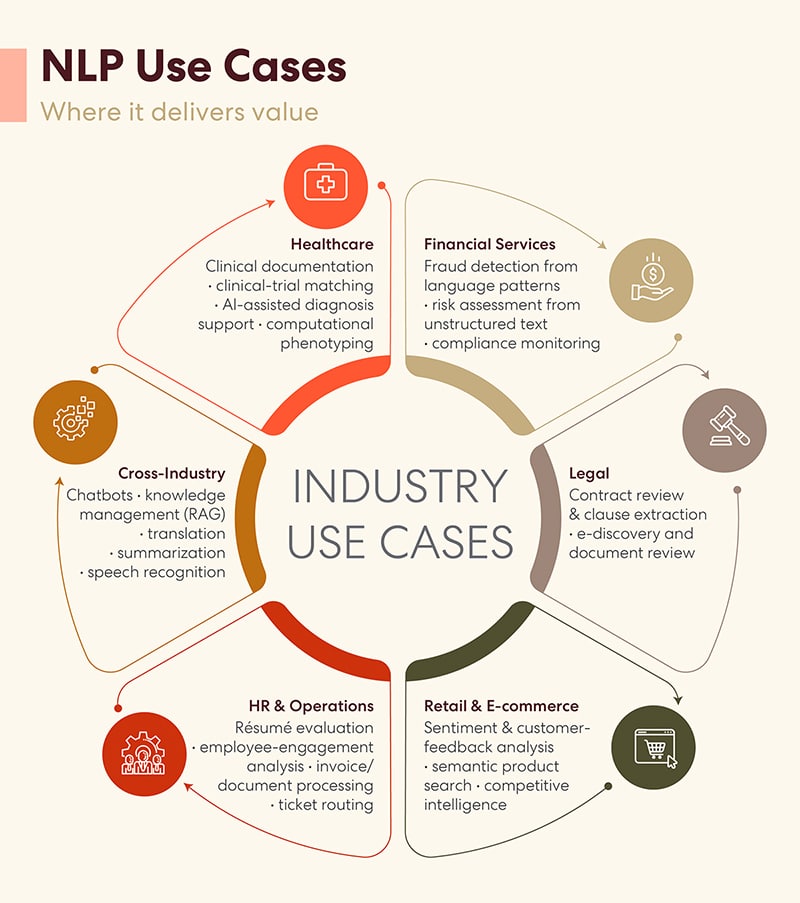
Przykłady zastosowań nie są już spekulatywne – stanowią pozycje budżetowe w różnych branżach.
W opiece zdrowotnej NLP tworzy dokumentację kliniczną (oddając lekarzom godziny tygodniowo), dopasowuje pacjentów do badań klinicznych i wspiera diagnozę, wydobywając notatki, których żaden człowiek nie byłby w stanie odczytać na dużą skalę. W usługach finansowych wykrywa oszustwa na podstawie wzorców językowych i monitoruje komunikację pod kątem zgodności – zadanie, które kiedyś wymagało armii recenzentów. Zespoły prawne wykorzystują je do przeglądu umów, ekstrakcji klauzul i elektronicznego ujawniania informacji, skracając tygodnie przeglądu dokumentów do kilku dni. Sprzedawcy detaliczni analizują opinie klientów pod kątem sentymentu i wspomagają wyszukiwanie semantyczne, które rozumie intencje, a nie tylko słowa kluczowe. Zespoły HR i operacyjne stosują je do weryfikacji CV, analizy zaangażowania, przetwarzania faktur i kierowania zgłoszeń.
I w każdej branży: chatboty, zarządzanie wiedzą poprzez RAG, tłumaczenia, streszczenia i rozpoznawanie mowy. Wspólny mianownik jest zawsze ten sam — tekst, który wcześniej był bezużyteczny, staje się danymi, na podstawie których można działać.
Uczciwy obraz: korzyści i co nadal idzie nie tak
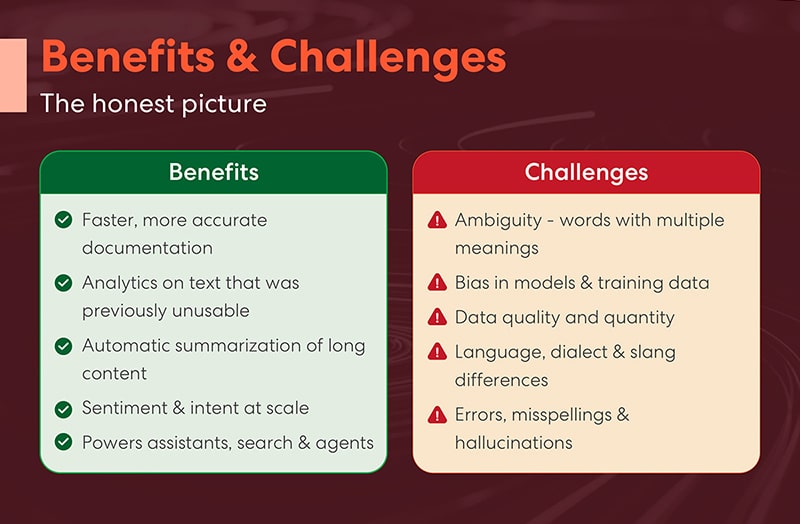
Korzyści z tego wszystkiego są konkretne. Dokumentacja jest pisana szybciej i dokładniej. Tekst, który wcześniej był bezużyteczny, staje się analizowalny. Długie treści same się podsumowują. Sentyment i intencje można odczytać na dużą skalę, analizując miliony interakcji. A cały stos obsługuje asystentów, wyszukiwarki i agentów, na których Twoje zespoły już polegają.
Ale zakończenie wycieczki w tym miejscu byłoby nieuczciwe, ponieważ NLP w roku 2026 wciąż ma realne problemy.
Język jest niejednoznaczny — słowa niosą ze sobą wiele znaczeń, a modele wciąż potykają się o kontekst, który każdy człowiek by wychwycił. Modele dziedziczą błędy wynikające z danych treningowych, które mogą dyskretnie zaburzać działanie narzędzi rekrutacyjnych, decyzji kredytowych i moderacji treści. Jakość danych pozostaje mało atrakcyjnym wąskim gardłem: modele są tak dobre, jak to, z czego się uczą, a wysokiej jakości, dobrze opatrzone adnotacjami dane treningowe są trudno dostępne i drogie. Dialekty, slang i języki o niskich zasobach osiągają gorsze wyniki niż standardowy angielski. A halucynacja — pewność siebie, płynność, błędne wyniki — pozostaje przyczyną awarii, która zmusza do ostrożności we wdrożeniach korporacyjnych.
Żaden z tych powodów nie jest powodem do bierności. Są to powody do przemyślanego wdrażania: osadzaj modele w zweryfikowanych danych, oceniaj je pod kątem języka i użytkowników oraz informuj ludzi, gdy błędy są kosztowne. Co ciekawe, większość tych wyzwań ma tę samą przyczynę – modele danych są trenowane i oceniane – dlatego jakość danych stała się czynnikiem różnicującym konkurencję, a nie tylko elementem, który należy odhaczyć.
Co dalej: pięć trendów, na które warto zwrócić uwagę do 2026 roku
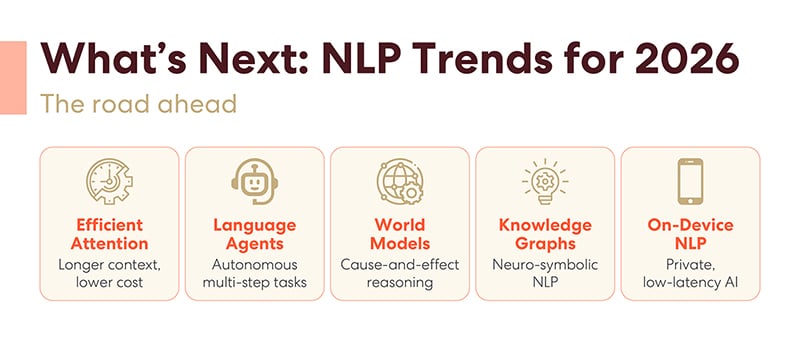
Patrząc w przyszłość, pięć zmian zdefiniuje kolejny etap w tej dziedzinie. Wydajne mechanizmy uwagi wydłużają okna kontekstowe, jednocześnie obniżając koszty, pozwalając modelom na jednoczesne rozumowanie w oparciu o całe bazy kodu lub pliki przypadków. Agenci językowi przechodzą z wersji demonstracyjnych do produkcyjnych, autonomicznie obsługując wieloetapowe przepływy pracy. Modele świata mają na celu umożliwienie sztucznej inteligencji autentycznego rozumowania przyczynowo-skutkowego zamiast dopasowywania wzorców. Grafy wiedzy łączą się z podejściami neuronowymi – neurosymbolicznym NLP – aby wyniki modeli były bardziej faktyczne i audytowalne. Natomiast NLP na urządzeniu stale zmniejsza wydajne modele, aż prywatna, nisko-opóźnieniowa sztuczna inteligencja zmieści się w kieszeni.
Wzorzec dla wszystkich pięciu: mniej brutalnej siły, większa precyzja. Tańsze, szybsze, bardziej ugruntowane, bliżej użytkownika.
Bottom Line
NLP w 2026 roku nie jest już technologią wschodzącą – to infrastruktura, równie nijaka i niezbędna jak bazy danych. Organizacje, które wyprzedzają konkurencję, nie zastanawiają się, czy korzystać z NLP; zastanawiają się, które zadania zautomatyzować w pierwszej kolejności, jak osadzić modele we własnych danych i jak upewnić się, że dane treningowe, na których się opierają, są warte nauki.