Czy zastanawiałeś się kiedyś, jak chatboty i wirtualni asystenci budzą się, gdy mówisz „Hej Siri” lub „Alexa”? Dzieje się tak ze względu na gromadzenie wypowiedzi tekstowych lub wyzwalanie słów wbudowanych w oprogramowanie, które aktywuje system, gdy tylko usłyszy zaprogramowane słowo budzące.
Jednak cały proces tworzenia dźwięków i danych wypowiedzi nie jest taki prosty. Jest to proces, który należy przeprowadzić odpowiednią techniką, aby uzyskać pożądane rezultaty. Dlatego ten blog pokaże drogę do tworzenia dobrych wypowiedzi/słów wyzwalających, które bezproblemowo współpracują z Twoją konwersacyjną sztuczną inteligencją.
Czym jest „wypowiedź” w sztucznej inteligencji?
W sztucznej inteligencji konwersacyjnej (chatboty, asystenci głosowi) wypowiedź to krótki fragment danych wprowadzanych przez użytkownika – dokładne słowa wypowiadane lub wpisywane przez osobę. Modele wykorzystują wypowiedzi do określenia intencji (celu) użytkownika i wszelkich elementów (szczegółów takich jak daty, nazwy produktów, ilości).
Proste przykłady
Bot e-commerce
Wypowiedź: „ Śledź moje zamówienie 123-456 ”.
- Intencja: TrackOrder
- Jednostka: order_id = 123-456
Bot telekomunikacyjny
Wypowiedź: „ Zaktualizuj mój plan danych ”.
- Intencja: Plan zmiany
- Jednostka: typ_planu = dane
Asystent głosowy bankowości
Wypowiedź (mówiona): „Jakie jest dziś moje saldo na rachunku bieżącym? ”
- Intencja: Sprawdź saldo
- Podmioty: account_type = konto bieżące, date = dzisiaj
Dlaczego Twoja sztuczna inteligencja konwersacyjna potrzebuje dobrych danych dotyczących wypowiedzi
Jeśli chcesz, aby Twój chatbot lub asystent głosowy był pomocny, a nie kruchy, zacznij od lepszych danych dotyczących wypowiedzi. Zobacz, jak to zrobiliśmy w tym studium przypadku gromadzenia wypowiedzi — 22 tys. godzin w 13 językach. Wypowiedzi to surowe frazy, które ludzie wypowiadają lub wpisują, aby coś zrobić („zarezerwuj mi pokój na jutro”, „zmień mój plan”, „jaki jest status?”). Wspierają one klasyfikację intencji, ekstrakcję encji i ostatecznie obsługę klienta. Jeśli wolisz skalować to z partnerem, usługi danych konwersacyjnej sztucznej inteligencji firmy Shaip zajmują się gromadzeniem, transkrypcją i adnotacją od początku do końca. Gdy wypowiedzi są zróżnicowane, reprezentatywne i dobrze oznaczone, Twoje modele uczą się właściwych granic między intencjami i z łatwością radzą sobie z chaotycznymi, rzeczywistymi danymi wejściowymi.
Tworzenie repozytorium wypowiedzi: prosty przepływ pracy
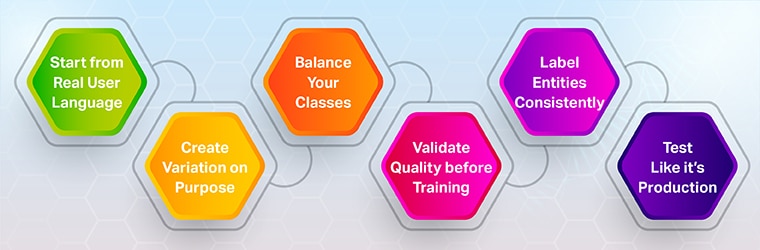
1. Zacznij od prawdziwego języka użytkownika
Przejrzyj logi czatów, zapytania wyszukiwania, transkrypcje IVR, notatki agentów i e-maile od klientów. Grupuj je według celu użytkownika, aby zasiać intencje. (Uchwycisz kolokwializmy i modele myślowe, o których nie pomyślałbyś w pokoju).
2. Twórz wariacje celowo
Dla każdego zamiaru autor podaje różne przykłady:
- Przeformułuj czasowniki i rzeczowniki („anulować”, „zatrzymać”, „kończyć”, „planować”, „subskrypcja”).
- Mieszaj długości zdań i ich strukturę (pytanie, dyrektywa, fragment).
- W razie potrzeby uwzględnij literówki, skróty, emotikony (do czatu) i zamianę kodów.
- Dodaj przypadki negatywne, które wyglądają podobnie, ale powinny nie mapę do tego zamiaru.
3. Zrównoważ swoje zajęcia
Bardzo asymetryczne szkolenie (np. 500 przykładów dla jednej intencji i 10 dla pozostałych) negatywnie wpływa na jakość prognoz. Utrzymuj względnie równomierne rozmiary intencji i zwiększaj je w miarę rozwoju ruchu.
4. Sprawdź jakość przed szkoleniem
Blokuj dane o niskim sygnale za pomocą walidatorów podczas tworzenia/zbierania:
- Wykrywanie języka: upewnij się, że przykłady są w języku docelowym.
- Detektor bełkotu: łapać bezsensowne ciągi znaków.
- Sprawdzanie duplikatów/prawie duplikatów: zachowaj dużą różnorodność.
- Wyrażenia regularne/pisownia i gramatyka: w razie potrzeby egzekwować zasady stylu.
Inteligentne walidatory (stosowane przez Appen) mogą zautomatyzować znaczną część tego procesu.
5. Etykietuj podmioty w sposób spójny
Zdefiniuj typy slotów (daty, produkty, adresy) i pokaż adnotatorom, jak oznaczać granice . Wzorce takie jak Pattern any w LUIS pozwalają na rozróżnianie długich, zmiennych zakresów (np. nazw dokumentów), które wprowadzają zamieszanie w modelach.
6. Testuj jak produkcję
Prześlij niewidziane, rzeczywiste wypowiedzi do punktu końcowego predykcji lub bota testowego, przejrzyj błędne klasyfikacje i wprowadź niejednoznaczne przykłady do szkolenia. Zrób z tego pętlę: zbieraj → trenuj → przeglądaj → rozwijaj.
Co tak naprawdę oznacza „chaotyczna rzeczywistość” (i jak sobie z nią radzić)
Prawdziwi użytkownicy rzadko mówią idealnymi zdaniami. Spodziewaj się:
- Paprochy: „zwrot opłaty za wysyłkę”
- Cele złożone: „anuluj zamówienie i zamów ponownie na niebiesko”
- Podmioty niejawne: „wysyłka do mojego biura” (musisz wiedzieć, do którego biura)
- Niejasność: „zmień mój plan” (który plan? kiedy wejdzie w życie?)
Praktyczne rozwiązania
- Zapewniać podpowiedzi wyjaśniające tylko wtedy, gdy jest to konieczne; unikaj proszenia o zbyt wiele.
- Zdobyć przeniesienie kontekstu (zaimki takie jak „tamto zamówienie”, „ostatni”).
- Zastosowanie intencje zapasowe z ukierunkowanym powrotem do zdrowia: „Mogę pomóc w anulowaniu lub zmianie planów — czego sobie życzysz?”
- Monitorowanie intencja zdrowotna (zamieszanie, kolizja) i dodaj dane tam, gdzie są słabe
Asystenci głosowi i słowa wybudzające: różne dane, podobne zasady
Kiedy (i jak) korzystać z gotowych danych, a kiedy z danych niestandardowych
- Z półki:rozpocznij działania w nowych lokalizacjach, a następnie zmierz, gdzie nadal występuje zamieszanie.
- warunki indywidualne : przechwyć język swojej domeny (warunki polityki, nazwy produktów) i „głos marki”.
- Mieszane: zacznij szeroko, a następnie dodaj dane o wysokiej precyzji dla intencji mających największe odchylenie lub wpływ na przychody.
Jeśli potrzebujesz szybkiego rozwiązania, Shaip oferuje zbieranie wypowiedzi i gotowe zestawy danych dotyczących mowy/czatu w wielu językach; zapoznaj się ze studium przypadku wdrożenia asystenta wielojęzycznego.
Lista kontrolna wdrożenia
- Zdefiniuj intencje i podmioty za pomocą przykładów i ujemny Etui
- Autor zróżnicowany, zrównoważony wypowiedzi dla każdej intencji (zacznij od małych kroków, zwiększaj je co tydzień)
- Dodaj walidatory (język, bełkot, duplikaty, wyrażenia regularne) przed szkoleniem
- Ustawiać pętle przeglądowe z prawdziwego ruchu; promuj niejednoznaczne elementy do szkolenia
- Śledzić intencja zdrowotna i kolizje; napraw za pomocą nowych wypowiedzi
- Dokonaj ponownej oceny według kanału/ustawień regionalnych, aby wcześnie wykryć dryf
Jak Shaip może pomóc
- Niestandardowe zbieranie i etykietowanie wypowiedzi (czat + rozmowa głosowa) z walidatorami w celu utrzymania wysokiej jakości.
- Gotowe do użycia zestawy danych w ponad 150 językach/wariantach, co umożliwia szybkie wdrożenie.
- Trwające programy przeglądowe które bezpiecznie przekształcają ruch uliczny w dane treningowe o wysokiej jakości (kontrole PII).
Zapoznaj się ze studium przypadku naszego zbioru wypowiedzi wielojęzycznych .