Optyczne rozpoznawanie znaków (OCR) obsługuje obecnie skanowanie paragonów, weryfikację tożsamości, automatyzację faktur, digitalizację archiwaliów historycznych oraz aplikacje do notatek obsługiwane rysikiem. Przewiduje się, że rynek OCR osiągnie wartość 32.90 mld dolarów do 2030 roku przy 14.8% CAGR (Grand View Research, 2024), przy czym inteligentne rozpoznawanie znaków – gałąź OCR związana z odczytywaniem pisma odręcznego – rozwija się najszybciej. Niezależnie od tego, czy tworzysz parsowanie dokumentów, wykrywanie tekstu na scenie, czy transkrypcję pisma odręcznego, zestaw danych OCR, na którym trenujesz, wyznacza pułap dokładności. Ten przewodnik obejmuje 22 darmowe, otwarte zestawy danych OCR – w tym najlepsze zestawy danych pisma odręcznego – uporządkowane według przypadków użycia i odświeżone o najmocniejsze wersje do 2024 roku.
Na wynos
- OCR (optyczne rozpoznawanie znaków): technologia umożliwiająca konwersję obrazów, tekstów drukowanych, scen lub tekstu pisanego odręcznie na dane możliwe do odczytania przez maszynę.
- Zestawy danych OCR dzielą się na pięć grup: dokument/formularz, tekst sceny, cyfry/znaki, pismo odręczne i wielojęzyczne.
- Zestawy danych OCR dokumentów przechwytywanie stron strukturalnych, takich jak formularze i paragony; zestawy danych tekstu scenicznego przechwytywanie tekstu „w terenie”.
- IAM, MNIST, ICDAR i SROIE pozostają najczęściej cytowanymi testami OCR w badaniach.
- Warunki licencji są bardzo zróżnicowane — przed rozpoczęciem szkolenia komercyjnego należy sprawdzić każdy zestaw danych OCR.
Co to jest OCR (optyczne rozpoznawanie znaków)?
OCR to technologia, która konwertuje różne typy dokumentów, takie jak zeskanowane dokumenty papierowe, pliki PDF lub obrazy tekstu, na edytowalne i przeszukiwalne dane. Działa poprzez:
- Analiza struktury tekstu na obrazie
- Podział tekstu na wiersze i znaki
- Konwersja tych znaków wizualnych na tekst czytelny dla maszyny
Typowe zastosowania obejmują:
- Konwersja zeskanowanych dokumentów do edytowalnych plików tekstowych
- Digitalizacja książek drukowanych
- Wyodrębnianie tekstu ze zdjęć
- Konwersja recept pisanych ręcznie na tekst cyfrowy
- Rozpoznawanie tablic rejestracyjnych
Jak wybrać właściwy zestaw danych OCR?
Wybór zestawu danych OCR zależy od czterech czynników: rodzaju tekstu, środowiska przechwytywania, szczegółowości adnotacji oraz licencji. OCR dokumentów drukowanych wymaga innych danych treningowych niż tekst pisany kursywą lub zakrzywiony. Zestawy danych dokumentów są odpowiednie dla faktur, formularzy i paragonów; zestawy danych tekstu scen są odpowiednie dla oznakowania i czytania produktów; zestawy danych pisma odręcznego są odpowiednie dla notatek, rękopisów i wprowadzania danych rysikiem. Adnotacje na poziomie słów i wierszy obsługują pełne procesy OCR, natomiast zestawy na poziomie znaków spełniają podstawowe kryteria klasyfikacji. Zawsze należy sprawdzić warunki licencji, ponieważ niektóre zestawy danych OCR są przeznaczone wyłącznie do celów badawczych lub wymagają rejestracji.
Jakie są najlepsze zestawy danych OCR dokumentów i formularzy?
Zestawy danych OCR dokumentów uczą modele analizowania stron strukturalnych, takich jak faktury, formularze, paragony i identyfikatory. Umożliwiają one automatyzację dokumentów biznesowych i ekstrakcję wartości kluczowych.
- FUNDUSZE — 199 zeskanowanych formularzy z adnotacjami i szumem, wyglądających jak prawdziwe. Standardowy punkt odniesienia w zakresie rozumienia formularzy i ekstrakcji wartości kluczowych.
- SROIE — Zbiór danych ICDAR 2019 obejmujący około 1,000 zeskanowanych paragonów, obsługujący wykrywanie tekstu, rozpoznawanie i ekstrakcję informacji w jednym zestawie.
- SZNUR — Skonsolidowany zestaw danych o paragonach przeznaczony do analizy po OCR, z rozbudowanymi etykietami na poziomie pól do automatyzacji faktur i paragonów.
- XFUNDU — Wielojęzyczne rozszerzenie FUNSD obejmujące siedem języków (niemiecki, hiszpański, francuski, włoski, japoński, portugalski, chiński) po 199 stron każdy. Idealne do wielojęzycznej sztucznej inteligencji w dokumentach.
- DDI-100 — Około 100 000 zniekształconych obrazów dokumentów do wykrywania i rozpoznawania w warunkach rzeczywistego pogorszenia jakości, np. przekoszenia, rozmycia i szumu.
Jakie są najlepsze zestawy danych OCR tekstu scen?
Zestawy danych OCR do rozpoznawania tekstu i sceny uczą modele odczytywania tekstu z obrazów naturalnych, takich jak znaki drogowe, produkty i sceny uliczne. Są one niezbędne do rozpoznawania tekstu w warunkach naturalnych, gdzie tła są zaśmiecone.
- Solidny odczyt ICDAR — Rodzina stanowiąca punkt odniesienia dla większości badań tekstu sceny, w tym wyzwań dotyczących tekstu sceny skoncentrowanej i przypadkowej z ramkami ograniczającymi na poziomie słów i transkrypcjami.
- Tekst COCO — Adnotacje tekstowe scen na dużą skalę nakładane na obrazy MS-COCO. Skuteczne w wykrywaniu tekstu na dużą skalę w naturalnych scenach.
- Całkowity tekst — Specjalizuje się w tekście zakrzywionym i o dowolnej orientacji, co jest znaną słabością starszych modeli OCR.
- SVT (tekst widoku ulicy) — Obrazy słowne pochodzą z Google Street View, często o niskiej rozdzielczości i dużej zmienności. Dostępne za pośrednictwem luster Papers with Code.
- HierText — Hierarchiczna adnotacja od akapitu do wiersza i słowa, obejmująca zarówno tekst pisany odręcznie, jak i drukowany. Przydatna do rozpoznawania tekstu (OCR) z uwzględnieniem układu tekstu.
Jakie są najlepsze zestawy danych OCR cyfr i znaków?
Zestawy danych OCR cyfr i znaków trenują modele do rozpoznawania pojedynczych symboli w kontrolowanych warunkach. Są to standardowe punkty wyjścia dla baz klasyfikacji.
- MNIST — 70 000 obrazów cyfr pisanych ręcznie w skali szarości. Najszybsza baza do walidacji klasyfikatora cyfr.
- EMNISTA — Rozszerza bazę danych MNIST o 814 255 ręcznie pisanych liter i cyfr pochodzących ze Specjalnej bazy danych NIST 19.
- SVHN (Numery domów z widokiem na ulicę) — Ponad 600 000 rzeczywistych obrazów cyfr z numerów domów. Praktyczny krok naprzód w porównaniu z MNIST w warunkach dużego szumu.
- 74 tys. znaków — 74 107 obrazów obejmujących znaki języka angielskiego i kannada pochodzące z obrazów naturalnych i czcionek komputerowych.
- Specjalna baza danych NIST 19 — Ponad 810 000 ręcznie drukowanych obrazów znaków od 3,600 autorów. Źródło wielu testów OCR dla języka angielskiego.
Jakie zbiory danych pisma odręcznego są najlepsze do rozpoznawania znaków (OCR)?
Zbiory danych dotyczących pisma odręcznego trenują modele OCR do odczytywania pisma odręcznego, drukowanego i historycznego. Najsilniejsze otwarte zbiory danych dotyczące pisma odręcznego pozostają najczęściej cytowanymi punktami odniesienia w rozpoznawaniu pisma odręcznego (HTR).
- Baza danych pisma ręcznego IAM — Złoty standard w zakresie pisma odręcznego w języku angielskim, z 13 353 liniami tekstu od 657 autorów. Nadal najczęściej cytowany zbiór danych dotyczących pisma odręcznego w badaniach OCR z lat 2024–2025.
- IAM-OnDB — Internetowa wersja IAM, rejestrująca dane o trajektorii ruchu pióra. Kanoniczny zbiór danych o piśmie odręcznym do rozpoznawania rysikiem i tabletem.
- Dokumenty Benthama — Transkrypcja historycznych rękopisów angielskich autorstwa filozofa Jeremy'ego Benthama. Wiodący punkt odniesienia w rozpoznawaniu pisma odręcznego, dostępny za pośrednictwem Transkribus.
- GNHK (Kolekcja pisma ręcznego GoodNotes) — Zbiór danych z 2021 roku, zawierający nieograniczone, rzeczywiste, odręczne notatki w języku angielskim. Bliżej chaotycznych danych produkcyjnych niż laboratoryjnie czystych danych IAM.
Jakie są najlepsze wielojęzyczne i niełacińskie zestawy danych OCR?
Wielojęzyczne zestawy danych OCR trenują modele w oparciu o pisma inne niż angielski, w tym chiński, arabski i notację matematyczną. Są one niezbędne do globalnego rozpoznawania dokumentów i pisma odręcznego.
- CASIA-HWDB — Standardowy chiński punkt odniesienia OCR, obejmujący 1.17 miliona próbek znaków pisanych odręcznie przez 1,020 pisarzy.
- KHATT — 1,000 arabskich odręcznych formularzy od 1,000 różnych pisarzy, zeskanowanych w wielu rozdzielczościach. Najbardziej kompleksowy, otwarty zbiór danych OCR dla języka arabskiego.
- CROHME — Konkurs rozpoznawania odręcznych wyrażeń matematycznych online: ponad 10 000 wyrażeń obejmujących ponad 101 symboli matematycznych, zarówno w wersji online, jak i offline. Niezbędny do rozpoznawania równań pisanych odręcznie.
Jakie są najczęstsze pułapki przy korzystaniu z bezpłatnych zestawów danych OCR?
Trzy pułapki wpadają w ręce większości zespołów.
Niedopasowanie domeny: szkolenie na czystym IAM lub COCO-Text i wdrażanie na pogniecionych fakturach gwarantuje niską dokładność.
Brak licencji: wiele zestawów danych OCR dotyczących tekstu scen i danych historycznych jest przeznaczonych wyłącznie do celów badawczych lub wymaga rejestracji przed wykorzystaniem komercyjnym.
Luki w adnotacjach: w wielu zestawach danych OCR brakuje metadanych układu, pól ograniczających na poziomie linii lub etykiet pól, których wymagają systemy produkcyjne.
Wyobraź sobie firmę logistyczną średniej wielkości automatyzującą odczyt etykiet wysyłkowych. Szkolenie z publicznego odczytu tekstu pozwala im osiągnąć 80% w testach porównawczych, ale rzeczywiste etykiety z odblaskami i zagięciami obniżają ten wynik do 58%. Zniwelowanie tej różnicy wymagało ukierunkowanej adnotacji danych 6,000 obrazów etykiet w domenie przed wprowadzeniem produktu na rynek.
Korzyści i wyzwania związane ze zbiorami danych typu Open Source
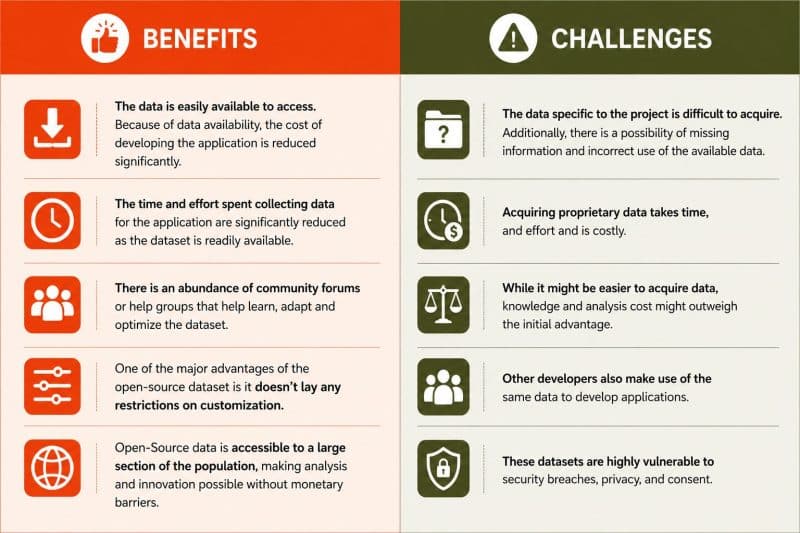
Firmy muszą zmierzyć się z korzyściami i wyzwaniami, aby zrozumieć, czy muszą zdecydować się na bezpłatne korzystanie z danych w swoich aplikacjach ML.
Korzyści
- Dane są łatwo dostępne. Ze względu na dostępność danych koszt tworzenia aplikacji jest znacznie obniżony.
- Czas i wysiłek poświęcony na zbieranie danych dla aplikacji są znacznie skrócone, ponieważ zestaw danych jest łatwo dostępny.
- Istnieje wiele forów społecznościowych lub grup pomocy, które pomagają uczyć się, dostosowywać i optymalizować zbiór danych.
- Jedną z głównych zalet zestawu danych o otwartym kodzie źródłowym jest to, że nie nakłada żadnych ograniczeń na dostosowywanie.
- Dane Open-Source są dostępne dla dużej części populacji, dzięki czemu analizy i innowacje są możliwe bez barier monetarnych.
Wyzwania
- Dane specyficzne dla projektu są trudne do zdobycia. Dodatkowo istnieje możliwość pominięcia informacji i nieprawidłowego wykorzystania dostępnych danych.
- Pozyskiwanie zastrzeżonych danych wymaga czasu, wysiłku i jest kosztowne
- Chociaż pozyskiwanie danych może być łatwiejsze, koszty wiedzy i analizy mogą przewyższać początkową przewagę.
- Inni programiści również wykorzystują te same dane do tworzenia aplikacji.
- Te zbiory danych są bardzo podatne na naruszenia bezpieczeństwa, prywatności i zgody.
W jaki sposób Shaip wspiera projekty OCR i rozpoznawania pisma ręcznego?
Usługi danych treningowych OCR firmy Shaip łączą w sobie otwarte gromadzenie zbiorów danych z niestandardowym zbieraniem danych w ponad 60 językach, obejmujących dokumenty drukowane, pismo odręczne, paragony i dokumenty tożsamości. Przepływy pracy związane z adnotacjami firmy Shaip dodają warstwy, których brakuje w publicznych zbiorach danych OCR: ramki ograniczające na poziomie wiersza, etykiety na poziomie pola, kontrolę jakości transkrypcji i metadane autora.
Wniosek
22 powyższe zestawy danych OCR zapewniają kompletne, otwarte oprogramowanie do rozpoznawania dokumentów, tekstu scen, cyfr, pisma odręcznego i wielojęzyczności na rok 2026. Zacznij od zestawu danych OCR, który pasuje do Twojego typu tekstu i środowiska przechwytywania, przeprowadź walidację na podstawie pobranej próbki rzeczywistych danych i zaplanuj niestandardowe adnotacje, aby zniwelować lukę domenową. Ta kombinacja jest dostarczana szybciej niż tworzenie od podstaw.