Dane to supermocarstwo, które zmienia krajobraz cyfrowy w dzisiejszym świecie. Od e-maili po posty w mediach społecznościowych, dane są wszędzie. To prawda, że firmy nigdy nie miały dostępu do tak dużej ilości danych, ale czy sam dostęp do danych jest wystarczający? Bogate źródło informacji staje się bezużyteczne lub przestarzałe, gdy nie jest przetwarzane.
Tekst niestrukturyzowany może być bogatym źródłem informacji, ale nie będzie przydatny dla firm, jeśli dane nie zostaną uporządkowane, skategoryzowane i przeanalizowane. Dane niestrukturyzowane, takie jak tekst, audio, wideo i media społecznościowe, stanowią 80-90% wszystkich danych. Co więcej, zaledwie 18% organizacji korzysta z niestrukturyzowanych danych swojej organizacji.
Ręczne przeszukiwanie terabajtów danych przechowywanych na serwerach jest czasochłonne i, szczerze mówiąc, niemożliwe. Jednak dzięki postępowi w uczeniu maszynowym, przetwarzaniu języka naturalnego i automatyzacji, możliwe jest szybkie i efektywne strukturyzacja oraz analiza danych tekstowych. Pierwszym krokiem w analizie danych jest klasyfikacja tekstu.
Co to jest klasyfikacja tekstu?
Klasyfikacja lub kategoryzacja tekstu to proces grupowania tekstu w predefiniowane kategorie lub klasy. Dzięki temu podejściu uczenia maszynowego, każdy tekst – dokumenty, pliki internetowe, badania, dokumenty prawne, raporty medyczne i inne – można klasyfikować, organizować i strukturyzować.
Klasyfikacja tekstu to podstawowy etap przetwarzania języka naturalnego, który ma wiele zastosowań w wykrywaniu spamu. Obejmuje analizę sentymentu, wykrywanie intencji, etykietowanie danych i wiele innych.
Możliwe przypadki użycia klasyfikacji tekstu

Kiedy model ML jest szkolony na sztucznej inteligencji, która automatycznie kategoryzuje elementy według wcześniej ustalonych kategorii, możesz szybko zamienić zwykłych przeglądarek w klientów.
Proces klasyfikacji tekstu
Proces klasyfikacji tekstu rozpoczyna się od wstępnego przetwarzania, wyboru funkcji, ekstrakcji i klasyfikacji danych.

Przetwarzanie wstępne
Tokenizacja: Tekst jest dzielony na mniejsze i prostsze formy tekstowe w celu łatwej klasyfikacji.
Normalizacja: Cały tekst w dokumencie musi być na tym samym poziomie zrozumiałości. Niektóre formy normalizacji obejmują:
- Zachowanie standardów gramatycznych lub strukturalnych w całym tekście, np. usunięcie spacji lub znaków interpunkcyjnych. Lub zachowanie małych liter w całym tekście.
- Usuwanie przedrostków i sufiksów ze słów i przywracanie ich do ich rdzenia.
- Usuwanie słów stop, takich jak „i” „jest” „the” i innych, które nie dodają wartości do tekstu.
Wybór funkcji
Wybór cech jest podstawowym krokiem w klasyfikacji tekstu. Proces ten ma na celu reprezentowanie tekstów z najbardziej istotnymi cechami. Wybór cech pomaga usunąć nieistotne dane i zwiększyć dokładność.
Wybór cech ogranicza zmienną wejściową do modelu, wykorzystując tylko najbardziej odpowiednie dane i eliminując szum. W zależności od rodzaju szukanego rozwiązania modele sztucznej inteligencji można zaprojektować tak, aby wybierały tylko odpowiednie funkcje z tekstu.
Ekstrakcja cech
Ekstrakcja cech to opcjonalny krok, który niektóre firmy podejmują w celu wyodrębnienia dodatkowych kluczowych cech z danych. Ekstrakcja cech wykorzystuje kilka technik, takich jak mapowanie, filtrowanie i grupowanie. Podstawową korzyścią płynącą z ekstrakcji cech jest to, że pomaga usunąć nadmiarowe dane i poprawić szybkość tworzenia modelu ML.
Tagowanie danych do z góry określonych kategorii
Tagowanie tekstu do predefiniowanych kategorii to ostatni krok w klasyfikacji tekstu. Można to zrobić na trzy różne sposoby,
- Ręczne tagowanie
- Dopasowywanie oparte na regułach
- Algorytmy uczenia się — algorytmy uczenia się można dalej podzielić na dwie kategorie, takie jak tagowanie nadzorowane i tagowanie nienadzorowane.
- Uczenie nadzorowane: Model ML może automatycznie dopasowywać tagi do istniejących skategoryzowanych danych w tagowaniu nadzorowanym. Gdy skategoryzowane dane są już dostępne, algorytmy ML mogą mapować funkcję między tagami a tekstem.
- Uczenie bez nadzoru: Dzieje się tak, gdy brakuje wcześniej istniejących oznakowanych danych. Modele ML wykorzystują klastrowanie i algorytmy oparte na regułach do grupowania podobnych tekstów, na przykład na podstawie historii zakupów produktów, recenzji, danych osobowych i zgłoszeń. Te szerokie grupy można dalej analizować w celu uzyskania cennych spostrzeżeń dotyczących konkretnego klienta, które można wykorzystać do zaprojektowania dostosowanego podejścia do klienta.
Klasyfikacja tekstu: zastosowania i przypadki użycia
Autonomizacja grupowania lub klasyfikowania dużych fragmentów tekstu lub danych przynosi kilka korzyści, dając początek odrębnym przypadkom użycia. Przyjrzyjmy się niektórym z najczęstszych:
- Wykrywanie spamu: Używany przez dostawców usług e-mail, dostawców usług telekomunikacyjnych i aplikacje defensywne do identyfikowania, filtrowania i blokowania treści spamowych
- Analiza nastrojów: Analizuj recenzje i treści tworzone przez użytkowników pod kątem ukrytych nastrojów i kontekstu oraz wspomagaj ORM (zarządzanie reputacją online)
- Wykrywanie intencji: Lepiej zrozumieć intencję stojącą za monitami lub zapytaniami dostarczanymi przez użytkowników, aby generować dokładne i trafne wyniki
- Etykietowanie tematu: Klasyfikuj artykuły informacyjne lub posty tworzone przez użytkowników według wstępnie zdefiniowanych tematów lub zagadnień
- Wykrywanie języka: Wykryj język, w którym wyświetlany lub prezentowany jest tekst
- Wykrywanie pilności: Identyfikuj i ustalaj priorytety komunikacji alarmowej
- Monitorowanie mediów społecznościowych:Zautomatyzuj proces śledzenia wzmianek o markach w mediach społecznościowych
- Kategoryzacja zgłoszeń pomocy technicznej: Kompiluj, organizuj i ustalaj priorytety zgłoszeń pomocy technicznej i żądań serwisowych od klientów
- Organizacja dokumentów: Sortowanie, strukturyzacja i standaryzacja dokumentów prawnych i medycznych
- Filtrowanie e-maili: Filtruj wiadomości e-mail na podstawie określonych warunków
- Wykrywanie oszustw: Wykrywaj i oznaczaj podejrzane działania w ramach transakcji
- Badania rynku: Poznaj warunki rynkowe na podstawie analiz i pomóż w lepszym pozycjonowaniu produktów i reklam cyfrowych i nie tylko
Jakie wskaźniki są stosowane do oceny klasyfikacji tekstu?
Jak wspomnieliśmy, optymalizacja modelu jest nieunikniona, aby zapewnić stałą wysoką wydajność modelu. Ponieważ modele mogą napotykać usterki techniczne i przypadki, takie jak halucynacje, konieczne jest, aby przeszły przez rygorystyczne techniki walidacji, zanim zostaną uruchomione lub zaprezentowane publiczności testowej.
Aby to zrobić, możesz wykorzystać skuteczną technikę oceny zwaną walidacją krzyżową.
Weryfikacja krzyżowa
Polega to na rozbiciu danych treningowych na mniejsze fragmenty. Każdy mały fragment danych treningowych jest następnie używany jako próbka do trenowania i walidacji modelu. Gdy rozpoczynasz proces, Twój model trenuje na początkowym małym fragmencie dostarczonych danych treningowych i jest testowany w porównaniu z innymi mniejszymi fragmentami. Końcowe wyniki wydajności modelu są porównywane z wynikami generowanymi przez Twój model trenowany na danych z adnotacjami użytkownika.
Kluczowe wskaźniki stosowane w walidacji krzyżowej
| Dokładność | Odwołanie | Precyzja | Wynik F1 |
|---|---|---|---|
| oznacza liczbę prawidłowych przewidywań lub wyników wygenerowanych w odniesieniu do wszystkich przewidywań | co oznacza spójność w przewidywaniu właściwych wyników w porównaniu do całkowitej liczby właściwych przewidywań | co oznacza zdolność Twojego modelu do przewidywania mniejszej liczby wyników fałszywie dodatnich | który określa ogólną wydajność modelu poprzez obliczenie średniej harmonicznej wskaźnika wywołania i precyzji |
Jak przeprowadzić klasyfikację tekstu?
Choć brzmi to zniechęcająco, proces klasyfikacji tekstów jest systematyczny i zazwyczaj obejmuje następujące kroki:
- Utwórz zbiór danych szkoleniowych: Pierwszym krokiem jest skompilowanie zróżnicowanego zestawu danych treningowych w celu zapoznania i nauczenia modeli autonomicznego wykrywania słów, fraz, wzorców i innych połączeń. Na tym fundamencie można budować dogłębne modele treningowe.
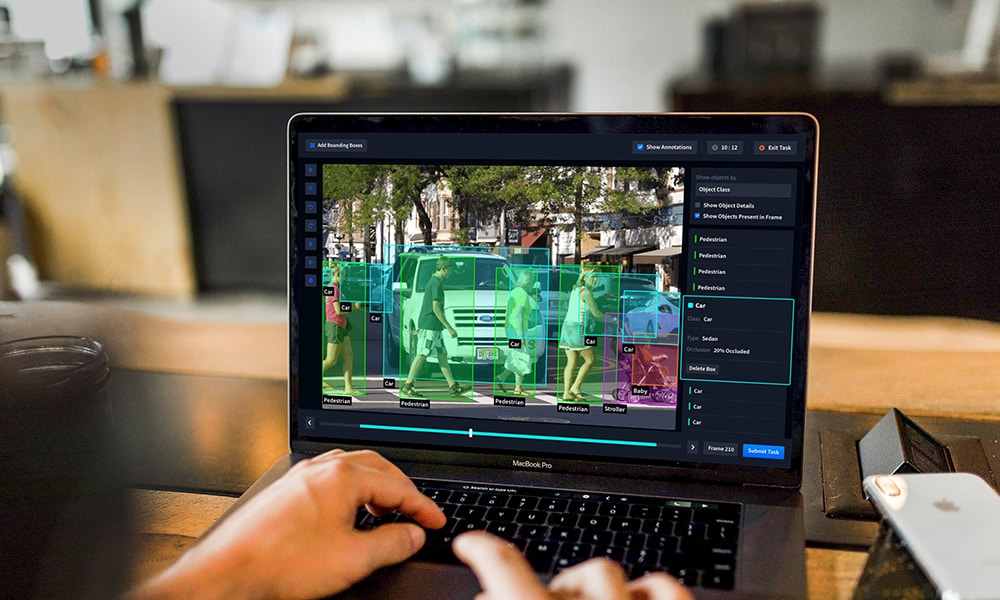
- Przygotuj zbiór danych: Skompilowane dane są już gotowe. Nadal są jednak surowe i niestrukturyzowane. Ten krok obejmuje czyszczenie i standaryzację danych, aby były gotowe do użycia przez maszynę. W tej fazie stosuje się takie techniki, jak adnotacja i tokenizacja.
- Szkolenie modelu klasyfikacji tekstu: Gdy dane są już ustrukturyzowane, rozpoczyna się faza szkolenia. Modele uczą się z adnotowanych danych i zaczynają tworzyć połączenia z zestawami danych. W miarę jak do modeli wprowadza się więcej danych szkoleniowych, uczą się one lepiej i autonomicznie generują zoptymalizowane wyniki, które są zgodne z ich podstawowym zamiarem.
- Oceniaj i optymalizuj:Ostatnim krokiem jest ocena, w której porównujesz wyniki wygenerowane przez Twoje modele z wcześniej zidentyfikowanymi metrykami i punktami odniesienia. Na podstawie wyników i wniosków możesz podjąć decyzję, czy konieczne jest dalsze szkolenie, czy też model jest gotowy do następnego etapu wdrożenia.
Stworzenie skutecznego i wnikliwego narzędzia do klasyfikacji tekstu nie jest łatwe. Jednak z Shaip jako partnerem w zakresie danych możesz stworzyć skuteczne, skalowalne i ekonomiczne narzędzie do klasyfikacji tekstu oparte na sztucznej inteligencji. Dysponujemy mnóstwem precyzyjnie opatrzonych adnotacjami i gotowych do użycia zestawów danych, które można dostosować do unikalnych wymagań Twojego modelu. Zmieniamy Twój tekst w przewagę konkurencyjną – skontaktuj się z nami już dziś.