Generatywna sztuczna inteligencja zmieniła nasz świat dzięki możliwości tworzenia treści naśladujących ludzką inteligencję. Pomyśl o technologii produkującej artykuły, dzieła sztuki lub muzykę według własnego uznania i bez wysiłku; to po prostu niesamowite.
Ale tu jest zwrot akcji. Czy korzystanie z tej technologii jest zawsze legalne? Niektórzy mogą powiedzieć, że tak, podczas gdy inni budzą wątpliwości etyczne.
Wykorzystanie danych jest kluczowe w tej debacie. Generatywna sztuczna inteligencja potrzebuje ogromnych ilości danych, które pomagają modelowi uczyć się i generować nowe treści. Ale skąd te dane pochodzą? Dlatego tak ważne jest, aby pozyskiwać je w sposób etyczny.
- Artyści cyfrowi na platformach takich jak ArtStation protestują. Ich grafika jest wykorzystywana jako dane szkoleniowe dla modeli sztucznej inteligencji i pojawiają się nazwy takie jak Midjourney i Stable Diffusion.
- Microsoft, GitHub i OpenAI rzekomo zeskrobał prace artystów i kod programistów w celu szkolenia ich modeli sztucznej inteligencji.
- Getty Images, brytyjski gigant, rzucił wyzwanie sztucznej inteligencji związanej ze stabilnością w związku z wykorzystaniem ich obrazów stockowych.
- Najnowsze doniesienia budzą więcej kontrowersji. Twórcy Gry o Tron znajdują się wśród 17 stron, które to zrobiły złożył pozew. Twierdzą, że OpenAI dopuściło się systematycznej kradzieży na wielką skalę.
Przyjrzyjmy się zatem bliżej tej kontrowersji i omówmy, w jaki sposób modele sztucznej inteligencji pozyskują dane na całym świecie, korzystając z prawa, nawet jeśli słyszymy, że zgoda jest kluczowa.
Obejście prawa
To rodzi duże pytanie. Większość modeli AI danych internetowych, z których korzysta, nie ma uprawnień twórcy. Ci twórcy nie otrzymują uznania ani wynagrodzenia. Czy to jest sprawiedliwe?
W Stanach Zjednoczonych obowiązuje ustawa o dozwolonym użytku (Fair Use Law ). Pozwala ona użytkownikom na nowe sposoby wykorzystywania utworów chronionych prawem autorskim, na przykład do celów krytycznych lub parodii. Wiele osób zajmujących się sztuczną inteligencją korzysta z tej ustawy, ale zamiast uzyskiwać licencje na dane, wykorzystują one treści jako dane treningowe. Ale czy zasada dozwolonego użytku ma zastosowanie do danych treningowych sztucznej inteligencji?
 Spójrzmy na Europę. W UE obowiązuje rygorystyczne prawo dotyczące prywatności zwane ogólnym rozporządzeniem o ochronie danych (RODO). Chodzi o zgodę użytkownika na wykorzystanie danych. Firmy nie mogą po prostu pobierać danych, ponieważ wymagają zgody użytkownika. Czy zatem model sztucznej inteligencji narusza to prawo, wykorzystując Twoje zdjęcia lub dzieła sztuki? Jeśli tak, co zrobi UE?
Te pytania wiszą na włosku i będą kształtować sposób, w jaki będziemy wykorzystywać sztuczną inteligencję w przyszłości.
Zaakceptować lub odpuścić
Czy jest za późno na działanie? Debaty prawne w USA, Wielkiej Brytanii i UE toczą się w 2023 roku. Jednak duże modele językowe i transformatory obrazu podkreślają siłę uczenia na ogromnych zbiorach danych . Niektórzy twierdzą, że dżin wyszedł z butelki. Sztuczna inteligencja prawdopodobnie będzie się nadal rozwijać, a modele będą nazywane „ modelami podstawowymi ”.
Warto rozważyć : niektórzy w obszarze sztucznej inteligencji uważają, że łagodniejsze przepisy dotyczące praw autorskich napędzają postęp. W artykule zatytułowanym „ Fair Learning ” sugeruje się, że uczciwe korzystanie z danych online jest niezbędne. Bez niego rozwój sztucznej inteligencji może stanąć w miejscu.
Pieniądze napływają do generatywnej sztucznej inteligencji, a inwestorzy kapitału wysokiego ryzyka dostrzegają jej ogromny potencjał. Obietnica zmiany sposobu wykorzystania technologii budzi zainteresowanie, ponieważ przyszłość sztucznej inteligencji rysuje się w jasnych barwach.
Zmieniaj się dzięki Shaipowi
Sztuczna inteligencja generatywna robi furorę, a jej przyszłość jest niepewna z powodu debat prawnych w takich krajach jak USA i UE. Jest jednak jasne, że technologia ta na stałe zagości w naszym życiu. W najbliższej przyszłości mogą ją napędzać zbiory danych tworzone przez społeczności lub oparte na otwartym kodzie źródłowym. UE stawia kolejne wyzwania w związku z RODO i nadchodzącą ustawą o sztucznej inteligencji.
Jak Twoja firma może skorzystać z tej technologii, zachowując etykę i globalność? Spójrz na Shaip , bo jesteśmy tu z rozwiązaniami.
Od początku naszej działalności stawiamy na dostosowane do potrzeb, wysokiej jakości zbiory danych na potrzeby projektów AI. Oferujemy coś więcej niż tylko czyste dane, ponieważ eliminujemy szumy często spotykane w zestawach open source. Nasze zbiory danych zawierają szczegółowe dane demograficzne, co pozwala upewnić się, że nie ma w nich stronniczości.
Kierujemy się podstawowym przekonaniem: sztuczna inteligencja powinna być sprawiedliwa i uczciwa.
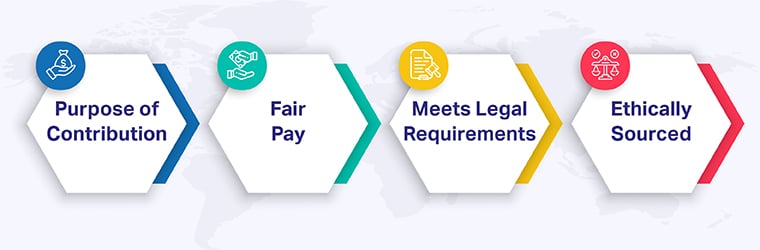
Naszym priorytetem są ludzie stojący za danymi . Dbamy o to, aby każdy użytkownik wyraził świadomą zgodę. Uważamy, że dane są sercem sztucznej inteligencji, a ludzie sercem danych. Powinni oni znać cel swojego wkładu i otrzymywać godziwe wynagrodzenie.
Mamy dwojakie podejście. Spełnia wszystkie wymogi prawne, szanując i ceniąc dostawców danych. Wiele osób pozywających firmy zajmujące się sztuczną inteligencją pragnie uznania i uczciwości, a my dbamy o to, aby otrzymali sprawiedliwy udział.
Gdy świat zmaga się z przyszłością sztucznej inteligencji, Shaip oferuje drogę naprzód. Kiedy będziesz gotowy wykorzystać sztuczną inteligencję w swojej firmie, wybierz dane etyczne i zgodne z wymogami globalnymi. To jest dokładnie to, co oferuje Shaip.
Skontaktuj się z Shaipem . Wprowadźmy Twoją firmę w erę sztucznej inteligencji we właściwy sposób.