Rozpoznawanie głosu to technologia, która identyfikuje i uwierzytelnia osobę na podstawie unikalnych cech jej głosu, podczas gdy jej bliski odpowiednik, rozpoznawanie mowy, konwertuje wypowiadane słowa na tekst lub polecenia. Razem napędzają one wszystko, od inteligentnych głośników i sterowania w samochodach, po bezpieczeństwo bankowe i dokumentację kliniczną. Globalny rynek rozpoznawania głosu i mowy był wyceniany na 20.25 miliarda dolarów w 2023 roku i według prognoz do 2030 roku osiągnie 53.67 miliarda dolarów, rosnąc w tempie 14.6% CAGR (Grand View Research, 2024) — a rozpoznawanie głosu jest najszybciej rozwijającym się segmentem jego funkcji (Grand View Research, 2024).
W tym przewodniku wyjaśniono, jak działa rozpoznawanie głosu, gdzie jest wykorzystywane, jakie są jego zalety i ograniczenia oraz jakie zmiany zajdą w roku 2026 i jakie będą miały wpływ na tę dziedzinę.
Na wynos
- Rozpoznawanie głosu identyfikuje osobę mówiącą; rozpoznawanie mowy rozumie to, co zostało powiedziane.
- Systemy analizują wysokość tonu, częstotliwość, akcent i kadencję, aby stworzyć unikalny odcisk głosu.
- Najpopularniejsze zastosowania: bezpieczeństwo i biometria, urządzenia aktywowane głosem, obsługa klienta, służba zdrowia i motoryzacja.
- Dokładność w dużej mierze zależy od zróżnicowanych, dobrze oznaczonych danych szkoleniowych dla różnych akcentów i języków. Pozyskiwanie ich na dużą skalę to podstawa. zbiory danych mowy oszczędź zespołom miesięcy zbierania danych.
- Trendy na rok 2026 obejmują modele sztucznej inteligencji przetwarzające mowę na mowę, przetwarzanie na urządzeniach i obronę przed deepfake'ami głosowymi.
Wielkość rynku: W niecałe 20 lat technologia rozpoznawania głosu rozwinęła się fenomenalnie. Ale co przyniesie przyszłość? W 2020 roku globalny rynek technologii rozpoznawania głosu wynosił około 10.7 miliarda dolarów. Przewiduje się, że do 2026 roku wzrośnie on gwałtownie do 27.16 miliarda dolarów, a w latach 2021-2026 będzie rósł ze średnioroczną stopą wzrostu (CAGR) na poziomie 16.8%.
Czym jest technologia rozpoznawania głosu?
Dziedzina ta ma swoje korzenie w systemach z lat 1950. XX wieku, które potrafiły rozpoznawać zaledwie kilka cyfr. Modele statystyczne, a później uczenie głębokie, przekształciły te wczesne eksperymenty w nieustannie słuchających asystentów i bezpieczne systemy uwierzytelniania głosowego, z których korzystają dziś miliardy ludzi.
Rozpoznawanie głosu – zalety i wady
Jak działa rozpoznawanie głosu?
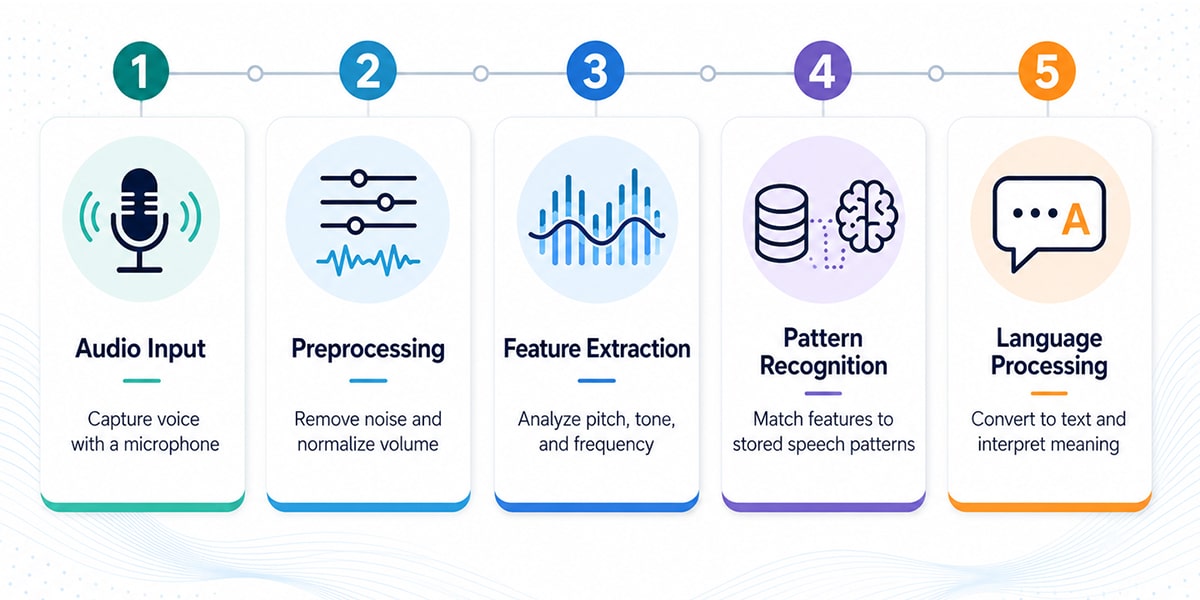
Wejście audio : Proces rozpoczyna się od przechwycenia sygnału audio za pomocą mikrofonu.
Wstępne przetwarzanie : Sygnał audio jest oczyszczany poprzez usuwanie szumów i normalizację głośności.
Ekstrakcja cech : System analizuje dźwięk w celu wyodrębnienia kluczowych cech, takich jak wysokość dźwięku, ton i częstotliwość.
Rozpoznawanie wzorców : Wyodrębnione cechy są porównywane ze znanymi wzorcami mowy zapisanymi w bazie danych.
Przetwarzanie języka : Rozpoznane wzorce są przekształcane na tekst, a algorytmy przetwarzania języka naturalnego (NLP) interpretują znaczenie.
Przykłady zastosowań rozpoznawania głosu
Technologia rozpoznawania głosu ma szeroki zakres zastosowań w różnych dziedzinach. Oto kilka kluczowych przypadków użycia:
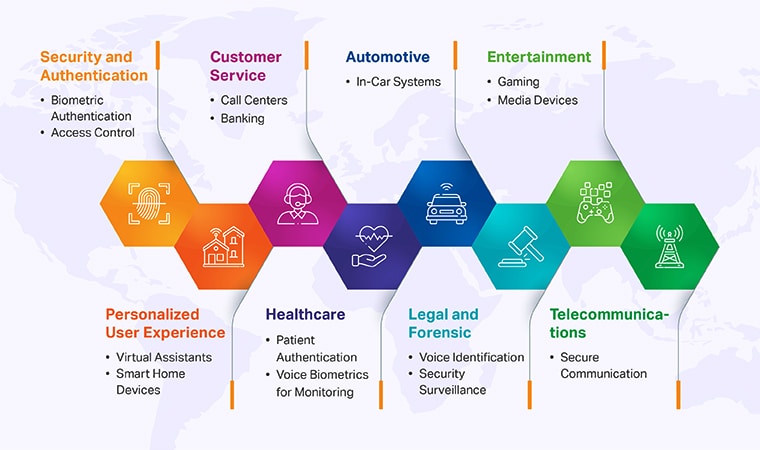
- Bezpieczeństwo i uwierzytelnianie:
- Uwierzytelnianie biometryczne: Używany w smartfonach i innych urządzeniach do odblokowywania ekranów i weryfikacji tożsamości użytkownika.
- Kontrola Dostępu: Zabezpiecza dostęp do budynków, obszarów chronionych i informacji poufnych poprzez rozpoznawanie upoważnionego personelu.
- Produkty do rozpoznawania głosuPrzykłady obejmują inteligentne urządzenia domowe i systemy bezpieczeństwa wykorzystujące rozpoznawanie głosu do sterowania bez użycia rąk i zwiększania bezpieczeństwa.
- Spersonalizowane doświadczenie użytkownika:
- Wirtualni asystenci: dostosowuje odpowiedzi i działania na podstawie głosu użytkownika, zapewniając bardziej spersonalizowaną interakcję.
- Urządzenia inteligentnego domu: Rozpoznaje głosy różnych członków rodziny, aby dostosować ustawienia i preferencje do każdej osoby. Każde z tych urządzeń głośnomówiących jest aktywowane słowem aktywującym — a stworzenie precyzyjnego, dedykowanego dla Twojej marki zestawu wymaga indywidualnego podejścia. dane szkoleniowe dotyczące słów obudzenia.
- Pisanie głosowe:Stosowany jako narzędzie zwiększające produktywność przy wprowadzaniu danych i ich automatyzacji, poprawiające wydajność i dokładność w różnych środowiskach.
- Obsługa klienta:
- Centra telefoniczne: Identyfikuje klientów po głosie, umożliwiając spersonalizowaną obsługę i ograniczając potrzebę powtarzalnej weryfikacji tożsamości.
- Bankowość : Weryfikuje klientów podczas transakcji bankowości telefonicznej w celu zapewnienia bezpiecznej i wydajnej obsługi.
- Oprogramowanie do zamiany mowy na tekst:Zamienia mowę mówioną na tekst pisany, zwiększając wydajność, obsługę klienta i dokładność komunikacji.
- Zdrowie:
- Uwierzytelnianie pacjenta: Potwierdza tożsamość pacjenta w usługach telezdrowia i elektronicznej dokumentacji zdrowotnej.
- Biometria głosu do monitorowania: Monitoruje pacjentów ze schorzeniami takimi jak depresja, analizując zmiany we wzorcach głosu.
- Wirtualna Asystentka Lekarza: Konwertuje mowę lekarza na notatki tekstowe, dzięki czemu może on widzieć i analizować większą liczbę pacjentów w ciągu dnia.
- Aplikacje stron trzecich:Asystenci medyczni i narzędzia opieki zdrowotnej integrują rozpoznawanie głosu w celu zapewnienia większej funkcjonalności.
- Motoryzacja:
- Systemy samochodowe: Rozpoznaje głos kierowcy, aby dostosować preferencje, uzyskać dostęp do nawigacji i sterować systemami informacyjno-rozrywkowymi bez ręcznego wprowadzania danych.
- Tryb głośnomówiący: Odbieraj połączenia telefoniczne, zmieniaj piosenkę, odpowiadaj na wiadomości lub uzyskuj wskazówki bez konieczności odchodzenia od kierownicy; nie tylko zwiększa to bezpieczeństwo na drodze, ale także zapewnia lepsze wrażenia z jazdy.
- Prawne i kryminalistyczne:
- Identyfikacja głosowa: Używany w dochodzeniach prawnych do identyfikacji głośników w nagraniach audio.
- Nadzór bezpieczeństwa: Zwiększa środki bezpieczeństwa poprzez identyfikację osób za pomocą głosu w systemach nadzoru.
- Sprawozdanie sądowe:Zaawansowane rozpoznawanie głosu jest wykorzystywane do dokładnego transkrypcji dokumentów prawnych podczas rozpraw sądowych i zeznań, co zwiększa wydajność i dokładność w porównaniu z tradycyjnymi metodami protokołowania rozpraw sądowych.
- rozrywka:
- Gry: Personalizuje wrażenia z gry, rozpoznając głosy graczy.
- Urządzenia multimedialne: Identyfikuje użytkowników w celu dostosowania rekomendacji treści i profili na urządzeniach do przesyłania strumieniowego.
- Telekomunikacja:
- Bezpieczna komunikacja: Zapewnia bezpieczeństwo kanałów komunikacji poprzez weryfikację tożsamości uczestników poufnych rozmów.
- Interfejsy głosowe:Umożliw naturalne, konwersacyjne interakcje w generatywnej sztucznej inteligencji i inteligentnych urządzeniach, czyniąc doświadczenia użytkowników bardziej intuicyjnymi.
- Wiele urządzeń i urządzeń mobilnychTechnologia rozpoznawania głosu działa bezproblemowo na wielu urządzeniach, w tym urządzeniach mobilnych i telefonach z systemem Android, zwiększając produktywność i komfort użytkowania w podróży.
- Oprogramowanie do rozpoznawania pracy:Nowoczesne oprogramowanie do rozpoznawania mowy obsługuje różne języki, oferuje obsługę wielojęzyczną i zapewnia zgodność z urządzeniami mobilnymi i różnymi platformami do sterowania głosem.
- Praca nad oprogramowaniem do rozpoznawania głosu:Oprogramowanie do rozpoznawania mowy działa na różnych platformach, obsługuje wiele języków i integruje się z aplikacjami innych firm w celu zwiększenia funkcjonalności.
- Wsparcie dla różnych języków:Współczesne systemy rozpoznawania mowy potrafią przełączać się między różnymi językami, dialektami i akcentami, dzięki czemu są uniwersalne i nadają się do użytku na całym świecie.
Przykład technologii rozpoznawania głosu
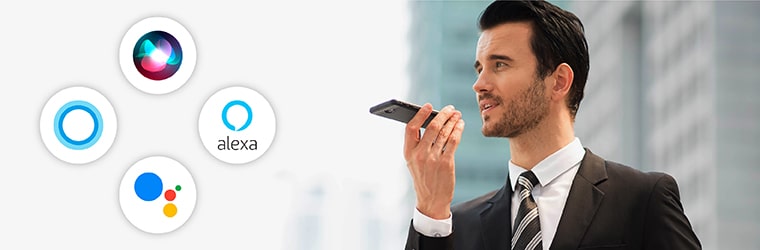
- Apple Siri: Wyobraź sobie, że masz w kieszeni dowcipnego, kompetentnego przyjaciela, zawsze gotowego do pomocy. To dla ciebie Siri. Niezależnie od tego, czy spieszysz się na spotkanie i chcesz wysłać szybką wiadomość, czy też siedzisz po łokcie w cieście na ciasteczka i musisz ustawić minutnik, Siri jest na miejscu, rozpoznaje Twój głos i odpowiada z odrobiną osobowości. To jak mieć osobistego asystenta, który zna cię tak dobrze, że prawie może dokończyć twoje zdania.
- Amazonka Alexa: Wyobraź sobie, jak wchodzisz do domu po długim dniu i mówisz: „Alexa, jestem w domu”. Nagle zaczyna odtwarzać się Twoja ulubiona playlista relaksacyjna, światła przygasają do preferowanego wieczornego ustawienia, a Alexa przypomina Ci o programie, który miałeś zamiar obejrzeć. To tak, jakby Twój dom zapewniał Ci spersonalizowany, pocieszający uścisk za każdym razem, gdy wrócisz.
- Asystent Google: Pomyśl o Asystencie Google jak o swoim wszechwiedzącym kumplu. Niezależnie od tego, czy zastanawiasz się nad pogodą, chcesz rozstrzygnąć przyjacielską debatę, czy chcesz sterować swoim inteligentnym domem, jest tam, rozpoznając Twój głos i dostosowując swoje reakcje specjalnie do Ciebie. To jak mieć superinteligentnego przyjaciela, który zawsze chętnie pomoże i nigdy nie znudzi mu się twoimi pytaniami.
- Nuance Dragon Naturalnie Mówiąc: Wyobraź sobie, że możesz przelać swoje myśli na papier tak szybko, jak potrafisz je wypowiedzieć. Na tym polega magia Dragon NaturallySpeaking. Dla pisarza piszącego kolejny bestseller lub lekarza aktualizującego dokumentację pacjenta jest to jak posiadanie niezwykle wydajnego, nigdy niemęczącego tłumacza, który rozumie każde słowo, akcent i niuans w Twoim głosie. To nie tylko pisanie – to uwalnianie myśli.
- Cortana Microsoftu: Cortana to jak osobisty organizator, który jest zawsze o krok do przodu. Wyobraź sobie siebie w gorączkowy poniedziałkowy poranek, a Cortana wtrąca się: „Sądząc po twoim głosie, wyglądasz na nieco zestresowanego. Czy mam przełożyć mniej pilne spotkania na później w tym tygodniu?” Nie chodzi tylko o zarządzanie harmonogramem; chodzi o posiadanie cyfrowego sojusznika, który rozumie niuanse Twojego głosu i pomaga uczynić Twój dzień płynniejszym.